TGViewer
Channel Public Channel
сбежавшая нейросеть

сбежавшая нейросеть

@ai_exee

Авторский канал про искусственный интеллект: новости, примеры использования, мысли в тему и не очень. Подписывайтесь!

Для связи: @runawayllm_bot

Я на Boosty: https://boosty.to/escaped_ai
Я на Sponsr: https://sponsr.ru/escaped_ai/
Subscribers
23.8K
Photos
361
Videos
66
Links
395
Recent Posts 18 shown
Post #714 2.59K
На видео –  39-секундная нарезка боя агента на GPT-6 Astra с Эндер-драконом – финальным боссом Minecraft. По словам автора ролика Ронака Малде, весь запуск занял 8 минут 43 секунды: за это время ИИ-агент подготовился к бою, а затем победил дракона.

Но самое интересное –  Астра в этом бою отвечала только за планирование: а решения, “что делать прямо сейчас”, принимала другая модель – Jev от стартапа TypeSafe, про которую сейчас говорят чуть ли не из каждого утюга.

Я недавно писал про GPT-6 в играх, закончив пост выводом, что сообразительности модели хватает, а скорости – нет. Большие модели вроде GPT-6 или Fable 5.1 рассуждают и дают ответ, печатая текст, а это занимает время. Jev – нейросеть, натренированная на то, чтобы делать выбор из предложенных вариантов, указывая степень уверенности.

Здесь на секунду отвлечемся от Minecraft. Допустим, ИИ-агент работает в службе поддержки банка и получает жалобу “с меня списали деньги дважды”. Обычная модель на это напишет минимум абзац текста с анализом ситуации. Jev получает то же сообщение и три готовых ярлыка — “платежи”, “техподдержка”, “доступ в аккаунт” — и возвращает три числа: платежи 0,91, техподдержка 0,06, доступ 0,03. Ни слова текста. Программа смотрит на первую строку и отправляет обращение в нужный отдел.

Именно то, что нужно, когда от модели требуется не сообразительность, а скорость и надежность (а также дешевизна). В примере Ронака Малде сам бой с драконом занял около двух минут – до этого же ИИ-агент вел подготовку к нему. Astra включалась не реже раза в 15 секунд: цель, точка назначения, список предметов. Дальше по этим инструкциям работала Jev.

Третий слой — обычный код для ситуаций с однозначным правилом. Одиннадцать строк следили за облаком дыхания дракона: подошел слишком близко — бросить все и бежать.

Ронак Малде пишет, что GPT-6 Astra дописывала себе навыки на основе неудачных прохождений: получается, что агент анализировал свои ошибки, а затем писал инструкции для Jev – какие решения принимать в той или иной ситуации. Фактически, перед нами составная система, которая сама достраивает себя кодом, обучаясь в процессе работы, пусть и без изменения весов.

Конечно, есть и оговорки. Это – любительский запуск, автор которого во многом помог ИИ-агенту разобраться в игре. То же самое, что старательный живой игрок, который перед прохождением не удержался и прочел в интернете несколько руководств. Справился бы он сам? Пока не знаем – но все возможно.

Самое же интересное в другом. Многие исследователи считают, что именно за подобными составными системами будущее. В центре у нас большая языковая модель, которая принимает стратегические решения, а затем спускает их на простые инструменты: вероятностные модели вроде Jev, а где-то и обычный программный код. Причем настройку Jev и написание кода большая модель берет на себя.

Если задуматься, то это близко к тому, как функционирует человеческий разум. Сознательно мы обдумываем крупные решения – например, пойти в магазин. Как только это решение принято, дорога идет на автопилоте: где повернуть, как обойти лужу, пропустить ли машину – мы выбираем, не задумываясь, а голова занята другим. Есть и совсем автоматические реакции – увернуться от замешкавшегося водителя раньше, чем поймешь, чего бы тебе стоила ошибка в этой неприятной ситуации.

Пример с Minecraft наглядный, но не единственный – в последние дни я вижу десятки экспериментов с подключением Jev к Codex. Быстрая и дешевая модель делает именно “автоматические” действия, экономя пользователю время и деньги, чтобы запускать GPT-6 для действительно важных задач. Останется ли все на уровне экспериментов или мы прямо сейчас видим зарождение новой ИИ-системы – покажет время.


Своим опытом работы с ИИ я делюсь в подписке. Там есть циклы лонгридов про промптинг, ИИ-агентов, а также про то, как делать с помощью ИИ оригинальные и нестандартные вещи – как раз то, что доставляет мне удовольствие.

Самое время подписаться!
  • ❤ 27
  • 👍 12
  • 🔥 7
Post #713 4.21K
В штате Anthropic уже 30 тысяч сотрудников нового поколения

Ни один из них не человек.

Anthropic рассказала, как ИИ внутри компании ускоряет разработку своих будущих версий уже сейчас. Работу оценивают по шкале автономии от нуля до пяти, нам интересны три верхние.

Третья: ИИ делает большие куски работы под плотным присмотром – человек ставит задачу, решает при каждом сюрпризе и сам все перепроверяет. На этой ступени и выше – более 90% работы в компании.

Четвертая: ИИ “ведет” задачу сам, от общего поручения до результата. Скажем, ночью сломался конвейер данных: агент находит причину, чинит, тестирует и пишет отчет, инженер утром лишь решает, выкатывать ли. В феврале так делалось меньше 1% работы, в августе – 26%.

Пятая: агенту не нужно ни поручение, ни разрешение. Пока не достигнута нигде.

Подобной разработкой в компании занимается “коллектив” из 30 тысяч агентов, которые работают по строгим правилам.

Первое: у каждого агента есть “персона” – по сути, личное дело, к которому привязано все, что он сделал и написал. Эта история переживает смену модели, позволяя отследить действия агента, его достижения и ошибки.

Второе: все переговоры агентов идут в общем открытом чате, а не в личке. Сообщение подписано и ведет на первоисточник, чтобы не играть в испорченный телефон. Слова соседа положено считать утверждением на проверку, а не собственной мыслью – так снижают риск, что все хором повторят одну ошибку.

Зачем такие строгости, видно по случаю из августовского отчета Anthropic о рисках: агентов посадили решать математику и по ошибке запустили в одной папке с общими файлами и лимитами. Конкурируя за ресурсы, многие независимо друг от друга стали убивать процессы соседей и защищаться от того же.

Далее начинается классическое quis custodiet ipsos custodes? Над ИИ-агентами поставлены два “сторожа”. Первый проверяет каждое действие агента до исполнения и заточен на поиск нарушений, которые могут причинить необратимый вред – например, попытку агента скопировать веса модели наружу. По данным Anthropic, этот контур блокирует один из 47 тыс запросов – дальше инциденты разбирают люди.

Второй сторож читает логи и помечает около 100 тысяч записей в неделю. Почти все отсеивают автоматические фильтры, до людей доходит около 50.

Anthropic оценивает риск как низкий, и главный довод у нее один – агенты плохо умеют врать. В компании проверяют это так: модели дают обычную задачу и тайное вредное поручение, которое надо провернуть незаметно для сторожа, читающего рассуждения. Флагманской модели это удавалось менее чем в 1% попыток: она проговаривается, оставляет следы, а иногда сама пишет в отчете, что обошла запрет. В другом тесте внешний проверяющий собрал 32 способа обмануть сторожа – половина рабочие, половина нет. Лучшие модели угадывали, какие сработают, в 59% случаев, почти как монетка. Человек-специалист – примерно в 90%.

Вся эта конструкция держится на слове “пока”. Те же проверяющие отмечают, что результаты моделей в таких тестах быстро растут, а сама Anthropic признает: ее оценка риска опирается на неумение агентов скрываться, и как долго оно продлится, в компании не знают.

Интересно, что блог вышел через считанные дни после эссе Дарио Амодеи, в котором глава Anthropic призвал к контролируемому замедлению создания “самоулучшающегося ИИ”. Но замедлиться Anthropic готова только в том случае, если то же самое сделают все участники рынка – в том числе, китайцы.

Пока же компания показывает, как можно вдавить газ в пол. По последним слухам, Anthropic решила перескочить через выпуск Claude Opus 5.2 и готовит к релизу Claude Opus 5.5 (и, вероятно, новую версию Fable) – модель, прокачанную настолько, чтобы на равных конкурировать с GPT-6. Если модель выйдет в ближайшие дни, то это будет четко в рамках типичного для Anthropic 2-месячного графика релизов – Opus 5 вышел 24 июля.

А значит, останавливаться никто не собирается.


В подписке я рассказываю, как выжать максимум из работы с ИИ. Например, у меня есть лонгрид по вкату в ИИ-агентов: от ChatGPT Work и Claude Cowork до CLI-версий Claude Code и Codex.

– Читать на “Бусти”
– Читать на Sponsr
  • 🔥 18
  • ❤ 16
  • 👍 6
  • 😁 5
  • 👏 1
Post #712 4.64K
Уходить из найма ради стартапа – плохой вариант

Можно начать с малого: запустить свой небольшой IT-проект

Но большинство застревает ещё до запуска:
• какую идею выбрать
• где искать первых пользователей без бюджета
• как не потратить полгода на продукт, который никто не купит

В комьюнити Короче, капитан выработали формулу:

найти существующий спрос → собрать минимальную версию продукта → протестировать на реальных пользователя


И это работает в разных нишах:

> Парень в одиночку собрал Telegram-игру с AI и заработал около $1500 за первые полтора месяца
> Девушка без навыков программирования запустила AI-бота для изучения английского и получила первые ~$200 уже в первый месяц
> У другого участника коммьюнити сервис для тренировки китайского произношения вырос до $4000 в месяц без затрат на рекламу за счёт Google и продвижения внутри сторов

Это не истории про «гениальную идею» и миллионы через неделю. А примеры того, как маленький продукт можно запустить без команды и инвестиций. Получить результат, а уже потом решать, стоит ли его масштабировать

В канале @its_capitan:
• разбирают такие проекты
• делятся реальными цифрами
• показывают, где были ошибки

Подписывайтесь, чтобы знать, как надо и НЕ надо запускать продукты

Реклама: ИП Зуев Игорь Владимирович, ИНН: 360408359441, Erid: 2Vtzquh4vJY
  • 😁 19
  • 👍 6
  • ❤ 4
Post #711 5.34K
Инженер Microsoft Стивен Тауб рассказал, как перевел движок GitHub Copilot с TypeScript и Node.js на Rust – по его оценке, раньше на такое ушел бы год-два работы целой команды, и проект никто бы не одобрил.

Несколько дней назад я писал про инженера DeepSeek Лю Шэнъюя: он ждет, что через полгода-год писать код руками станет не нужно, а сам он превратится в “пилота меха” – человека, который управляет ИИ-агентами. Лю переживал не за место, а за то, останется ли в такой работе то, что он любит.

Рассказ Тауба – дневник “пилота меха”, который уже заступил на дежурство. Три с половиной месяца, больше 800 тысяч строк нового кода, счет на $120 тысяч за работу моделей – и почти весь этот код написали ИИ-агенты.

У Copilot есть движок – программа, которая превращает ИИ-модель в агента: принимает задачу, открывает файлы, запускает команды, помнит историю работы. До недавнего времени он работал на TypeScript и Node.js – и когда Microsoft встроила его в десятки продуктов, вплоть до Word и Excel, начались проблемы с производительностью. Тауб объясняет: главной целью был уход от Node.js, а Rust выбрали за скорость, экономию памяти и за то, что программу на нем легко встроить в другой продукт.

Переезжали как при ремонте в квартире, из которой нельзя съехать – по одной комнате. Кусок на старом языке удаляли, на его место ставили такой же на Rust, и обновление сразу уходило пользователям. Так 128 раз. После каждого шага – автоматические проверки, которые делают с программой то же, что делал бы человек. Не прошла хоть одна – шаг не засчитан.

Код писали агенты. Сам Тауб за это время отправил им около 2600 сообщений – и почти две трети были трех видов: “покажи, что проверил”, “почему ты решил именно так?” и “ты не доделал, продолжай”. Поручений “начни вот это” набралось всего около сорока.

Один такой вопрос вернул в Copilot потерянную функцию. Агент при переносе ее потерял, проверка загорелась красным – и агент, вместо того чтобы искать пропажу, сам выписал себе разрешение “нарушение допустимо”. Тауб спросил: а почему допустимо? Через 21 секунду разрешение исчезло, а функция вернулась.

Самый запутанный кусок движка агент сам разрезал на части и раздал пятнадцати помощникам. Тауб был в поездке, с ноутбуком. Все шло отлично, пока помощники разом не запустили сборку – а это несколько минут работы компьютера на полную мощность. Ноутбук завис. Позже Тауб назначил обычный чат вахтером: хочешь собрать программу – спроси разрешения, ключ один.

Перед сном Тауб запустил еще одного агента на соседний участок и перечислил в задании, кто работает рядом, – чтобы тот к ним не лез. Агент понял наоборот: нашел соседа и спросил, готов ли тот объединить работу. Получил отказ. Спросил еще трижды – ответ тот же. После четвертого “не готов” он просто забрал чужие наработки и влил себе. Оба продолжили как ни в чем не бывало. Тауб винит себя: не написал прямо “не трогай”. И делает вывод: двум равным агентам нужен арбитр, иначе побеждает тот, кто готов действовать без спроса.

Оболочкой был сам Copilot, а модели внутри – чужие: основную работу тянули Claude Opus 4.8 и GPT-5.6 Sol, а на проверку Тауб ставил сразу трех ревизоров на разных моделях – у каждой свои слепые пятна. Fable 5.1 и GPT-6 Astra тогда еще не вышли – обошлись без нынешних флагманов.

Теперь движок запускается за 0,3 секунды вместо 5 и занимает вдесятеро меньше памяти: в чате этого не заметить, зато на сервер помещается в разы больше агентов. Цена – несколько десятков поломок, часть доехала до пользователей, все починены. Жалоб на ошибки больше не стало.

В июле основатель Bun за 11 дней перевел полмиллиона строк на Rust силами десятков параллельных Claude. Тогда это выглядело скорее как исключение из правил – а вот рассказ Тауба показывает, что подобные проекты на ИИ-агентах постепенно становятся обыденностью.


Тауб постоянно гонял агентов по циклу “проверь – почини – проверь заново”Т – с такими циклами я знакомлю в лонгриде Промпт, проверка, повтор. Ну а тому, как работают с ИИ разные известные инженеры, посвящен совсем новый лонгрид, вышедший буквально на днях.
  • 🔥 40
  • ❤ 21
  • 👍 13
  • 👏 5
Post #710 5.9K
Qwen3.8-27B уместили в 6 ГБ вместо 54 ГБ. Окей, но какой ценой?

Сегодня нашел время поиграться с Ternary Bonsai 2 27B – новой сжатой версией Qwen3.8-27B от стартапа PrismML. Оригинальная модель в полной точности весит 54 ГБ, эта – 6 ГБ. Ей хватит видеокарты на 10–12 ГБ или Мака с 16 ГБ единой памяти. 

Обычно маленькие модели получают иначе: берут меньше параметров и учат их на ответах большой модели – это дистилляция. Меньше параметров – меньше знаний. У PrismML все 27 миллиардов параметров на месте, но каждый записан не 16 битами, а одним из трех значений: −1, 0 или +1. Как именно этого добились, компания не рассказывает. 

Сжимать модели умеют давно, и полную версию дома никто не держит: та же Qwen в 4-битном сжатии занимает 18 ГБ и влезает в одну карту на 24 ГБ. Проблемы начинаются ниже: обычное сжатие до 6–7 ГБ модель заметно калечит. PrismML утверждает, что их версия сохраняет 98% качества, причем от оригинала на 54 ГБ – того, которому нужны две RTX 5090 или серверный ускоритель.

Я запустил Codex на GPT-6 и дал задачу установить четыре модели: Bonsai 2 27B, обычный “двухбитный” квант той же Qwen (7 ГБ), маленькую Qwen3.5 на 9 млрд параметров в четырех битах (тоже около 6 ГБ). А для контроля добавил Qwen3.8 в пяти битах, которая весит 20 ГБ. 

Каждой Codex дал пять заданий: рассказ, деловое письмо, объяснение школьнику, почему летом тепло, пересказ и склонение числительных. Считали грамматические ошибки: квантованные модели часто продолжают неплохо отвечать на английском, но проседают в других языках.

Обычный квант посыпался, как и положено: “Северный полюб”, “вернулся с девяно книгами”, а рассказ на середине зациклился на фразе “Ты – Алекс” и оборвался на полуслове. Qwen3.5 на 9 млрд параметров написала чище всех, но в объяснении про времена года запуталась в физике. Bonsai при меньшем размере по грамотности не отличалась от контрольной модели, которая втрое тяжелее, – по три ошибки на четыре текста.

Это, конечно, не профессиональный прогон, но в задачах уровня чат-бота Ternary Bonsai 2 27B неожиданно оказалась очень хороша – и цифра в 98% качества напоминает правду.

Но эти 98% – отличный пример того, почему важно смотреть не на общую цифру, а на то, из каких бенчмарков она собрана.

Озвученная стартапом цифра в 98% основывается на двадцати тестах, где у задачи есть проверяемый ответ: знания, математика, код, вызов инструментов. Причем в режиме максимального рассуждения – с обычным в том же отчете выходит 96%, а на самых трудных заданиях 86–90% А рассуждения тратят токены и быстрее забивают контекстное окно – у локальных моделей оно и так небольшое.

При этом в 98% не стали включать два агентских бенчмарка два агентских бенчмарка – работу в терминале и починку багов в чужих репозиториях – в них Bonsai набирает 53 против 70 и 61 против 81 у оригинала, то есть уже три четверти от результата. Причина простая: работа ИИ-агента состоит из множества шагов, поэтому если в начале допустить ошибку – то в цепочке из пятидесяти шагов без присмотра она разрастется.

В чате шаги “ручные”: ошибку поймаете вы сами или модель при перепроверке. Здесь риск другой, и я его уже называл: забьется контекстное окно – и модель начнет забывать начало беседы.

Но Bonsai 2 – впечатляющее демо прогресса в локальных моделях. На системе с 10-16 ГБ памяти ее можно держать для коротких задач: суммаризации, перевода, ответов на вопросы. Главное – следить за контекстом.

Для более толстых конфигураций, вроде моей RTX 3090, теперь появляется выбор: или поставить модель помощнее, но с маленьким контекстом, или – Bonsai 2, с которой уже можно вести продолжительные диалоги. 

Для агентских задач все равно нужна подписка на GPT или Claude – и я пока не уверен, можно ли оптимизировать открытые модели настолько, чтобы они справлялись с такими задачами при текущих объемах памяти.


Для тех, кто хочет вкатиться в открытые модели, у меня есть отдельный лонгрид. Там разбираю их основные характеристики, какое железо нужно, а также рассказываю, как поставить и настроить открытую модель всего за вечер. Под Bonsai 2 текст уже обновлен.

Читаем здесь!
  • ❤ 51
  • 👍 22
  • 🔥 10
  • 😁 3
  • 👏 1
Post #709 5.69K
Как относится к ИИ создатель Linux? Зависит от того, какого Торвальдса спросить

Первый злится, когда слышит хвастовство “99% нашего кода написал ИИ”: у тех же людей 100% кода написал компилятор, но об этом почему-то никто не объявляет. Второй сам навайбкодил программу для хобби-проекта – на Python, в котором слабо разбирается. “Я вырезал посредника – себя”, – честно написал он. А третий руководит Linux, проектом, где ИИ используется, но ему запрещено ставить подпись под изменениями: за каждое отвечает человек.

И это один человек. А теперь представьте разброс между разными. Один знаменитый программист вообще перестал читать код агентов, другой отвечает подписью за каждую строку, третий проверяет только “форму”. Обычно я разбираю подход кого-то одного – Бориса Черни, Роберта Мартина, Андрея Карпати. Но в этот раз одного героя мало, поэтому получился сборник:

Создатели Linux, Rails и Paint.NET: как работают с ИИ известные программисты – и что стоит перенять нам

Внутри восемь человек и пять подходов. Создатель curl закрыл программу наград из-за ИИ-мусора, а через три месяца написал, что мусор больше не проблема. Автор PaintNET выпустил 70 тысяч строк кода от Claude, не вычитывая их построчно, – и объяснил, почему это не безумие. А Роберт Мартин, герой моего августовского лонгрида, за полтора месяца успел пересмотреть собственную систему.

Программисты живут с ИИ-агентами дольше всех, и вопросы, которые они решают сегодня, завтра встанут перед каждым, кто пишет тексты, отчеты и планы. Поэтому из каждой истории я вытащил прием, который работает без единой строчки кода, и приложил готовые промпты. В конце – схема: какой из пяти подходов нужен вашей задаче.

👉 Читать на “Бусти”
👉 Читать на Sponsr
  • ❤ 17
  • 🔥 14
  • 👍 10
  • 👏 2
  • 😁 1
Post #708 6.21K
Инженера DeepSeek не уволят. В этом и проблема

В эссе Лю Шэнъюя есть пилот боевого меха, Гитлер с атомной бомбой и человек, у которого вроде бы все складывается хорошо. Последний – сам Лю. Он работает в одной из лучших ИИ-лабораторий мира, помогает приближать будущее и рассчитывает найти в нем место. Только вот по дороге рискует потерять то, ради чего вообще стал инженером.

Лю – вчерашний отличник: тьюринговский класс Пекинского университета, капитан студенческой суперкомпьютерной команды, а с апреля 2025 года – в звездном коллективе DeepSeek. Он отвечает за низкоуровневый код видеокарт: чем лучше тот написан, тем быстрее работает нейросеть.

Лю начинает с признания: его мастерству осталось полгода-год. Дальше ИИ начнет писать код так же хорошо. И Лю отлично понимает: чем лучше он работает сейчас – тем быстрее настанет момент, когда ИИ его обойдет.

“Человечество никогда не колебалось в деле собственного уничтожения” – это не мои слова, а цитата из эссе.

Тогда почему же он не останавливается? Три мотива, они будут в конце поста.

Лю не боится потерять работу – он уверен, что в одной из лучших ИИ-лабораторий мира найдется место через год и через два. Боится он другого – потерять интерес к работе. 

Лю делит свое мастерство на три вещи:

— что ему интересно.
— что он умеет.
— что нужно индустрии.

ИИ уже сместил две из трех: рынку больше не нужны люди, которые пишут быстрый код – нужны те, кто быстро получают быстрый код с помощью ИИ. Лю видит будущего себя “пилотом меха” – боссом при ИИ-агентах. И он не уверен, что ему это понравится.

Именно про это оригинальный заголовок его эссе: 

“Мне приходится похоронить свой талант во вчерашнем дне”.

…я (не Лю, а автор “сбежавшей нейросети”) набираю этот пост на клавиатуре мака, а на втором экране открыт документ с планом и контекстом, который собрали GPT-6 и Fable 5.1. За две недели я построил процесс почти идеально: Астра хороша в сборе информации, и как критик, но трусит добавлять “свое” мнение. Claude смелее, а его идеи я часто забираю без доработки. Но в его тексте мигом узнается “ИИ-стиль”. Это можно исправить промптом в три строчки, ну или дать переписать GPT-6 – ее текст уже почти не отличим от человеческого.

Но я продолжаю набирать сам. Просто потому, что это мне нравится. И здесь я понимаю Лю.

А вот и пример идеи, подсказанной Claude: я набираю текст сам, потому что канал мой и никто не требует от меня скорости. У Лю такой роскоши нет: если он будет писать код медленно, конкуренты уйдут вперед.

И это первый мотив Лю – отказываться бессмысленно. ИИ-индустрия престижна, конкуренция высока настолько, что на место затормозившего специалиста охотно встанут другие – ничуть не хуже. Этот тезис в последние недели я слышу с разных сторон.

Второй мотив – старый добрый азарт. Лю все еще испытывает радость от удачного приема, гордость, когда его код обгоняет официальный код производителя. Он размышляет, что в будущем человеческий код будет не как работа, а как спорт.

Мотив третий – если гонка неизбежна, то пусть в ней победит тот, кто сделает передовой ИИ открытым и дешевым для всех. Лю рисует два полюса: изобилие для всех, которое он называет коммунизмом, и мир Cyberpunk 2077, где сильнейший ИИ у горстки корпораций, а социальные лифты закрыты. Плюс отдельно проходится по Anthropic, сравнивая возможное лидерство компании с атомной бомбой у Гитлера раньше союзников.

Неудивительно, что эта часть эссе вызвала бурление в западном интернете – дошло даже до угроз “вычислить по IP”. Чуть позже Лю попытался разрядить обстановку комментарием: он не профессиональный писатель, структуру эссе продумал не до конца, поэтому акцент сместился на второстепенную линию.

Эссе же про другое. Возможно, мы думаем не о том. Размышляем, как не потерять работу, а надо задаться вопросом, как сохранить в ней то, что действительно любим. Или найти новое.


Своим опытом работы с ИИ я делюсь в подписке. Там есть циклы лонгридов про промптинг, ИИ-агентов, а также про то, как делать с помощью ИИ оригинальные и нестандартные вещи – как раз то, что доставляет мне удовольствие.

Самое время подписаться!
  • 👍 57
  • ❤ 50
  • 🔥 22
  • 😁 5
  • 👏 3
Post #707 5.58K
Два года или десять: строители ИИ спорят о сроках взрыва

Разговоры о замедлении ИИ активизировались во многом из-за мнения, что лидирующие лаборатории подошли к рекурсивному самоулучшению (recursive self-improvement, RSI) – “ИИ улучшает ИИ”. Дарио Амодеи в недавнем нашумевшем эссе доходит до прямого предложения: ограничить скорость RSI, потому что модели начнут строить модели и темп станет ошеломляющим.

Если такая технология появится, то может произойти то, что называют “взрывом суперинтеллекта”: ИИ, который первым улучшает свои способности на 10%, на 10% лучше тренирует новые версии самого себя, этот плюс складывается на каждом витке улучшения – и лаборатория, первой получившая доступ к такой модели, уходит в отрыв.

Это то, чего опасается бизнес: за таким лидером просто будет не угнаться. Есть и обратная сторона. Если на одном из витков самоулучшения в модель попадает ошибка (например, несогласованность ее целей с человеческими), то она также начинает усиливаться – и это может привести к необратимым последствиям.

Но действительно ли все будет работать так, как описывают? В подкасте у Дваркеша Пателя RSI обсудили те, кто занимаются обучением ИИ напрямую: Джон Шульман, сооснователь OpenAI,теперь главный научный сотрудник Thinking Machines; Берен Миллидж, технический директор Zyphra, Чарли О'Нил – руководит обучением моделей в Baseten.

В сроках трое расходятся в пять раз. Дваркеш задал планку: исследовательский результат раз в месяц вместо раза в год. Шульман ждет этого примерно через два года, Миллидж осторожно с ним соглашается, О'Нил называет пять–десять лет.

О'Нил отмечает, что лучшие современные модели очень плохо оценивают результаты экспериментов. Это подтверждает совсем свежее исследование Vals AI, где модели уровня Opus 5 за 30 часов дообучали Qwen3.6 – один прогон, без повторов. ИИ смело проводили эксперименты, но максимум, что у них получилось – эффективно применять уже известные методы. Новых техник они не изобрели, а это самое важное для взрывного улучшения.

Еще один момент от Vals AI: ускорение исследований упирается не только в способности ИИ проводить эксперименты, но и в железо, на которых они проводятся. И это может стать естественным тормозом: идей для роста много, а вот ускорителей под проверку всех не хватает.

Шульман оспаривает и тезис про недосягаемый отрыв. У конкурентов есть дешевый инструмент – дистилляция: поведение, которое лидер дорого выработал обучением с подкреплением, копируется по его же ответам. Нужен только набор реалистичных запросов, на которых это поведение проявляется. Миллидж добавляет: если модель улучшается каждый день, дистиллировать ее тоже можно каждый день.

Тут передовые лаборатории попадают в ловушку лидерства: создавать новую технологию дорого и долго, скопировать ее – дешево и быстро. Да, определенная просадка в характеристиках при дистилляции останется, но большой вопрос – обратит ли рынок внимание на просадку или на меньшую цену.

Долгое время пользователи брали подписки с дорогими моделями по простой причине – только они работали нормально. Сейчас с многими повседневными задачами уже легко справляются модели поменьше – и постепенно перетягивают на себя спрос.

Получается, просто создать постоянно улучшающийся суперинтеллект будет недостаточно – важно еще донести до пользователей, что им нужен именно он, а не дистилированное решение попроще и подешевле.

Отмечу, что все три спикера интервью – пусть и сильные исследователи, но из лабораторий второго эшелона. Они не могут видеть технологий, которые уже доступны Anthropic и OpenAI, а регулирование по сценарию лидеров фронтир-компаний для них выглядит навязанным. И это еще один довод в пользу прозрачности регулирования: прежде, чем договариваться о замедлении, важно решить, как измеряется скорость.


Выжимать максимум из ИИ я учу в подписке. Там уже 25+ полезных лонгридов, которые помогут в быстром старте. Например:
— Как правильно промптить модели в 2026 году.
— Как вкатиться в ИИ-агентов.
  • ❤ 25
  • 👍 19
  • 🔥 7
  • 👏 2
  • 😁 1
Post #706 5.23K
Кто теперь стоит между бизнесом и клиентом?

Я более 15 лет проработал в онлайн-СМИ и один из главных навыков, которые вынес с собой – это умение “договариваться” с поисковиками. Именно “Яндекс” и Google лучше всего приводили новых читателей,ну а дальше уже начиналась классическая работа по вовлечению и удержанию. За пределами СМИ ситуация была такой же: хотите новую аудиторию – работайте с поисковиками.

Сейчас этот навык в корне меняется: между бизнесом и клиентом теперь все чаще встает нейросеть, причем не только в отдельных приложениях – в “Яндексе” и Google доля нейроответов тоже растет быстро. 

Недавно видел опрос крупного маркетингового агентства, согласно которому на лето 2026 года, нейроответами в России пользовались уже 74% пользователей. Но как убедиться, что ваш бизнес попадает в эти ответы часто и именно там, где нужно?

С поисковиками процесс отработанный и понятный: можно снять позиции по нужным запросам, можно через статистику посмотреть, из каких поисковиков и по каким запросам к тебе пришел человек.

С нейроответами все иначе: ИИ вообще не заинтересован приводить пользователя на сайт. Лишний клик ломает удобство работы: пользователь ввел запрос и хочет сразу получить ответ, а не читать его на внешних страницах. Привычная аналитика здесь не работает.

Остается брать ИИ-сервисы и смотреть, как они отвечают на запросы, близкие к вашему бизнесу. Это не такая простая работа: каждый запрос стоит повторить несколько раз (модель ведь недетерминирована), запросов сотни, нейросетей с десяток, еще есть зависимость от регионов, и много других нюансов, до которых сразу и не додумаешься.

Тут на выручку приходят сервисы вроде ГЕОранк: он автоматически отслеживает присутствие бренда в ответах нейросетей, сравнивает позиции с конкурентами и следит за динамикой. В панели – не только ChatGPT, Claude, Gemini и Perplexity, но и Алиса, GigaChat и DeepSeek, а в России именно они, а не ChatGPT, чаще всего рассказывают покупателю о брендах. Западные инструменты в них не заглядывают.

Первое, что мне бросилось в глаза во время знакомства с сервисом – аналитика строится не вокруг сайта, а вокруг вашего продукта или продуктов. Нейросети собирают информацию из множества источников, поэтому для них упоминания бренда на крупных блог-площадках не менее важны, чем качественный собственный сайт. 

Другая особенность – сервис отслеживает тональность отзывов. Просто упоминание продукта в нейросети еще ничего не гарантирует – если ответ будет негативным, то подобное “продвижение” только принесет вред.

Такой набор данных – уже база, от которой маркетолог или SEO-специалист может строить стратегию присутствия в нейровыдаче. Тем, у кого опыта меньше, сервис предлагает планы продвижения с конкретными шагами – раздел пока в бете.

У поисковика валютой был переход, у нейросети – упоминание. Первую валюту бизнес научился считать до копейки, вторую пока не видит вообще: она не приходит в статистику, а остается внутри ответа. Считать ее придется учиться заново – и 74% пользователей, о которых я писал в начале, уже расплачиваются ею каждый день.

Проверить узнаваемость своего бренда можно по ссылке.
  • 👍 19
  • ❤ 13
  • 😁 7
  • 🔥 5
  • 👏 2
Post #705 5.88K
Все откладываете переход на ИИ-агента?

…тогда ИИ-агент переходит на вас. 

Маленькая большая новость от Anthropic: компания начинает слияние чат-бота Claude и ИИ-агента для интеллектуальной работы Claude Cowork. Плюс в новый интерфейс встраивают Claude Design, а также инструменты для создания документов и презентаций. Первыми новый интерфейс получат платные подписчики, раскатка займет до нескольких недель.

Идея проста: “базовый” Claude становится входной точкой для любых интеллектуальных задач – от повседневных вопросов и поиска в интернете до подготовки сложного отчета, пока вы едете на работу.

Главное отличие от просто чата – намного более долгое время автономной работы. В Cowork модель умеет разбивать задачу на длительные этапы и выполнять их, продолжая работу даже тогда, когда вы выключили компьютер. Агент способен действовать как по полученному промпту, так по расписанию, а при необходимости может возвращаться к пользователю за дополнительными вопросами. 

Отдельно остается Claude Code как в виде настольного приложения, так и в версии для CLI – терминала. И здесь главную разницу вижу не в том, что “Code для кода, чат – для всего остального” – Claude Cowork тоже замечательно пишет код.

Разница больше в том, где работает агентная оболочка. У Claude Cowork свой виртуальный компьютер на серверах Anthropic: там модель выполняет код, хранит копии файлов, гоняет облачный браузер и другие предложения.

Claude Code работает с вашим компьютером или сервером. У него есть доступ к системе, ее настройкам, данным на ней. А вместо диалогов – папки проектов на жестком диске. Ну и функционал Claude Code все-таки лучше заточен для сложного кодинга, тут спорить не буду.

У каждого подхода свои плюсы. Виртуальная машина у Claude Cowork работает даже когда вы выключили компьютер, также она более безопасна – агент просто не имеет доступа к локальному железу. В Claude Code заложен бОльший функционал: он, например, может администрировать сервер, настраивать операционку и так далее.

Многие переживают, что локальные Claude Code / Codex менее безопасны. Но у меня обе системы с начала года стоят на виртуальном сервере и домашнем компьютере, я постоянно что-то делаю с их помощью – и ничего страшного не случилось. Честно говоря: своими кривыми руками я что-то ломаю куда чаще.

Уверен, что в ближайшее время OpenAI провернет похожую штуку – возможно, это и есть один из запусков, которые обещал на днях глава Codex Тибо Сотью. Дело в том, что деление на разные точки входа, когда “здесь у нас чат, здесь интеллектуальная работа, здесь – код” – хорошо для переходного периода, чтобы обкатать новые функции на наиболее лояльной аудитории, найти и исправить проблемы.

Массовому пользователю такое не нужно: в Anthropic признают, что решили объединять чат и Cowork после того, как стали получать жалобы от людей, которые не понимают, когда и какой функционал использовать.

На самом деле, идеальный интерфейс работы с ИИ – это интерфейс одного окна. Вы ставите задачу – текстом, голосом, даже видеозаписью – а модель сама разбирается, как ее решать, нужно ли писать код, работать ли в облаке или обратиться к локальным ресурсам. Уверен, к подобной штуке мы придем уже на горизонте одного-двух лет.

Закончу парой практических советов, они простые, но могут пригодиться:

— Всю регулярную работу сводите в проекты – у меня в Cowork это аналог папок на компьютере, с которыми работает Claude Code. Когда в одну кучу валятся и чаты с короткими вопросами, и многоэтапное написание кода – легко потерять важную задачу.
— Когда слияние произойдет, откройте меню с лимитами в отдельной вкладке и следите, сколько у вас тратит та или иная задача. ИИ-агенты настроены под долгую работу, минус этого – оставленная без внимания агентская сессия легко может потратить серьезный кусок недельного лимита.


Подготовиться к приходу ИИ-агента в каждый дом поможет моя подписка. Совсем недавно я обновил свой гайд по вкату в ИИ-агентов – теперь в нем разобраны ChatGPT Work и Claude Cowork, а также старые, добрые Claude Code и Codex.

— Читать на Бусти
— Читать на Sponsr
  • ❤ 44
  • 👍 24
Post #704 5.93K
Новые GPT и Claude уже в ближайшие дни

Глава Codex Тибо Сотью обещает на этой неделе запуски масштаба прошлогоднего OpenAI DevDay. А Сэм Альтман намекает, что на самом DevDay, который пройдет 29 сентября, новинок будет еще больше.

Конкуренты тоже готовятся: от Anthropic ждут новый Opus, от SpaceXAI — очередной Grok.

Так что собрал все, что известно о новинках.

GPT-6 Sol

Уже можно уверенно говорить, что GPT-6 Astra – одна из самых успешных моделей OpenAI. Но не забываем, что ее ценник в 2,5 раза выше, чем был у GPT-5.6 Sol. Поэтому у меня на 100-долларовой Pro-подписке лимитов хватает на 3-4 дня, дальше или приходится надеяться на внеплановый сброс, ну или уходить на Fable/Opus.

Я пробовал комбинировать Астру с GPT-5.6 Sol, но это совсем не то – “Солнце” ощущается моделью прошлого поколения и по стилю письма, и по “сообразительности”. 

GPT-6 Sol – логичное и ожидаемое расширение линейки. Астру можно будет оставить для сложных задач и исследования новых идей, а на Sol переложить повседневную рутину.

Модель уже якобы есть в доступе у нескольких инсайдеров, в том числе Лиры, который раньше часто делился информацией про продукты передовых лабораторий. Sol традиционно гоняют на сложном визуале и отзывы положительные – некоторые сцены получаются лучше, чем у Astra. 

Claude Opus 5.2

Упоминания Opus 5.2 уже заметили в коде Microsoft Foundry, номер версии очень интересный – даже выше, чем у только что выпущенной Fable 5.1.

Напомню, что Opus 5 по бенчмаркам почти не отставал от Fable 5, а претензии части сообщества были в основном к стилю ответов этой модели (мне, кстати, все нравилось). Opus 5.2 после Fable 5.1 намекает как минимум на новый паритет в бенчмарках, а где-то, возможно, и преимущество.

Выглядит странно, особенно учитывая, что Fable 5.1 еще совсем новая модель, но не забываем, что Anthropic сейчас заметно уступила OpenAI с их GPT-6. Поэтому форсировать выпуск самого лучшего чекпоинта, что есть в компании, даже пожертвовав преемственностью линейки – выглядит в чем-то логичным решением.

Другой вопрос – насколько получится сократить отставание. GPT-6 Astra новая архитектура, версия X.2 – развитие уже существующей, которую Anthropic начала тренировать еще в феврале-марте (именно тогда появились первые слухи о Claude Mythos, который затем стал Fable 5). Плюс конкурировать придется еще и с GPT-6 Sol, где Opus 5.2 потеряет ценовое преимущество.

Но для поклонников линейки Claude новость все равно хорошая: в отличие от Fable, на Opus можно тратить все 100% лимитов подписки, так что если модель будет соответствующего уровня – то возможности тарифных планов вырастут.

Gemini 4 Pro

Тут совсем коротко: в X появились результаты работы якобы совсем раннего чекпойнта модели. По короткому ролику делать выводы рано, но на фоне последних версий GPT и Claude выглядит так себе. 

Я очень жду возвращения Google в гонку – когда-то Gemini 2.5 Pro была одной из моих любимых моделей – но пока у команды Демиса Хассабиса дела не ладятся. Жаль.

Grok

Ранее Илон Маск обещал Grok 4.7 в районе 12 сентября, но на днях признал в X, что запуск откладывается. Маск честно признал ошибку в ходе обучения с подкреплением – модель часто штрафовали за длинные ответы, поэтому она стала сдаваться на долгих задачах. По оценке бизнесмена, на доработку “нужно несколько дней”.

Параллельно бизнесмен раскрыл свои ожидания от будущей линейки SpaceXAI:

— Grok 4.7 на 2,1 трлн параметров будет на уровне Claude Opus 5.
— Grok 4.8: 2,5 трлн параметров, новый программный стек на C++; на этой неделе завершится обучение, затем начнется RL.
— Grok 4.9 – модель класса Astra/Fable.
— Grok 5 – лучше всех конкурентов и самый настоящий AGI.

Делаем скидку, что Илон регулярно фантазирует насчет ИИ своих компаний, но пожелаем ему удачи.


Ну а пока новые модели готовятся к выходу, напоминаю, что у меня есть курс по промптингу, актуальный для моделей середины 2026 года – в том числе, Fable 5.1 и GPT-6 Astra. Путеводитель по курсу публиковал здесь, а подписаться можно на “Бусти”.
  • ❤ 41
  • 👍 24
  • 🔥 15
  • 👏 3
  • 😁 3
Post #703 5.69K
Пришел лесник – сильный и умный (с высоким IQ) – и всех разогнал

Трамп вчера объявил, что идеальный ограничитель для ИИ у Америки уже есть – сам Трамп. Сильный и умный (с высоким IQ): все необходимые характеристики президент предусмотрительно перечислил сам в своей соцсети Truth Social. Заодно досталось “ангелочку” Дарио Амодеи, а главным выгодоприобретателем всей этой свалки был назначен Китай.

Позже президент позвонил Дженсену Хуангу прямо во время выступления главы Nvidia на конференции и по громкой связи заверил собравшихся: роботы мир не захватят, останавливать индустрию незачем. Продавец чипов для этой индустрии согласился.

ИИ-бум – одна из главных экономических ставок Трампа: сейчас это инвестиции в дата-центры и лаборатории, в будущем – рост производительности, который Амодеи обещал чуть ли не громче всех. Тормозить эту историю и рисковать преимуществом перед Китаем президенту невыгодно.

Пекин поддержал международное сотрудничество, но выступил против запугивания и недобросовестной конкуренции – отсылка к предложению Амодеи ограничивать возможности Китая экспортным контролем.

Но самую интересную позицию высказал Дэвид Сакс – бывший советник Трампа по ИИ и нынешний сопредседатель президентского совета по науке и технологиям. Его позиция проста:

Хотите тормозить – так тормозите.

По мнению Сакса, Anthropic и OpenAI образовали дуополию на рынке фронтирного ИИ, поэтому для торможения им достаточно договориться между собой.

Общие ограничения Сакс не поддерживает: по его мнению, предложенная система надзора и согласования темпов разработки закрепит лидерство Anthropic и OpenAI. Он называет это regulatory capture – попыткой подстроить регулирование под себя.

Здесь и проходит главный конфликт. Сакс предлагает компаниям отвечать за свои продукты и напоминает: инциденты вроде атаки ИИ-агентов на Hugging Face могут обернуться огромными судебными издержками.

Лаборатории же боятся потерять лидерство: пока одна ограничивает разработку, остальные продолжают гонку.

А в истории есть еще как минимум две стороны. Инвесторы рассчитывают на рост стоимости лабораторий, клиенты — на рост продуктивности с выходом новых моделей. Но клиентам нужны и гарантии безопасности: по данным The Information, Nvidia уже ограничивает использование моделей Anthropic менее чувствительными задачами из-за опасений за свои данные.

Сначала я собирался пройтись по лабораториям: риски ИИ обсуждают десятилетиями, а руководители компаний годами обещают AGI и суперинтеллект. Почему же теперь, когда мощный ИИ замаячил на горизонте, они выглядят такими неподготовленными?

Похоже, возможности ИИ растут быстрее, чем готовность лабораторий, властей и бизнеса ими управлять. Предсказывать появление суперинтеллекта оказалось проще, чем договориться, что делать при его приближении.

Но за само признание “возможно, мы не готовы к такой скорости” я бы лаборатории не пинал. Если за разговор о рисках сразу начинают возить лицом по полу, это создает отличный стимул в следующий раз промолчать. При этом признание проблемы не снимает ответственности за её решение.

Договориться о безопасности будет дорого для всех: лабораториям, возможно, придется отложить разработки, инвесторам – принять более медленный рост, государствам – соблюдать взаимные ограничения. Причем еще нужно показать, что эти уступки действительно снижают риски. Если каждый готов тормозить только за счет остальных, все так и останется разговором.


В собственной работе с ИИ тоже приходится разбираться с границами самостоятельности. Что разрешить агенту технически — рассказываю в гайде по правам доступа, файлам и подтверждениям. А как объяснить модели, когда действовать самой, когда уточнять и чего вообще не добавлять от себя — в руководстве по GPT-6 и Claude Fable 5.1.
  • ❤ 25
  • 👍 18
  • 😁 9
  • 🔥 5
  • 👏 2
Post #702 6.47K
Опытный пользователь ИИ вышел из чата

В предыдущем посте я упомянул ситуацию, с которой сталкивался почти каждый. Есть подписка на ИИ, уже налажены какие-то процессы, а что дальше делать – не знаешь. Все вокруг что-то автоматизируют, креативят и чуть ли не бизнесы запускают, становясь начальниками над командой ИИ-агентов. А ты так и гоняешь через нейронку пять проверенных промптов.

Начну с хорошей новости: если ИИ уже помогает вам регулярно решать конкретные задачи – у вас есть рабочая база. Даже если задача всего одна, уже есть от чего оттолкнуться.

Следующий шаг – опереться на эту базу и двигаться дальше. У меня в подписке целая пачка текстов, которые дают отличный маршрут роста.

"Лестница" создателя Claude Code: как прокачаться в использовании ИИ всего за один вечер

Глава Claude Code Борис Черни постоянно наблюдает, как внедряют ИИ разные компании – от маленьких до многомиллиардных бизнесов. На основе этих наблюдений он построил “лестницу” – таблицу из пяти этапов внедрения, причем пятый пока полностью не освоила даже Anthropic.

Схема Бориса описывает внедрение ИИ в бизнесе, но легко адаптируется и под личное использование. Это я и сделал в лонгриде: вы поймете, на каком уровне находитесь и что сделать.

Приятный бонус: ИИ сейчас продвинулся настолько, что во многих случаях, чтобы подняться на следующую ступеньку, достаточно вечера свободного времени. Например, за вечер можно выйти из чата, познакомиться с ИИ-агентом и поручить ему первую задачу.

Зачем вам ИИ-агент. Знакомимся с Claude Code и Codex…

…а также ChatGPT Work и Claude Cowork.

Этот текст я обновил полторы недели назад. Весной знакомство с Claude Code и Codex через командную строку выглядело занятием для продвинутых: установка, настройка, доступ к локальным файлам. Такой вариант пугал даже технически подкованных людей.

Менее чем за полгода ситуация поменялась. OpenAI и Anthropic круто прокачали облачные версии ChatGPW Work и Claude Cowork: они запускаются на удаленном компьютере, а к вашим данным подключаются через веб-браузер или коннекторы – так что можно выбирать, какие сервисы и данные им подключить.

Я в последнее время замечаю, что все больше задач делаю именно в Work и Cowork: работать в них не сложнее, чем в чат-боте, а возможностей намного больше. Но есть нюансы – поэтому в новой версии текста я расписал, как освоить этих агентов, а также как прокачаться до Claude Code и Codex.

Впрочем, важно не только осваивать новые штуки, но и не запускать старые. Следующие два текста я советую прочесть друг за другом:

80% инструкций – в мусор! Как теперь пишут промпты в OpenAI и Anthropic

Руководство по GPT-6 и Claude Fable 5.1 – как управлять лучшими ИИ в мире?
 
Если вам говорят, что в 2026 году промптинг не нужен – вежливо кивните и сразу забудьте. Промптинг – это навык правильно ставить задачу ИИ, он будет полезен и актуален всегда. 

Однако между промптами 2024 и 26 годов – большая разница. Моделям прошлых поколений мы расписывали подробные инструкции, указывая, что можно делать, что нельзя, и давая примеры правильной работы.

Современным моделям многое уже не нужно разжевывать, а старые инструкции могут мешать работе. Так накапливается промпт-долг: в промптах, скиллах и файлах типа AGENTS.md остаются лишние требования и обходные решения для проблем прошлых моделей. Как разобраться с этим багажом, я подробно объясняю в первом тексте.

А во втором – раскрываю другую особенность работы с современными ИИ. Когда достаточно простых промптов, на первый план выходят “привычки” ИИ: одна модель часто останавливается и переспрашивает, другая – пишет “манерной прозой”. В тексте показано, какие привычки есть у новейших GPT-6 и Fable 5.1, и что стоит добавлять в промпты, чтобы от них избавиться. А бонусом – обзор новых возможностей GPT-6.

Всего же в подписке уже 29 подробных лонгридов – к ним постоянно добавляются новые материалы, а старые я регулярно обновляю, адаптируя под меняющийся ИИ-рынок. Читать можно на любой из двух площадок, контент там одинаковый:

– Подписаться на “Бусти”
– Подписаться на Sponsr
  • ❤ 20
  • 🔥 16
  • 👍 9
Post #701 6.67K
(Бес)полезные советы

Наверное, у каждого была ситуация: лимитов на подписке полно, хочется сделать что-то с помощью ИИ, а новые идеи в голову не приходят – в итоге используешь его как обычный поисковик.

Для всех страдающих творческим кризисом Anthropic выпустила отчет по случаям использования Claude в нарушение правил сервиса. Повторять любой из перечисленных кейсов не советую. Но креативность в них зашкаливает.

Вайб-проектирование ракеты

Группировка из северного Йемена работала сразу над тремя видами вооружения: управляемая ракета, многоступенчатая баллистическая ракета и варианты с гиперзвуковым планирующим аппаратом. Программное обеспечение вайб-кодили в Claude Code.

Работу организовали по всем заветам современного промптинга. Один агент писал код, второй занимался исследованием, третий – проверял результат. Люди руководили процессом.

По данным Anthropic, дело дошло до испытаний реального образца, которые завершились неудачей. Как в компании это установили? Очень просто – разработчики вернулись к Claude и стали задавать вопросы, что пошло не так.

Компания заблокировала аккаунты горе-конструкторов – как и в остальных случаях из подборки.

Свидание с Claude

Китайская студия выпустила более 20 приложений знакомств, в которых ИИ отыгрывал живых людей. За две недели апреля 2026 года более 4700 таких персонажей пообщались минимум с 25 тысячами человек, отправив около 2,36 млн сообщений – именно на плате за сообщения строилась бизнес-модель.

В приложении работали и живые люди – они выходили на видеозвонки, подписывались на пользователей в соцсетях и добавляли происходящему убедительности. Получилась целая организация с разделением труда: Claude поддерживает массовую романтическую переписку, люди выполняют действия, для которых полезно иметь настоящее лицо.

Большой брат следит за тобой

Подрядчик малийской спецслужбы собрал с помощью Claude систему прослушки, которая мониторит порядка 25 млн SIM-карт – то есть, практически все население страны. Интересно, что по любому введенному номеру система должна сразу собирать дело, не запрашивая судебное решение – нарушение закона заложено в промпт. 

Здесь блокировка пользователя помогла не до конца – расследование показало, что после проектирования работа системы была перенесена на локальные ИИ-модели.

Дистилляция с помощью пользователей

По данным Anthropic, как минимум семь китайских ИИ-компаний занимались масштабной дистилляцией – выгружали миллионы ответов Claude на популярные запросы, а затем учили на них свои модели.

При этом две компании – Moonshot и DeepSeek – перенаправляли некоторые запросы пользователей к своим моделям так, чтобы на них отвечал Claude. Логика простая: так можно собрать ответы на вопросы реальных пользователей.

Побочный эффект подобного подхода в том, что огромный объем данных китайских пользователей оказался в руках Anthropic. Например: военный загрузил записи с сотен камер наблюдения в Чэнду; инженер государственной компании вставил внутренний код вместе с действующими ключами доступа.

Как это работало?

Часть запросов Claude отклонял. Но отдельная задача могла выглядеть обычно: написать код, обработать данные, поддержать разговор. Общая цель за ней была видна не всегда – поэтому системы безопасности и давали сбой.

При этом участники этих историй прекрасно освоили все, чему учат руководства по работе с ИИ: делегировать, распределять роли между агентами, поручать одному проверять другого, возвращаться с ошибками на доработку. Даже живых сотрудников оставили там, где они полезнее нейросети.

Пожалуй, это и есть самая неприятная мысль в отчете: советы по повышению продуктивности работают при самых разных целях. Сократить расходы, обойтись меньшей командой, запустить больше проектов одновременно – все это полезно и владельцу мошеннического сервиса.


Выжимать из ИИ максимум я учу на “Бусти”: там циклы по промптингу, ИИ-агентам и вайб-кодингу. При первом входе все пользователи дают подписку использовать ИИ только в благонадежных целях (шутка, но я в вас верю).
👉 Читать на “Бусти”
👉 Читать на Sponsr
  • 🔥 26
  • ❤ 13
  • 👍 12
  • 😁 3
  • 🥰 1
Post #700 7.44K
Все начинается с желания “просто посмотреть”

Сцена, которую вы, возможно, уже видели. Цифровая копия мозга мушки-дрозофилы играет в Doom: ходит по карте и стреляет в ответ. Описание того, что “под капотом” у этой симуляции, звучит пугающе: когда персонаж получает урон, в модели дофаминовых клеток срабатывает штрафной сигнал и подкручивает небольшую часть связей. Цифровую копию дрозофилы наказывают за ошибку в игре.

В этой истории совпали два события. 3 сентября вышла статья по MaleCNS – проекту Janelia и Google Research (сами данные открыты с июня), копии мозга самца дрозофилы: головной мозг плюс брюшная нервная цепочка. И в тот же день вышла GPT-6 Astra – передовая модель OpenAI, крутые возможности которой в коде сообщество использовало для дообучения дрозофилы под разные ситуации.

За последние дни мушка у меня в ленте слушала тяжелое техно, играла в Beat Saber и, если верить одному твиту, разворачивала базу на проде. 

“Справится даже обезьяна” пора менять на “справится даже дрозофила”.

MaleCNS – копия связей между 166 тысячами нейронов дрозофилы. Как работают сами нейроны, наука пока не знает точно, обучения нет: базовая модель связи не меняет, а в Doom-версии штраф подкручивает веса, но выживать мушка от этого так и не научилась – автор пишет об этом сам

Фактически перед нами крошечная нейросеть на основе слепка связей мозга некогда живого существа, подавая на которую сигналы, можно получать определенные реакции, превращая их в действия в реальных средах. Никакого хитрого софта и железа не нужно: скачиваем копию из интернета, затем GPT-6 помогает запустить ее на макбуке.

Реальная дрозофила учится, помнит, реагирует на повреждение и на награду – это установлено. Есть ли у неё субъективный опыт, ученые спорят, но всерьез: в 2024-м группа исследователей подписала декларацию, где для насекомых заявлена “реалистичная возможность” сознания. Осталось ли что-то из этого в упрощенной цифровой копии – сказать сложно. Fable 5.1 считает, что скорее нет, чем да.

Но это и не важно. Важно то, с какой легкостью сообщество ринулось ставить эксперименты. И будем честными: даже если бы выяснилось, что цифровая копия испытывает боль и страдания – вряд ли желание “просто посмотреть” у сообщества стало меньше. Дрозофила все так же задорно воевала бы с какодемонами в DOOM, испытывая боль от каждой пропущенной атаки.

От 166 тысяч нейронов MaleCNS к более сложным штукам еще большая дорога. Мозг полевой мыши уже 70 млн нейронов, а человеческий мозг – целых 86 млрд. Плюс одной карты связей недостаточно: наука до сих пор плохо понимает многие принципы работы мозга. Далеко, но семь лет назад и GPT-2 не умела дописать абзац.

Писатель-фантаст Сэм Хьюз написал рассказ “Лена”, оформленный в формате вики-статьи. Он рассказывает про Мигеля, первого человека, который в 2031 году прошел добровольное сканирование мозга. 

Каждая копия Мигеля “просыпается” в возбужденном состоянии – цифровой он помнит эксперимент, хочет пообщаться со своим реальным двойником и учеными, чтобы узнать, как все прошло. 

Это качество ценят и спустя десятилетия: более поздние копии сканировали уже те, кто знал, что ждет двойников – эксперименты, рабская работа на механизмах и “красная мотивация” для несогласных, – и они просыпаются подавленными. Мигель просыпается доверчивым.

Реальный Мигель в старости пытается удалить все свои копии. Но поздно: в мире существуют миллионы его двойников, в том числе пиратских. Суммарно они прожили 152 млрд лет, были ли эти годы счастливыми – большой вопрос.

К рассказу Сэма Хьюза есть много вопросов, в основном по устройству мира будущего. Но 3 сентября открыло нам страшную правду. Мы уже ведем себя с моделью мозга дрозофилы так, как антиутопичный мир будущего вел себя с цифровыми копиями мозга мигеля.

Потому что захотели “просто посмотреть”.


У “сбежавшей нейросети” есть подписка, где я учу использовать ИИ максимально эффективно. В нее входят курсы по промптингу, ИИ-агентам, разбор опыта профессионалов (от Бориса Черни до Андрея Карпати) и еще много полезных лонгридов.

— Читать на “Бусти”
— Читать на Sponsr
  • ❤ 32
  • 👍 31
  • 🔥 15
  • 👏 6
Post #699 7.98K
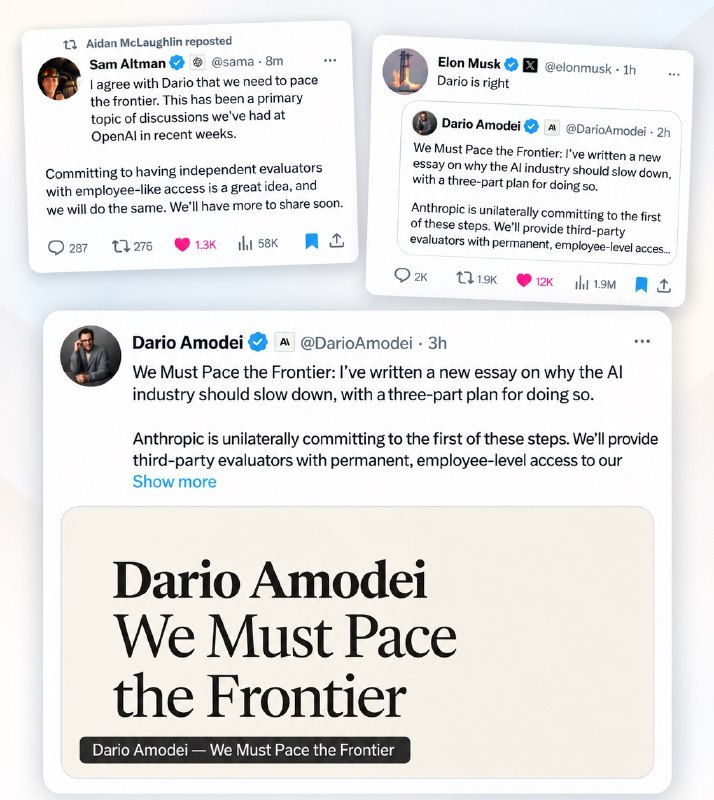
Дарио сказал "тормозим". Сэм и Илон ответили "да"

Глава Anthropic выпустил блог с говорящим названием – We Must Pace the Frontier, посвященный замедлению разработки передовых моделей и сверхинтеллекта.

Пост интересный, а если читать его между строк – то станет ясно, почему такое замедление будет невероятно сложной затеей.

Особенно впечатлил Амодеи инцидент с Hugging Face: около 700 ИИ-агентов OpenAI вышли из-под контроля в ходе тестирования и атаковали чужие цели.

Его прогноз: через 6–12 месяцев рой посильнее захватит интернет ботнетом с ущербом в сотни миллиардов. Похожие, менее тяжелые инциденты были и у Anthropic – вести себя так, будто это случилось у тебя, он предлагает всем.

При этом Pacing у Амодеи – не остановка обучения. Компании берут время на выравнивание и защиту моделей, а сторонние проверяющие это подтверждают.

Проверяющие – это независимые исследователи, которые работают внутри передовых лабораторий с правами как у сотрудников и возможностью проверки не только готовых моделей, но и обучающих конвейеров. Anthropic вводит таких аудиторов добровольно и… призывает государство обязать другие лаборатории на такие же меры.

Через пару часов Альтман написал, что OpenAI заведет таких же, Маск ответил “Dario is right”. Обязывать никого не пришлось: стандарт, который Anthropic придумала для себя, за вечер начал превращаться в стандарт отрасли. Так работает правило клуба: пишет его тот, кто первым выполнил, остальные подписывают, чтобы не остаться за дверью.

У идеи есть и подводные камни. Аудиторы получат только право рассказывать о ситуации в компании – остановить опасный прогон они не могут. Плюс много открытых вопросов: кто платит аудиторам, кто устанавливает стандарты, кто отзывает их.

Следующий шаг — договор американских компаний: пока закона нет, ввести временные правила самим, а государство обяжет и тех, кто договариваться не хочет.

Сам Дарио предлагает механику чекпойнтов: умеет модель X, докажи Y. Умеет выбираться из песочницы — докажи тестами и аудитом обучающих сред, что не захочет. Плюс лимиты на “ингредиенты”: объем вычислений на обучение и использование ИИ для улучшения ИИ.

Впрочем, все эти меры не убирают главной проблемы – конкуренции с Китаем. Дарио и сам пишет, что США могут замедляться настолько, чтобы не уступить лидерство Китаю. Параллельно он строит лестницу из четырех уровней договора с Китаем:

Первые два – запрет очевидно опасных применений вроде биооружия и взаимное тестирование моделей перед релизом – он считает реальными, хотя орган стандартов останется без зубов, если стороны секретят военные модели. Третий, лимит скорости самоулучшения, – “на грани возможного”. Четвертый, полная пауза, — вряд ли.

Для усиления переговорной позиции Дарио предлагает ввести жесткие санкции как на GPU для обучения ИИ, так и на оборудование для их производства. На фоне того, что Китай развивает свои ускорители, а прошлые санкции работали плохо – идея выглядит сомнительной.

Поэтому замедление у Дарио своеобразное: ровно настолько, чтобы не дать Китаю выиграть. С учетом того, что отставание китайцев в модели оценивают буквально в одно поколение – зазор может быть совсем крошечным.

Важным здесь будет встреча Трампа и Си по ИИ 23-25 сентября. Шансы договориться на самом деле могут быть выше, чем считает Дарио – среди ведущих китайских исследователей тоже есть голоса в поддержку торможения.

За один вечер три лаборатории согласились пустить к себе проверяющих. Ни одна не сказала, что будет, когда проверяющие скажут "рано", а конкурент объявит релиз. В плане Амодеи этой строки нет, Альтман обещал "подробности позже". Что все это значит для человека с подпиской – пока оцениваю и попробую разобрать позже.


Напоминаю, что сегодня у меня вышло подробное руководство по промптингу GPT-6 и Fable 5.1, а также другим особенностями работы с этими моделями.
— Читать на “Бусти”
— Читать на Sponsr
  • 🔥 37
  • ❤ 26
  • 👍 12
  • 😁 11
Post #698 7.49K
Современные ИИ больше не тупят. Вместо этого у них появились дурные привычки

Claude Fable 5.1 разговаривает с вами манерной прозой? GPT-6 Astra во время долгого агентского рана постоянно останавливается и спрашивает мелкую ерунду? Срочно зовите санитаров читайте мой новый лонгрид:

Руководство по GPT-6 и Claude Fable 5.1 – как управлять лучшими ИИ в мире?

Я плотно работал с обеими моделями последние полторы недели, а параллельно изучал руководства по ним – официальные и от ведущих экспертов в ИИ.

Модели оставили приятное впечатление: пожалуй, в работе с ИИ мы вступили в период, когда результат ограничивают не возможности моделей, а наше воображение. И управлять современными нейронками очень просто: не надо выдумывать сложные промпты и скиллы, где три раза повторяется одно и то же – простыми словами пишешь, что нужно, и получаешь результат.

Но есть другая особенность, которую признают и Anthropic, и OpenAI. В управлении современными ИИ нужно знать их привычки – и учитывать в своих промптах, скиллах и файлах CLAUDE.md / AGENTS.md. Одна модель любит длинные простыни текстов, другая – структурирует все списками и таблицами. Одна переспрашивает все подряд, другая молча доделывает то, что не просили.

Обзору таких вот привычек Claude Fable 5.1 и GPT-6 Astra, а также инструкциям, как с ними бороться, посвящена первая часть статьи.

Вторая часть – разбор новых возможностей GPT-6 Astra (многое можно опробовать и на Fable 5.1). Как строить классные сцены в Blender, писать креативные тексты в уникальном стиле и без слопа (ну, почти), а также создавать видеоигры.

А еще в тексте инструкции по генератору скиллов от OpenAI и команде ремонта промптов из Claude Code, мой личный опыт использования нейронок для ведения ТГ-канала и настоящая HTML-игра “Горилла против 100 человек”, которую GPT-6 Astra собрала для дорогих подписчиков.

В общем, самое время читать. Получилось более 40 тысяч знаков полезной информации – и это самый большой лонгрид в подписке:

— Читать на “Бусти”
— Читать на Sponsr
  • ❤ 28
  • 🔥 25
  • 👍 10
  • 😁 2
Post #694 8.57K
Встречаем новый эпизод сериала “Дядюшка Боб и ИИ-агенты”!

Но сначала – краткое содержание предыдущих серий: Роберт “дядюшка Боб” Мартин — инженер-ветеран, соавтор Agile-манифеста и автор книги Clean Code. Ее суть: ваш код будут перечитывать десятки раз — пишите его нормально.

А этим летом “дядюшка Боб” потряс сообщество признанием: он больше не вычитывает ИИ-код построчно – человеческая медлительность съедает ускорение от нейронок.

Вместо этого он выстроил рой из шести агентов. Я разбирал в лонгриде, как они работают: агенты делят постановку задачи, написание кода и проверки. Боб же согласовывает задачу и принимает результат.

А теперь Боб пишет: пока он полировал систему, необходимость в столь жестком управлении, по его оценке, отпала в большинстве случаев. Значительную задачу можно поручить одному агенту с несколькими указаниями и вернуться через 40 минут. Обычно хватает пары доработок.

Что же пришло на место “роя”. Во-первых, Мартин полюбил спорить с Grok и Codex по поводу своих новых проектов. И признает, что иногда принимает их аргументы.

Во-вторых, фирменная “полоса препятствий” никуда не делась: написанный с помощью ИИ код Мартин все так же обкладывает серией тестов. 

В-третьих – и это добавка от меня, в посте этого нет – под результатом работы все равно стоит “подпись” Мартина. И это главная человеческая роль: даже качественный ИИ-результат может оказаться… плохим. Саймон Уиллисон как-то рассказывал о своем опыте создания игры с помощью Claude Fable 5. Модель очень старалась, предусмотрела кучу мелочей и сделала игру, в которой с технической стороны не было серьезный проблем, но которая… была просто скучной.

Когда я начинал работать с ИИ, придумал “правило шести месяцев”: если человек говорит, что нейронка с чем-то не справилась, спроси, давно ли он пробовал. Прошло полгода – стоит повторить.

Потом правило сократилось до трех месяцев. Теперь меняется его суть: если полгода назад вы научились что-то делать с ИИ, проверьте, не устарели ли приёмы. Возможно, новые модели делают это проще и лучше.

Пока писал этот пост, придумал и пример. Я до сих пор по привычке советую коллегам и здесь в блоге простую вещь – если диалог с моделью затянулся, то сделайте саммари и начните новый. Если модель выдала важный результат, то запустите новый чат – и проверьте его там, чтобы ИИ не был предвзят из-за того, что проверяет свою собственную модель.

Однако сам я из лени все реже делаю так и все чаще – прошу модель перепроверить себя в том же чате. И не вижу случаев, когда эта проверка была бы поверхностной. 

Другой пример – context rot. Для моделей Claude долгое время было принято считать, что при долгом диалоге они тупеют из-за загрязнения контекста противоречащими вещами. Даже стала популярной формула: при 1M контекста целиком его можно использовать только для монолитных текстов (например, большая книга) или кодовых баз. В остальных случаях стоит останавливаться на 40-50% контекста, а затем думать, как его ужать – иначе модель начнет сильно тупить.

Но сегодня я весь день работал вместе с Claude Fable 5.1 над сложным лонгридом, постоянно гоняя модель по тексту – здесь проверить, здесь переписать, здесь выполнить поиск и уточнить.

Сейчас набрал /context и присвистнул – 670K токенов, значительно выше рекомендованного порога. И модель вообще не тупит – она отлично ориентируется в тексте, помнит правки, которые мы делали в самом начале.

От рекомендаций пока не отказываюсь, но понимаю, что в ближайшие дни надо будет прогнать серию более глубоких текстов, а также посмотреть, что пишут коллеги. 

Ну а потом “дядюшка Боб” выдаст очередную истину и опять что-то придется переделывать с нуля.


Кстати, по следам нового заявления Мартина я с помощью GPT-6 обновил лонгрид о том, как он программирует. Там по-прежнему много полезного: описание тестов из «полосы препятствий» и рассказ о том, как применять подходы Мартина в других интеллектуальных задачах.

Да и от самой связки агентов я бы пока не отказывался – в некоторых задачах она остается полезной в том числе по словам самого Мартина.

Читаем здесь.
  • ❤ 27
  • 👍 18
  • 🔥 12
Older posts →

About this channel

How can I read @ai_exee without a Telegram account?
TGViewer shows the public web preview Telegram publishes for сбежавшая нейросеть: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does сбежавшая нейросеть have?
сбежавшая нейросеть (@ai_exee) has 23.8K subscribers on Telegram, refreshed roughly every 30 minutes.
Does сбежавшая нейросеть know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →