TGViewer
Channel Public Channel
What does data mean?

What does data mean?

@whatdoesdatamean

Поток ссылок про аналитику
Subscribers
188
Photos
15
Videos
0
Links
91
Recent Posts 16 shown
Post #111 84

Forwarded from m2_tech

Что делать, если в KPI маркетолога стоит выручка — но напрямую управлять ей он не может? 🦖

На итоговый результат одновременно влияют продукт, маркетинг, продажи и другие команды. А значит, просто спустить продуктовые метрики в маркетинг недостаточно: нужно понять, где заканчивается зона влияния одной команды и начинается зона другой.

В М2 мы столкнулись с этой проблемой и решили построить единое дерево метрик, которое связало бы бизнес-показатели с тем, чем маркетинг действительно может управлять.

В новой статье на Хабре Сергей Кноль, маркетинговый аналитик, и Артём Колесник, руководитель продуктового маркетинга М2, рассказывают:

➕почему классическое дерево метрик не подошло для задач маркетинга;
➕как мы трижды пересобирали модель и где ломалась логика;
➕почему в дерево обязательно пришлось добавить расходы маркетинга;
➕как разделили KPI на объём, качество и экономическую эффективность;
➕как проверили подход на PMM и начали масштабировать его на другие направления;
➕и почему дерево пока не получается одинаково хорошо применить к SEO и бренд-маркетингу.


Наш фреймворк не обязательно соблюдать буквально, но можно адаптировать модель под то, как действительно работает бизнес.

Читайте статью на Хабре 👀
  • ❤ 2
  • 🔥 2
Post #106 115

Forwarded from Evidence Based

#books #experiments #causality #A_B_testing
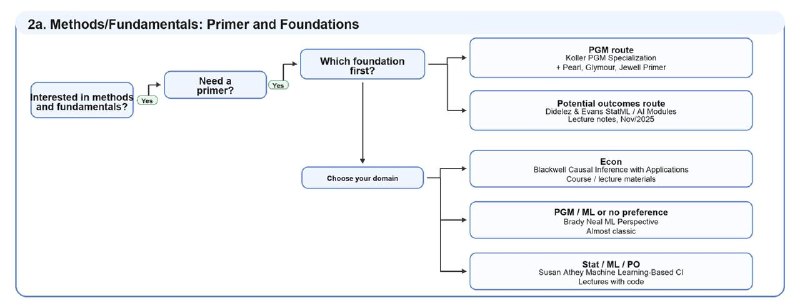
Which Causal Inference Book Should You Read — Update

У causal inference проблема с книгами: хороших слишком много.

Пост затевался как апдейт классической карты Brady Neal:
https://www.bradyneal.com/which-causal-inference-book

Там до сих пор отличная точка входа. Но с 2019-го полка заметно выросла, и ориентироваться стало сложнее.

Мы в ридинг-группе иногда читаем вместе Bareinboim, Causal Artificial Intelligence, и по ходу разговоров «а что ещё стоит читать» решили собрать версию 2026. Новые книги, конспекты, causal ML, causal discovery, эксперименты, эконометрика, биостатистика — нормальных точек входа теперь много, и они зависят от того, что вам на самом деле нужно.
  • 🔥 3
Post #103 299
What does data mean? M2tech собирает аналитический митап с экспертами рынка, чтобы обсудить атрибуции, конверсии и современную маркетинговую аналитику. Встречаемся в следующую среду, 24 июня, в 17:00 Мск в онлайне. Регистрация по ссылке: https://networkly.app/event/6421 Будет…
Начинаем через 15 минут!
Ссылка для подключения: https://dion.vc/event/m2analystmeetup
  • ❤ 2
Post #102 417
M2tech собирает аналитический митап с экспертами рынка, чтобы обсудить атрибуции, конверсии и современную маркетинговую аналитику.

Встречаемся в следующую среду, 24 июня, в 17:00 Мск в онлайне. Регистрация по ссылке: https://networkly.app/event/6421

Будет полезно продуктовым аналитикам, продакт-менеджерам и командам маркетинга.

На митапе:

— Сергей Кноль (маркетинговый аналитик в М2) расскажет, как не нашёл свою модель атрибуции. Этот доклад познакомит с основными моделями атрибуции и их ограничениями
— Александр Игнатенко (эксперт по маркетингу и автор канала @marketing_analysis) расскажет про сложности атрибуций в B2B
— В рамках круглого стола с Романом Литвиновым (лид RnD аналитики в
Т-Банке и автор канала @isa_org) обсудим, как построить кастомную модель атрибуции и не обмануть самих себя
— В рамках второго круглого стола с Оксаной Потолковской (Head of brand media
в Selectel) и Евгением Черданцевым (Growth Advisor в Skyeng и автор канала @cherdancev_marketing) обсудим, можно ли считать бренд-медиа маркетинговым каналом или нет?
  • ❤ 8
  • 🔥 2
Post #101 315

Forwarded from Смоллтех Сообщество

Полная программа митапа Smalltech митап Vol.3. Продуктовая аналитика

Мы собрали живые ёмкие кейсы, где что-то пошло не так, пришлось изобретать, заново приоритизировать или выходить из зоны комфорта, а еще — нетипичные инструменты для работы аналитика.

1️⃣Как мы запороли A/B-тест и реанимировали его бутстрапом
Регина Кравченко, продуктовый аналитик, продукт «Ипотечный брокер», М2
Честный разбор: эксперимент не взлетел, что делать — не выкидывать, а спасать статистически. Бутстрап, метрики, подводные камни.

2️⃣Текстовые комментарии к заказам как источник инсайтов: ML для продуктовых аналитиков
Софроний Новиков, продуктовый аналитик, Петрович-Тех
Кейс извлечения гипотез из грязных текстов — с цифрами о том, что реально нашли и как приоритизировали.

3️⃣Как ИИ ускоряет работу продуктового аналитика: от гипотезы до роадмапа за 2 дня вместо 2 недель
Максим Богуславский, фаундер, Альфа-Функция
Честно: где AI реально экономит часы (генерация user stories, RICE-приоритизация, суммаризация отзывов), а где — нет. С готовыми промптами и чек-листами.

4️⃣Гемба для аналитика: как 2 часа в поле генерируют гипотезы, которые не найти в дашбордах
Алексей Борискин, системный аналитик, Техвилл
Выход за пределы экрана: какие инсайты о продукте можно получить только «на земле» и как превратить их в проверяемые гипотезы с RICE-оценкой.

5️⃣Мастер-класс по Opportunity canvas: как не тратить спринты на фичи, которые никому не нужны
Анастасия Московкина, системный аналитик, ИнфоТеКС
Участники за 40 минут разберут пример использования инструмента — чтобы после встречи приложить к собственным задачам, а не просто слушать.

Итого: огромная программа, потому что каждый доклад — действительно золото для практического применения. Регистрироваться на онлайн или офлайн — по ссылке. Если планируете прийти, зарегистрируйтесь заранее, пожалуйста: во спасение своей кармы и души организаторов :)
  • ❤ 7
  • 🔥 7
  • 👏 6
Post #100 251
Аналитическая конференция, но все идеи реализуемы.

Кейсы с конференций обычно классный источник вдохновения, но 90% из них приносят ребята из больших и известных компаний. После перехода в компанию поменьше я обнаружила, что во-первых в смоллтехах тоже есть есть жизнь, а во-вторых, многие решения крупных компаний для них реализуемы только с читом motherlode.

Поэтому очень классно видеть, что появляются сообщества маленьких технологических компаний. Задачи у них похожие, а особенности их решения часто еще более интересные. Ребята из сообщества Smalltech 28 мая проводят митап по аналитике, приходите послушать и проникнуться.

Участие бесплатное, оффлайн в Питере или онлайн где угодно. Полная программа и ссылка на регистрацию ниже:
  • 🔥 4
Post #99 725
Вывод после 162 собеседований за год — кандидаты забывают думать.

Прочитала пост про ожидания от рыночка труда в 2026 году. Что хочется добавить про продуктовых аналитиков:

1. Нейронки стали стандартным рабочим инструментом и с этим бесполезно бороться.

Кандидатам нужно разрешать гуглить и использовать нейронки на собеседовании — это шанс подглядеть в голову человека и понять, как он думает о задаче. К тому же это позволяет предположить, как кандидат сможет разрулить сложную для себя задачу в работе — правильно сформулирует запрос и продвинется к ответу или зависнет.

2. Ключевой навык, который многие забывают продемонстрировать на собеседовании — умение думать.

Я всегда даю мини-кейс, в котором мало вводных данных. Классные кандидаты замечают это и не пытаются решить задачу с наскока. Они уточняют неизвестное, выстраивают импровизированное дерево решений и выходят на ответ, который могут обосновать логически. Спорные кандидаты вспоминают о вопросах после нескольких спотыканий и тупиков. Слабые кандидаты просто накидывают ответы, случайно верные или неверные.

3. Умение думать слабо коррелирует с опытом или хардами.

Встречались джуны, которые потрясающе структурировали мысли. Встречались сеньоры, которые не могли перевести задачу бизнеса в аналитическую. Но увы, это не значит что можно забить на технические навыки. Собеседник может быть в восторге от вашего светлого ума, но встроить в команду человека, который не умеет писать код — боль для всех причастных.

4. Резюме это правда важно.

Чтобы провести 162 собеседования пришлось отсмотреть 500+ резюме. Вполне возможно, что за какими-то из них скрывались хорошие кандидаты, но понять это было невозможно. Все, что было в резюме — человек работал работу. Приносил ли он пользу бизнесу, какие задачи для него были важны — загадка. Задача аналитика не собрать как можно больше дашбордов или закрыть как можно больше тикетов. Задача аналитика — заставить данные заработать деньги. Если из резюме это не очевидно, шансы попасть на собеседование низкие.

5. Цена ошибки высока.

У компании нет задачи дать работу всем классным ребятам или даже найти самого классного кандидата. Задача компании — закрыть вакансию максимально быстро и тем человеком, который в состоянии делать работу хорошо. Это даже проще задачи о переборчивой невесте, потому что не надо выбирать лучшего. Компании выгоднее отказываться от всех сомнительных кандидатов, чем тратить время на знакомство с ними.
Telegram Илья, пусть это заработает Что будет на рынке IT-найма в 2026 году. В феврале уже можно говорить о том, что компании проснулись, проверили бюджеты и постепенно вкатываются в привычный ритм найма. Где-то он уже работает на полную катушку, где-то только выходит из спячки, но вам это…
  • ❤ 17
  • 🔥 10
  • 👏 8
Post #98 611
Зачем аналитики диптеху?

В декабре закончился проект Диптех головного мозга, где я была ментором студенческих проектов.

Задача ментора — помочь студентам докрутить идеи в сфере нейротеха до бизнес-проекта, у которого понятна аудитория, юнит-экономика и пути выхода на рынок.

В общих чертах очень похоже на повседневную работу продуктового аналитика в дискавери, правда?

За одним (прекрасным!) отличием — докручивать нужно было не перерисовки флоу и программы лояльности, а технологии напрямую из исследовательских лаб и статей.

Плохая новость — это очень сложно. Я периодически вообще не понимала, о чем студенты говорят. Они наверное иногда тоже, но продуктовые подходы все-таки понять проще.

Хорошая новость — это очень вдохновляюще. Ощущение, что постоял рядом с краем науки и потенциальным диптех-предпринимателем, непередаваемо.

Спасибо Neiry и Тиграну Басеяну за приглашение поучаствовать, это было круто!

О студентах и их проектах ещё расскажу отдельно. Спойлер — про них стоит узнать.
  • 🔥 7
  • ❤ 5
  • 👏 4
Post #97 570
Лучшая метрика эффективности команды аналитики.

Весь этот год я придумывала способы повысить импакт команды и улучшить жизнь аналитиков. Неожиданно и приятно, но лучшим оказалось найти хорошую таргетную метрику эффективности и растить её.

Метрика: доля задач, в которых результатом работы аналитика является только выгрузка данных.

Наличие большого количества таких задач сигнализирует сразу о пачке проблем:

- нет нормальной инфраструктуры, менеджерам недоступны данные в удобном виде
- нет инсайтов, аналитик в этом кейсе заменим интерфейсом к бд
- аналитики под риском выгорания, потому что мало кому интересно заниматься однообразными и несложными задачами.

Плюс метрики в том, что работа с ней помогает не зацикливаться на конкретных проектах и заставляет находить решения для всего скоупа возможных проблем. Очевидный минус - моя премия теперь частично зависит от желания продакта снять тревогу очередной выгрузкой.
  • ❤ 19
  • 🔥 9
  • 👏 8
Post #96 852

Forwarded from Math for Impact

Математика последовательных подходов

TL;DR
Три последовательных критерия — SPRT, GST и mSPRT — используют разную математику. В этом посте — краткий обзор формул, допущений, сильных и слабых сторон каждого критерия.

Почему обсуждается?
Последовательные подходы основаны на разных математических принципах — от мартингальной теории до центральной предельной теоремы. Понимание используемой математики помогает лучше видеть ограничения и преимущества методов, а также адаптировать последовательный анализ под конкретную задачу.

Подход Вальда (SPRT)
Критерий
1. На n-м шаге вычисляем λ(x(n)) = log(p(x(n) | H(1)) / p(x(n) | H(0))).
2. Считаем λ(x(1:n)) = λ(x(1:n-1)) + λ(x(n)).
3. Если λ(x(1:n)) выходит за границы [A, B], останавливаем эксперимент, иначе продолжаем.
Эта процедура завершается выходом за одну из границ. Чтобы выразить вероятности ошибок, используется теорема об остановке мартингала, построенного по λ.

Достоинства
– Останавливает тест и при H(0), и при H(1).
– Минимизирует среднюю длительность эксперимента и при H(0), и при H(1).
– Гарантирует контроль вероятности ошибки без асимптотических допущений.
– Применим к конверсионным метрикам, в том числе к сравнению конверсий двух выборок.

Недостатки
– Требует точного задания распределений при H(0) и H(1).
– При остановке λ почти всегда оказывается около границы, но не на ней, что искажает реальные вероятности ошибок по сравнению с заданными.
– Может завышать длительность эксперимента при «промежуточной» гипотезе между H(0) и H(1).
– Консервативен при поступлении групп наблюдений.

Групповой последовательный анализ (GST)
Критерий
1. Для j-й группы данных вычисляем статистику Z(j) по первым N(j) наблюдениям.
2. Считаем долю t(j) = N(j) / N.
3. Если Z(j) > z(t(j)) → принимаем H(1); иначе — продолжаем.
4. Если дошли до N и не приняли H(1) → принимаем H(0).
Эта процедура останавливается либо выходом за границу, либо принудительной остановкой эксперимента. Чтобы выразить вероятности ошибок, используется многомерная ЦПТ для вектора Z-статистик, соответствующих группам наблюдений.

Достоинства
– Ускоряет проведение теста при H(1).
– Условия применимости как у Z-теста.
– Есть гибкость в настройке границ.
– Поддерживает подачу данных группами.

Недостатки
– Не ускоряет проведение теста при H(0).
– Требует достаточного числа наблюдений для применимости ЦПТ.
– Требует заранее заданного общего объёма выборки N.
– Требует настройки α-spending функции.

mSPRT
Критерий
1. На n-м шаге считаем байесовское отношение правдоподобий O(x(n)).
2. Вычисляем O(x(1:n)) = O(x(1:n-1))·O(x(n)).
3. Если O(x(1:n)) > 1 / α → принимаем H(1); иначе — продолжаем.
4. Если дошли до N и не приняли H(1) → принимаем H(0).
Эта процедура останавливается либо выходом за границу, либо принудительной остановкой эксперимента. Чтобы выразить вероятности ошибок, используется неравенство Вилле для максимума мартингала.

Достоинства
– Ускоряет проведение теста при H(1).
– Статистика критерия и граница считаются по простым формулам.
– Гарантирует контроль вероятности ошибки без асимптотических допущений.

Недостатки
– Не ускоряет проведение теста при H(0).
– Требует точного задания распределения при H(0).
– Основан на неравенстве Дуба, которое даёт консервативную границу и снижает мощность.
– Консервативен при поступлении групп наблюдений.

Что использовать
SPRT
Хорошо подходит для бинарных целевых метрик.

GST
Подходит для целевых метрик, но лучше — для метрик здоровья или проверки SRM.

mSPRT
Хорошо подходит для метрик здоровья или проверки SRM.

Библиография
Основная статья:
Choosing a Sequential Testing Framework — Comparisons and Discussions
Книга:
Tartakovsky A., Nikiforov I., Basseville M. Sequential analysis: Hypothesis Testing and Changepoint Detection. – CRC Press, 2014.
mSPRT:
Lindon M. et al. Anytime-valid Inference in Linear Models and Regression-adjusted Inference //Harvard Business School. – 2024.
Spotify Engineering Choosing a Sequential Testing Framework — Comparisons and Discussions | Spotify Engineering
Post #95 545
Лучший канал из тех, на которые подписалась за последние полгода
Post #94 582
m2_tech Доклад Евы на Aha! Conf 2025 🐇 Совсем недавно знакомили вас с Евой Панкратовой, а сегодня анонсируем её выступление на Aha! Conf для data-аналитиков, ML-разработчиков и product-менеджеров. В докладе Ева расскажет: — как выбрать и внедрить платформу АБ…
Скорость написания постов в этом канале: мы с редактором успели написать и выпустить статью по мотивам выступления, прежде чем я дописала пост с мыслями по поводу конференции
  • ❤ 1
Post #93 826

Forwarded from m2_tech

Доклад Евы на Aha! Conf 2025 🐇

Совсем недавно знакомили вас с Евой Панкратовой, а сегодня анонсируем её выступление на Aha! Conf для data-аналитиков, ML-разработчиков и product-менеджеров.

В докладе Ева расскажет:

— как выбрать и внедрить платформу АБ-тестирования в небольшой компании;
— каковы были наши критерии выбора: требования аналитики и разработки;
— как шёл процесс внедрения платформы;
— как подготовить всех пользователей и не прийти к неверному использованию тестов.

Доклад будет полезен тем компаниям, у которых не огромный штат аналитиков, а А/Б – ещё не пройденный этап развития. Мы прошли этот путь, набили шишки и можем поделиться опытом, который поможет другим коллгегам внедрить платформу с меньшими потерями. 🚀
  • ❤ 1
Post #92 626
Завтра рассказываю про боли выбора абшницы при ограниченных ресурсах
Post #91 622

Forwarded from Не AБы какие тесты

Не пропускаем понедельник, товарищи-статистики!

Хотел продолжить серию про секвентальное тестирование, но уже довольно свежий (!) и интересный алгоритм показался мне прям сильно сложнее для объяснения, чем тот, что был ранее, поэтому сегодня поговорим про оценку кумулятивного эффекта - то, как несколько изменений, по которым были тесты, повлияли совместо.

Классическая и очень простая история это выделить глобальную контрольную группу, - holdout, - на которую какое-то время не будет распространяться никаких улучшений.

Но что если такую группу выделить по каким-то причинам невозможно, а оценить нужно?
Причины могут быть от технических до прое "забыли".

В начале года столкнулся с тем, что нужно было продумать, как оценить кумулятив при сценарии невозможности выделения holdout'a. И на методологию от Airbnb, которая мне очень пришлась по душе (так как математически выведена оценка!), меня навел Влад. Статья ниже написана в том числе благодаря его материалам, большое ему спасибо!

Статья начинается со слов "Winner's Curse", Проклятье победителя: смысл в том, что в рамках аукциона, где продается неких товар, победитель аукциона (а это часто наибольшая ставка) скорее всего заплатит больше, чем фактическая стоимость товара. Так и в рамках наивного суммирования эффектов от прошедших тестов - скорее всего оценка будет завышенной.

Разберем Winner's Curse: Bias Estimation for Total Effects of Features in Online Controlled Experiments
Telegraph Оценка кумулятивного эффекта Объяснение будет следовать согласно докладам как Влада, так и ребят из Airb'n'b. Пускай у нас есть ряд экспериментов, в которых мы получили следущее: Observed - это та дельта, что мы наблюдаем, а True - это истинная дельта, "что есть на самом деле". Как видно…
Older posts →

About this channel

How can I read @whatdoesdatamean without a Telegram account?
TGViewer shows the public web preview Telegram publishes for What does data mean?: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does What does data mean? have?
What does data mean? (@whatdoesdatamean) has 188 subscribers on Telegram, refreshed roughly every 30 minutes.
Does What does data mean? know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →