
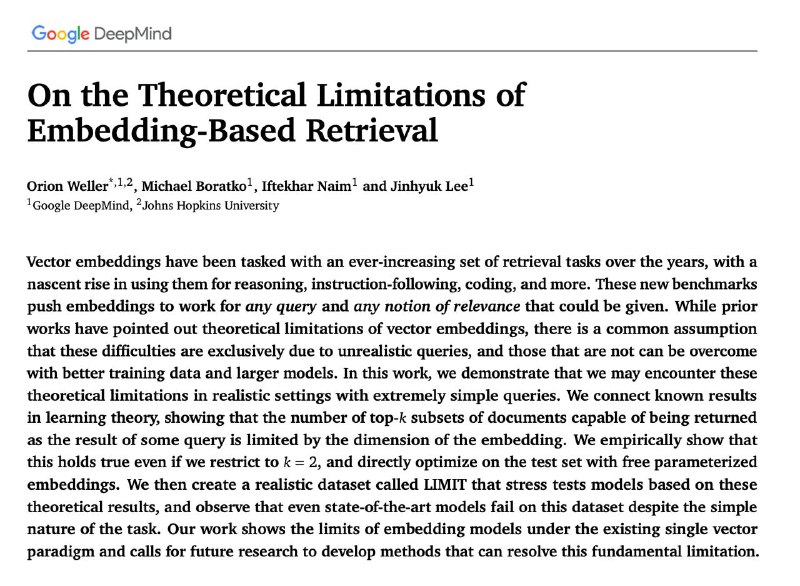
TL;DR: оказалось, что всеми любимый и привычный поиск на эмбеддингах может не всё и имеет серьёзный фундаментальный предел. При фиксированной размерности вектора таким подходом просто невозможно находить все релевантные документы из базы. В своей работе Google доказали это и теоретически, и экспериментально.
О чем вообще речь. Современный поиск и RAG часто опираются на single-vector эмбеддинги: у каждого запроса и документа – по одному вектору, похожесть меряем скалярным произведением/косинусом, дальше берем топ-k ближайших.
И тут возникает вопрос: а вообще возможно ли при фиксированной размерности векторов построить такой поиск, который всегда будет возвращать правильные топ-k документов для любых запросов? Ответ – нет. И сбой происходит уже на очень простых примерах.
Интуитивное объяснение, почему так: чем больше база знаний, тем больше разнообразных комбинаций запросов и релевантных документов нам нужно поддерживать. Но пространство поиска всегда ограничено размерностью эмбеддингов. Так вот, начиная с какого-то числа документов, расположить точки в этом пространстве так, чтобы для каждого запроса мы находили правильные доки, просто невозможно.
Математическое объяснение для любителей:
Представим матрицу A, где строки – это запросы, а столбцы – документы, и на пересечении стоит 1, если документ релевантен, и 0 – если нет. Мы хотим, чтобы поиск на эмбеддингах воспроизводил именно такую матрицу «кто кому подходит». Тогда оценки похожести будут матрицей B = UᵀV, где U и V – это векторы запросов и документов в пространстве фиксированной размерности d. Но sign-rank матрицы (2A−1) может оказаться больше d, а это значит, что никакие d-мерные эмбеддинги не смогут построить B с правильными значениями. Формально: если sign-rank(A) > d, то корректное разделение релевантных и нерелевантных пар в таком пространстве просто невозможно, каким бы мегаумным ни был ваш эмбеддер.
То есть, например, если у вас эмбеддинги размерности 512, то ваш RAG будет работать нормально, пока документов в вашей базе менее 500 тысяч (а это довольно немного). При размерности 1024 – до ~4 млн. При 4096 – примерно до 250 млн. Дальше система начнет сыпаться.
И эти расчеты Google подвели в идеальных условиях, когда векторы оптимизированы под задачу. На практике, когда вы не дообучаете эмбеддинги, пределы еще ниже.
Чтобы показать это на практике, авторы придумали специальный бенчмарк LIMIT. Он построен так, что у каждого запроса релевантны ровно два документа, но комбинаций этих пар очень много. В итоге даже лучшие современные эмбеддеры (GritLM, Qwen3, Gemini и др.) показывают на LIMIT катастрофически низкий recall – около 20% (причём даже на маленькой версии датасета с 46 документами, караул!).
Для сравнения, классический BM25 или multi-vector модели вроде ColBERT выбивают почти 100%. Фишка в том, что тут мы уже не зажаты одним вектором на документ и запрос. Например, у ColBERT стоится много векторов на документ.
Ну короче, мораль такова: поиск на одном векторе – это удобно и быстро, но у него есть жёсткий фундаментальный предел. Поэтому для серьёзных систем RAG все-таки нужны гибридные подходы: разреженный поиск, multi-vector и прочее. Иначе – потолок 😐
Полный текст: On the Theoretical Limitations of Embedding-Based Retrieval