Post #212
211
Закину сюда, довольно интересные материалы
 BI
@tabulated_stats
Showing posts older than #213 · Back to latest
Biostatistics on the Table Пришла в голову следующая задачка: Думаю, что многие знают, что t-тест Стьюдента является просто частным случаем МНК регрессии. set.seed(42) x <- rep(0:1, times = c(10, 15)) y <- rnorm(length(x), mean = x) t.test(y ~ x, var.equal = TRUE) |> broom::tidy()…
set.seed(42)
x <- rep(0:1, times = c(10, 15))
y <- rnorm(length(x), mean = x)

t.test(y ~ x, var.equal = FALSE) |>
    broom::tidy() |>
    dplyr::select(
        estimate, statistic, df = parameter, p.value
    )
#> # A tibble: 1 × 4
#>   estimate statistic    df p.value
#>      <dbl>     <dbl> <dbl>   <dbl>
#> 1   -0.400    -0.845  22.4   0.407

nlme::gls(
    y ~ x,
    weights = nlme::varIdent(form = ~ 1 | x),
    method = "REML"
) |>
    emmeans::emmeans(~ x, mode = "satterthwaite") |>
    emmeans::contrast("revpairwise") |>
    tibble::as_tibble() |>
    dplyr::select(
        estimate,
        statistic = t.ratio,
        df, p.value
    )
#> # A tibble: 1 × 4
#>   estimate statistic    df p.value
#>      <dbl>     <dbl> <dbl>   <dbl>
#> 1    0.400     0.845  22.4   0.407
set.seed(42)
x <- rep(0:1, times = c(10, 15))
y <- rnorm(length(x), mean = x)

t.test(y ~ x, var.equal = TRUE) |>
    broom::tidy() |>
    dplyr::select(
        estimate, statistic, p.value
    )
#> # A tibble: 1 × 3
#>   estimate statistic p.value
#>      <dbl>     <dbl>   <dbl>
#> 1   -0.400    -0.755   0.458

lm(y ~ x) |>
    broom::tidy() |>
    dplyr::filter(term != "(Intercept)") |>
    dplyr::select(
        estimate, statistic, p.value
    )
#> # A tibble: 1 × 3
#>   estimate statistic p.value
#>      <dbl>     <dbl>   <dbl>
#> 1    0.400     0.755   0.458
t.test(y ~ x, var.equal = FALSE) |>
    broom::tidy() |>
    dplyr::select(
        estimate, statistic, p.value
    )
#> # A tibble: 1 × 3
#>   estimate statistic p.value
#>      <dbl>     <dbl>   <dbl>
#> 1   -0.400    -0.845   0.407
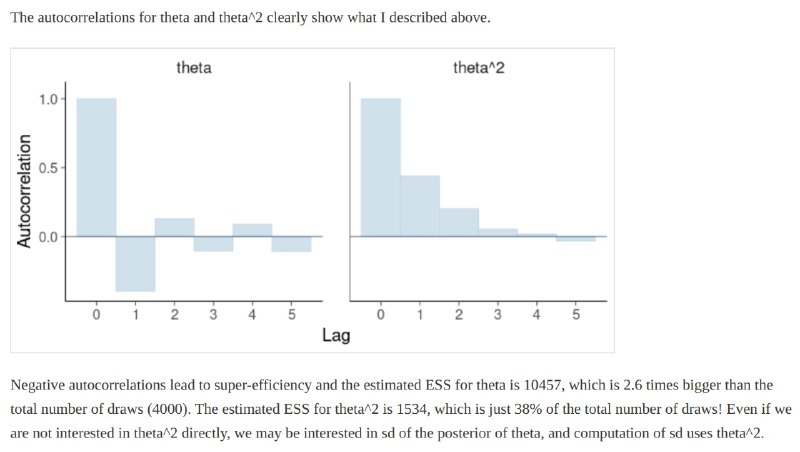
Biostatistics on the Table Сейчас подумал, что MCMC (вернее анализ того, что происходит внутри цепи) очень ярко отражают контринтуитивность теорвера и матстата. Пост Вехтари в блоге Гелмана про effective sample size
Sinекура Принцип максимума энтропии показывает, какие распределения вероятностей являются "наиболее характерными"
Biostatistics on the Table И вот что еще удивительно: априорные распределения Джеффриса имеют непосредственное отношение к фриквентистскому методу, который недавно рассматривали.
suppressPackageStartupMessages({
    library(tidyverse)
})

df <- tibble(
    group = 0:1,
    N = c(25, 25),
    events = c(0, 3)
)

# Haldane correction for OR
df |>
    mutate(
        odds = (events + 0.5) / (N - events + 0.5)
    ) |>
    pull(odds) |>
    (\(x) x[2] / x[1])()
#> [1] 7.933333

# Firth's logistic regression
df |>
    mutate(N = N - events) |>
    pivot_longer(
        -group,
        names_to = "outcome",
        values_to = "N"
    ) |>
    mutate(
        outcome = as.integer(outcome == "events")
    ) |>
    logistf::logistf(
        outcome ~ group,
        data = _,
        weights = N,
        firth = TRUE
    ) |>
    coef() |>
    _[[2]] |>
    exp()
#> [1] 7.933333

# Jeffreys prior for beta-binomial model
df |>
    mutate(
        # posterior parameters
        alpha = events + 0.5,
        beta = N - events + 0.5,
        # posterior mean
        mean = alpha / (alpha + beta),
        # posterior odds
        odds = mean / (1 - mean)
    ) |>
    pull(odds) |>
    (\(x) x[2] / x[1])()
#> [1] 7.933333Biostatistics on the Table Это выглядит слишком хорошо, чтобы быть правдой. Не понимаю, почему метод так не популярен в биомедицине. suppressPackageStartupMessages({ library(tidyverse) library(logistf) }) set.seed(15321) n <- 150 p1 <- 0.015 p2 <- 0.03 x <- rep(0:1, each…
Forwarded from Sinекура

Maksim Kuznetsov Не ответ на вопрос, но в последнее время я обратил внимание, что очень часто в качестве учебника по статистике рекомендуют вот эту книгу https://www.routledge.com/Statistical-Inference/Casella-Berger/p/book/9781032593036

Forwarded from Maksim Kuznetsov
Biostatistics on the Table В рассматриваемом сценарии хотя бы в одной из групп не было событий в 1105 случаях, в обеих (!) группах не было событий в 10 случаях (да, в этих случаях мы тоже получили оценки эффекта, понятно, что это не очень информативно, но все же прикольно).
Biostatistics on the Table в одной из групп с 10% вероятностью событий не будет вовсе
Biostatistics on the Table Это выглядит слишком хорошо, чтобы быть правдой. Не понимаю, почему метод так не популярен в биомедицине. suppressPackageStartupMessages({ library(tidyverse) library(logistf) }) set.seed(15321) n <- 150 p1 <- 0.015 p2 <- 0.03 x <- rep(0:1, each…
na.rm = TRUE, все 10000 моделей сошлись и ДИ почти обеспечивают заявленную альфу (полуторапроцентное перепокрытие мне представляется даже чем-то хорошим с практической точки зрения).glm() с вальдовскими интервалами при такой ситуации запустить (вернее даже при более мягкой, здесь с glm в общем-то ловить совсем нечего).Biostatistics on the Table Это выглядит слишком хорошо, чтобы быть правдой. Не понимаю, почему метод так не популярен в биомедицине. suppressPackageStartupMessages({ library(tidyverse) library(logistf) }) set.seed(15321) n <- 150 p1 <- 0.015 p2 <- 0.03 x <- rep(0:1, each…

suppressPackageStartupMessages({
    library(tidyverse)
    library(logistf)
})

set.seed(15321)

n <- 150
p1 <- 0.015
p2 <- 0.03

x <- rep(0:1, each = n)
probs <- rep(c(p1, p2), each = n)

sim <- function() {
    df <- data.frame(
        x = x,
        y = rbinom(
            n = n * 2, size = 1,
            prob = probs
        )
    )

    fit <- logistf(
        y ~ x, data = df,
        pl = TRUE, firth = TRUE
    )

    c(
        n1 = sum(df$y[x == 0]),
        n2 = sum(df$y[x == 1]),
        beta = fit$coefficients[[2]],
        lcl = fit$ci.lower[[2]],
        ucl = fit$ci.upper[[2]],
        lrt = 1 - pchisq(-2 * diff(fit$loglik), df = 1)
    )
}

res <- replicate(10000, sim())

eff <- log((p2/(1 - p2))/(p1/(1 - p1)))

t(res) |>
    as_tibble() |>
    mutate(eff = eff) |>
    summarise(
        coverage = mean(between(eff, lcl, ucl)),
        power = mean(lrt.null < 0.05),
        `S-type` = mean(beta < 0 & lrt.null < 0.05),
        mean = mean(beta),
        true = mean(eff),
        bias = mean - true
)Forwarded from Evgeny Bakin