TGViewer
Channel Public Channel
Синтезиум AI

Синтезиум AI

@sinthesium

Навигатор в сфере аддитивных технологий. Даём выверенные ответы по материалам и технологиям, помогаем найти подрядчика или эксперта. Уникальный инструмент — генератор производственных идей нейросетью.

Связь:
@mentalcondensate
@bilenko
Subscribers
124
Photos
86
Videos
5
Links
58
Recent Posts 13 shown
Post #127 51
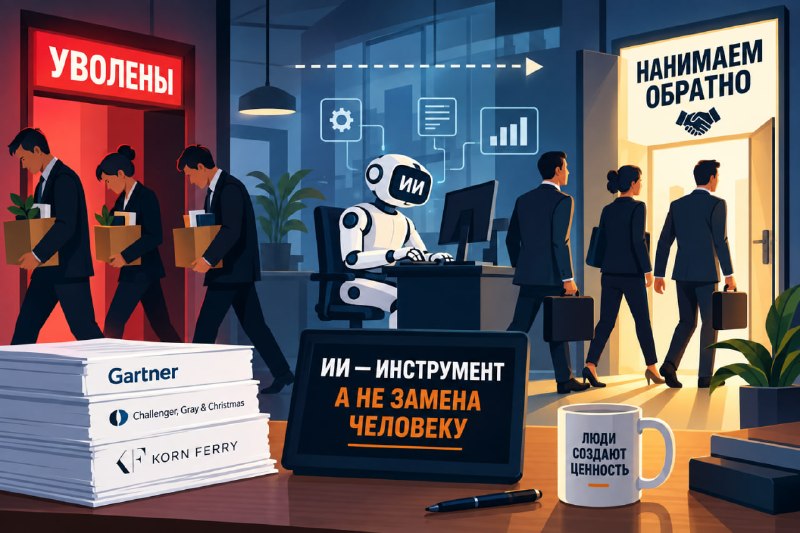
🤖❌ ИИ-сокращения обернулись ловушкой: почему компаниям придется нанимать уволенных обратно?

Агрессивные увольнения ради «эффективности ИИ» дают обратный эффект. Последняя аналитика от мировых консалтинговых агентств показывает, что бизнес начинает тонуть в сверхнагрузках и теряет способность к инновациям.

Собрали главные инсайты из оригинальных отчетов сентября 2026 года:

🔴 Gartner: 30% уволенных сотрудников вернут обратно
Компании массово совершают ошибку, воспринимая ИИ исключительно как способ оптимизации. Увольняя людей, бизнес теряет уникальные институциональные знания.
«К 2029 году до 30% работников, замещенных ИИ, компаниям придется нанимать заново — но уже на более высокие зарплаты, так как эффект от бездумного сокращения штата развернется в обратную сторону».
🔗 Источник: Gartner Identifies 4 Shifts Shaping the Future of Work

📉 Challenger, Gray & Christmas: ИИ — главная причина увольнений
В США искусственный интеллект держит лидерство среди причин сокращений уже 5 месяцев подряд.
«С начала 2026 года в США было объявлено о более чем 100 000 увольнений, где главной или сопутствующей причиной в корпоративных отчетах прямо указывалось внедрение ИИ».
🔗 Источник: Отчеты Challenger, Gray & Christmas

💼 Korn Ferry: Работа за двоих («The Two-Job Job»)
Автоматизация не облегчила жизнь оставшимся — скорее наоборот. По опросам 16 000 профессионалов, нагрузка только выросла, так как на людей переложили задачи уволенных коллег.
«62% оставшихся сотрудников отмечают резкий рост рабочей нагрузки, а 61% заявляют, что теперь им приходится совмещать сразу несколько ролей внутри компании, несмотря на внедрение ИИ-инструментов».
🔗 Источник: Korn Ferry Workforce Report

💡 Главный вывод: Слепая вера в то, что нейросети прямо сейчас могут полноценно заменить штат без потери качества, приводит к выгоранию оставшихся команд и остановке инноваций. ИИ — это мощный инструмент для улучшения возможностей человека, а не его замена на более дешевый "клон".

😎 { Синтезиум. Подписка }
  • 👍 2
  • 🔥 1
Post #126 1.59K
Мы ускоренно движемся к точке невозврата. Не будем поддаваться панике, но сегодня нужно твердо усвоить факт того, что нейросети все активнее проникают во все сферы нашей жизни. Например, последняя модель GPT 6 Astra (выпущена 3 сентября 2026) дает качественный прорыв в создании 3D LLM (нам, инженерам, хочется говорить уже именно так).

Инженеры из nTop протестировали Astra, использовав ее API для создания модели ДВС. Причем всего за 2 часа удалось построить параметрическую сборку и провести работы по созданию 100 двигателей разной мощности!

Источник: Bradley Rothenberg, CEO nTop

😎 { Синтезиум. Подписка }
  • 🔥 6
  • ❤ 2
Post #125 144
Магия, которую никто не программировал

Модель учили одному: угадывать следующее слово. Это единственное, что было заложено в задачу напрямую. Смысл разложился в пространстве в виде близких и далёких точек сам, как побочный эффект — этого никто отдельно не программировал. Модель не видела кота глазами и не знает, что такое мурлыканье в человеческом смысле. Но геометрически точка «кот» оказалась в нужном месте, рядом с лапами, шерстью, ветеринаром и мяуканьем, и для практических целей результат неотличим от знания.

Назвать это сознанием или пониманием в человеческом смысле нельзя. Точнее будет сказать так: из миллиардов чисто алгоритмических исправлений выросла структура, где смысл — это геометрическое расположение точек друг относительно друга. Люди веками объясняли необъяснимое через привычные образы: не понимали природу солнца, называли его богом; не понимали молнию — придумывали Зевса. С языковыми моделями работает похожий рефлекс: то, что устроено непрозрачно, легко принять за нечто большее, чем оно есть. Разобраться, что там внутри происходит на самом деле — лучший способ этот рефлекс обойти.

#LLMпросто

😎 { Синтезиум. Подписка }
  • 👍 5
Post #124 419
Вначале лепка, потом — 3D-печать

Компания Unbound создала интересный и уникальный инструмент под названием Loop: скульптинг объёмных SDF-форм с ИИ. На этапе грубой концепции пользователь размещает в пространстве примитивы, задавая их форму, размер и положение, а ИИ сразу достраивает вылепленную заготовку до нужного уровня реализма — добавляет цвет, детали и материал.

Вместо полигональной сетки, привычной 3D-художникам, программа использует объёмы, которые можно вытягивать, объединять, вычитать (привет, булевы операции!). ИИ-слой опирается на вылепленную геометрию и достраивает вокруг неё поверхность. Обновление идёт с частотой до 40 раз в секунду, и глаза попросту не успевают заметить задержку между движением и откликом.

В очереди на релиз — генерация видов с нескольких ракурсов по той же вылепленной модели (не только по промпту), правка изображений прямо в чате и интеграция с генератором Tripo, чей низкополигональный режим, по опыту команды Unbound, сразу отдаёт сетку для игрового движка без ручной доработки топологии.
По сравнению с классическим путём (Blender или Maya плюс отдельный игровой движок) Unbound, согласно собственному FAQ компании, сузила набор функций ради простоты взаимодействия, но импортировать готовую полигональную модель пока нельзя: вся геометрия рождается только из SDF с нуля.

Для геймдева это понятно сразу. Интереснее здесь то, что тот же принцип (лепка формы, ИИ достраивает поверхность, на выходе — сетка, пригодная и для 3D-принтера) ложится и на раннюю стадию промышленного проектирования: органическую форму, типичный результат топологической или иной оптимизации для АТ, в CAD с нуля собирают долго, а в SDF-скульптуре — интерактивно, за считанные минуты, прежде чем деталь передадут дизайнерам и инженерам на доводку — для получения геометрии, корректной с точки зрения CAD.

Источник: Андреа Интергульельми, сооснователь компании Unbound

😎 { Синтезиум. Подписка }
  • 🔥 5
Post #123 104
Как слова находят своих соседей

До обучения таблица весов заполнена случайными числами. У слова «кот» в этот момент нет ничего общего со словом «собака», как и вообще ни с чем: связи между точками ещё не существует. Модель в таком состоянии не умеет ничего.

Дальше берут гигантский объём текста — книги, статьи, форумы, значительную часть открытого интернета — и подают его модели маленькими кусками, прося угадать следующее слово. Модель отвечает наугад, потому что числа пока случайны. Ответ сверяют с правильным, и по разнице программа математически вычисляет, насколько каждое из миллиардов чисел виновато в ошибке и в какую сторону его нужно сдвинуть, чтобы в следующий раз промах на этом же фрагменте оказался чуть меньше. Сдвиг крошечный — сотые доли, — но повторяется он миллиарды раз, и обучение крупной модели занимает недели работы огромного количества компьютеров.

Слово «кот» за эти миллиарды примеров встречается в текстах миллионы раз, и почти всегда рядом с похожими соседями: мяукает, лапы, спит, мурлычет. Каждый раз, когда модель ошибается на такой фразе, строка чисел для «кота» получает маленькую поправку в сторону этих соседей. У слова «собака» соседи почти те же самые — лает, лапы, будка, — и поправки идут в ту же сторону. Не потому что кто-то запрограммировал их сходство, а потому что у слов оказались одинаковые соседи и, соответственно, одинаковые поправки. Точки сближаются сами, как побочный эффект миллиардов исправлений ошибки.

#LLMпросто

😎 { Синтезиум. Подписка }
  • 🔥 4
  • 👍 2
Post #122 98
Куда вкладывают слово

Таблица весов устроена как гигантская сетка: строк в ней столько же, сколько токенов в словаре (порядка 100 тысяч), а столбцов у типичной крупной модели — от нескольких сотен до нескольких тысяч, в зависимости от размера. Каждому токену соответствует своя строка чисел. Такой набор называют вектором, или эмбеддингом — от английского embedding, «вложение»: слово буквально вкладывается в числовое пространство. Термин прижился с 2013 года, после статьи команды Google под названием Word2Vec.

Одно число само по себе ничего не значит — ни направления, ни смысла. Но когда чисел несколько тысяч сразу, они работают как координаты точки. Две координаты — это точка на плоскости, школьные x и y. Три — точка в пространстве, вообразить которую ещё можно: маленький шарик, подвешенный в комнате. Пространство на несколько тысяч измерений вообразить нельзя, но математически оно работает так же: у каждой точки есть положение относительно всех остальных.

Смысл слова живёт в том, где точка этого слова оказалась относительно других точек. Слово «кот» — одна точка, «собака» — другая, «самолёт» — третья. В этом многомерном пространстве кот и собака оказываются рядом друг с другом: у обоих в соседях слова «лапы», «шерсть», «миска». Самолёт от них далеко — его соседи «крыло», «турбина», «взлётная полоса».

#LLMпросто

😎 { Синтезиум. Подписка }
  • 👍 2
Post #120 90
Как модель понимает слово «кот», ни разу его не увидев

Файл с весами модели Claude занимает несколько сотен гигабайт, у моделей поменьше — десятки. Это не JSON и не Excel, а плотно упакованные друг за другом миллиарды чисел с плавающей точкой. Их называют весами, или параметрами. Рядом с этим файлом лежит программа на Python, обычно пара тысяч строк кода, и умеет она ровно одно: брать числа из файла, перемножать и складывать их по строгим формулам.

Когда вы отправляете модели вопрос, программа режет текст на токены — куски слов, о которых чаще пишут отдельно, — и для каждого токена идёт в файл весов за его персональной строкой чисел.

Дальше эта строка проходит через все слои модели, где с ней происходят миллиарды операций, а на выходе получается распределение вероятностей: с какой вероятностью следующим должно идти каждое слово из словаря. Модель берёт самое вероятное и приклеивает к тексту. Потом повторяет то же самое для следующего слова, и так до конца ответа.

#LLMпросто

😎 { Синтезиум. Подписка }
  • 👍 2
  • 🔥 2
Post #117 93
Где ИИ на самом деле теряет деньги

Дефицит памяти и рост цен на жёсткие диски — заметный, но верхнеуровневый симптом. Реальная инженерная проблема глубже: стоимость обработки запроса у языковых моделей растёт не линейно с объёмом текста, а квадратично. Это конкретный механизм, а не абстракция. Современные языковые модели при обработке текста сопоставляют каждое слово со всеми остальными словами во входном фрагменте — так модель учитывает контекст. Вдвое длиннее текст — вчетверо больше таких сопоставлений, а значит и вычислений.

Для инженерных данных это проявляется не там, где кажется на первый взгляд. Извлечь с чертежа материал, допуски, посадки и шероховатость через OCR и распознавание сущностей — задача умеренного объёма, она не растёт квадратично сама по себе. Проблема начинается на следующем шаге: когда эти данные анализируются в контексте — сверяются с нормативной базой, с похожими деталями, с производственными картами, — объём текста в одном запросе к модели резко увеличивается. Компания, которая прогоняет через такой анализ не один чертёж, а сотню в месяц, увеличив объём контекста в десять раз, получает рост стоимости расчёта примерно в сто раз, а не в десять.

Здесь и находится развилка, которую разработчики ИИ-решений пока обходят стороной. Есть архитектуры, где основной расчёт не квадратичный: детерминированные алгоритмы и графовые модели дают ответ на основе фиксированной структуры данных, а не полного пересчёта моделью для каждого нового запроса. Показательный пример — «tiny recursive model» Алексии Жоликёр-Мартино из Microsoft: модель на порядки меньше типичной языковой модели победила на конкурсе логических задач ARC Prize за счёт другой вычислительной схемы, а не за счёт размера.

Отсюда практический ориентир при выборе ИИ-инструмента для производства. Стоит спросить у разработчика: растёт ли цена анализа линейно с объёмом данных или быстрее; пересчитывает ли система ответ заново моделью на каждый запрос, или ядро решения детерминированное; и что произойдёт со стоимостью, если объём задач вырастет в десять раз — пропорционально или кратно быстрее.

Источник: Alex Reisner, The Atlantic

😎 { Синтезиум. Подписка }
  • 🔥 2
Post #116 86
Как проходит твой суббота, друг?🤓
Post #111 105
Как утилита для сжатия файлов случайно стала сердцем GPT

Метод, которым сегодня режут текст на токены все крупные модели (GPT, Claude, Gemini), придумал программист из Колорадо-Спрингс Филип Гейдж. Еще в феврале 1994 года он опубликовал в журнале статью «Новый алгоритм для сжатия данных». Задача была бытовой: как сжать файл на диске. Предложенное им решение состояло в поиске в файле самой частой пары байтов и замене её одним символом. И название он придумал подходящее: Byte Pair Encoding, сокращённо BPE.

Дальше на 21 год об этой разработке все забыли. Казалось, что она была ничем не примечательна: одна из сотен похожих алгоритмов сжатия. Потом идею открывали заново трижды и каждый раз для другой задачи.

В 2012-м инженеры Google Майк Шустер и Кайсуки Накадзима искали способ распознавать голос на японском и корейском, где нет пробелов между словами, и пришли почти к тому же решению под именем WordPiece. В 2015-м команда Эдинбургского университета наткнулась на статью Гейджа, разбирая задачу машинного перевода, и впервые применила BPE не для сжатия, а для сборки словаря частей слов. Точку поставила OpenAI в 2019-м, встроив доработанный BPE в GPT-2 — с этого момента подход стал отраслевым стандартом.

Три команды, три разные задачи — сжатие файлов, голосовой поиск, машинный перевод — и ни одна из них не думала об искусственном интеллекте. Редкий случай, когда узкая инженерная идея переживает свою исходную область целиком: от экономии места на диске до основы, по которой сегодня считается стоимость работы нейросети для пользователя.

Похожих историй в технологиях немало, когда идея ждёт своего контекста годами, иногда десятилетиями, и находит его там, где её совсем не искали.

#LLMпросто

😎 { Синтезиум. Подписка }
  • 👍 2
  • 🔥 1
Post #107 88
За что на самом деле платят нейросети

Внутри компьютера нет ни одной буквы — только числа. Процессор — это набор транзисторов, и у каждого два состояния: 0 и 1, и буквы туда просто не помещаются. Поэтому ещё до того, как текст попадает в модель, стандарт UTF-8 переводит каждый символ в число. Например, слово cat (кот) превращается в три байта — 99, 97, 116.

Работать с текстом побайтово моделям невыгодно: страниц миллионы, а каждая буква — отдельная операция. Поэтому перед моделью стоит токенизатор — программа, которая склеивает часто встречающиеся сочетания букв в один блок. Пушистый cat из трёх байтов превращается в один токен под своим номером. Словарь этих кусков и правила их склейки хранятся в двух простых файлах на сервере и собираются один раз, при подготовке модели — дальше с ними работают все пользователи мира.

Отсюда и ответ на вопрос из заголовка. Токен — единственная единица, с которой модель реально имеет дело внутри себя. На каждый токен уходит отдельный проход через все слои модели — миллиарды перемножений чисел. Поэтому в ценах на API всегда два тарифа, и output (выход) дороже input (входа): ответ модель считает токен за токеном, каждый через полный вычислительный цикл.

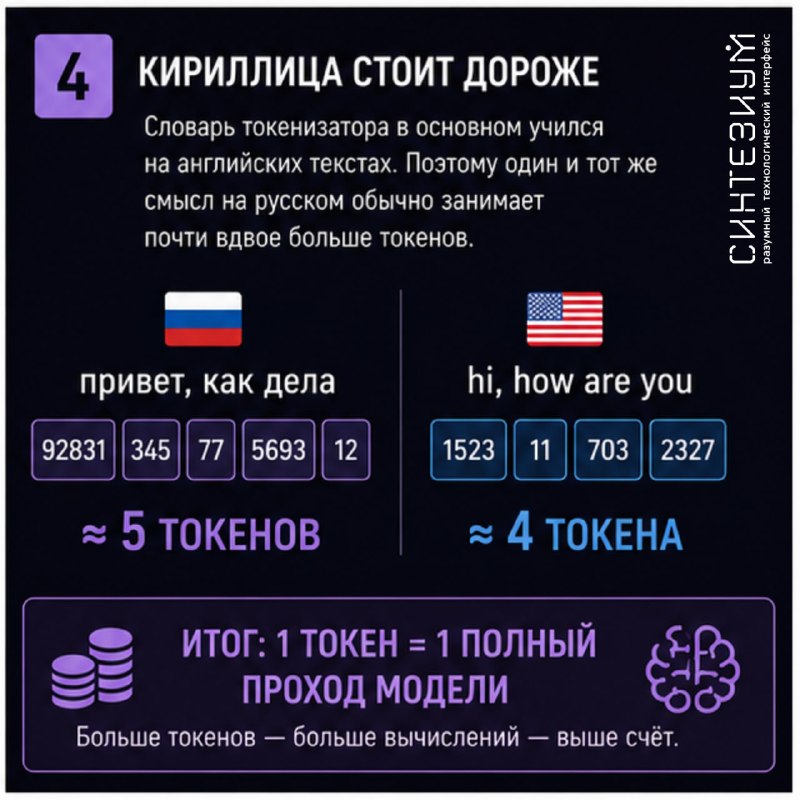
Здесь же прячется деталь, о которой редко говорят. Кириллица режется на токены хуже латиницы: словарь токенизатора в основном учился на английских текстах, и один и тот же смысл на русском обычно занимает почти вдвое больше токенов. Написали по-русски «привет, как дела» — заплатили примерно вдвое больше, чем за ту же фразу на английском.

#LLMпросто

😎 { Синтезиум. Подписка }
  • 🔥 2
  • ❤ 1
Older posts →

About this channel

How can I read @sinthesium without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Синтезиум AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Синтезиум AI have?
Синтезиум AI (@sinthesium) has 124 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Синтезиум AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →