За что на самом деле платят нейросети
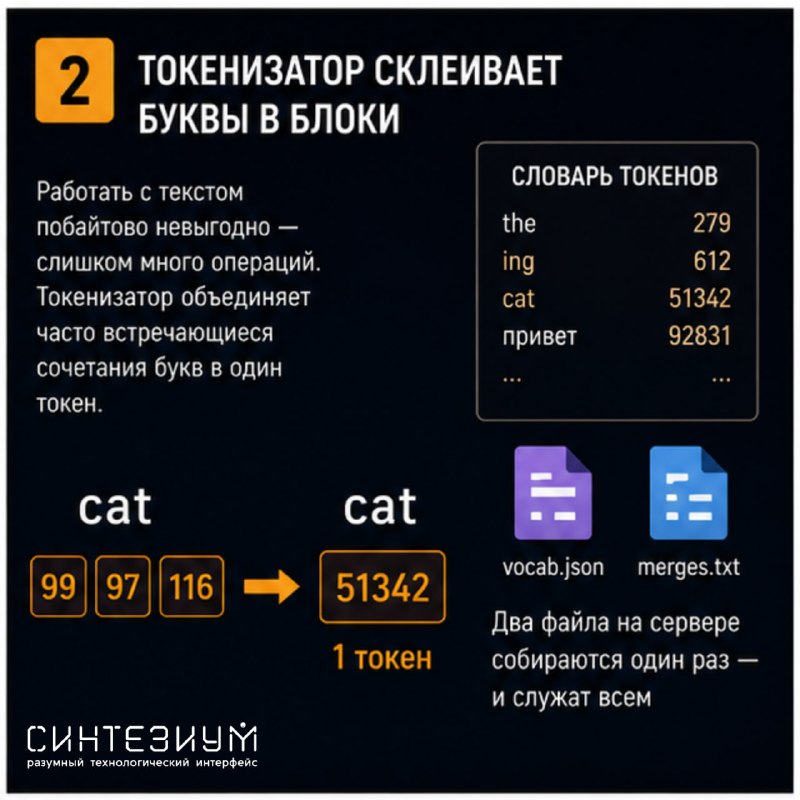
Внутри компьютера нет ни одной буквы — только числа. Процессор — это набор транзисторов, и у каждого два состояния: 0 и 1, и буквы туда просто не помещаются. Поэтому ещё до того, как текст попадает в модель, стандарт UTF-8 переводит каждый символ в число. Например, слово cat (кот) превращается в три байта — 99, 97, 116.
Работать с текстом побайтово моделям невыгодно: страниц миллионы, а каждая буква — отдельная операция. Поэтому перед моделью стоит токенизатор — программа, которая склеивает часто встречающиеся сочетания букв в один блок. Пушистый cat из трёх байтов превращается в один токен под своим номером. Словарь этих кусков и правила их склейки хранятся в двух простых файлах на сервере и собираются один раз, при подготовке модели — дальше с ними работают все пользователи мира.
Отсюда и ответ на вопрос из заголовка. Токен — единственная единица, с которой модель реально имеет дело внутри себя. На каждый токен уходит отдельный проход через все слои модели — миллиарды перемножений чисел. Поэтому в ценах на API всегда два тарифа, и output (выход) дороже input (входа): ответ модель считает токен за токеном, каждый через полный вычислительный цикл.
Здесь же прячется деталь, о которой редко говорят. Кириллица режется на токены хуже латиницы: словарь токенизатора в основном учился на английских текстах, и один и тот же смысл на русском обычно занимает почти вдвое больше токенов. Написали по-русски «привет, как дела» — заплатили примерно вдвое больше, чем за ту же фразу на английском.
#LLMпросто
😎 { Синтезиум. Подписка }
Post #107
90



- 🔥 2
- ❤ 1