TGViewer
Channel Public Channel
Silicon Brain | جامعه هوش مصنوعی

Silicon Brain | جامعه هوش مصنوعی

@silicon_brain

مغز سیلیکونی|جامعه هوش مصنوعی
اولین رسانه فنی و به روز هوش مصنوعی در تلگرام

گروه بحث و تبادل نظر:
https://t.me/+SWbgmMZt0XU0MGY0

مطالب و بحث های بیشتر در اینستاگرام:
https://www.instagram.com/silicon_brain/

ارتباط با ادمین:
@silicon_brain_admin
Subscribers
7.73K
Photos
1.1K
Videos
131
Links
574
Recent Posts 19 shown
Post #2194 752
به متن‌های ChatGPT یک Watermark اضافه شده!

شرکت OpenAI قابلیتی به اسم textGrain معرفی کرده که داخل متن تولیدشده توسط ChatGPT و Codex یک Invisible Watermark قرار می‌ده. شبیه یک Digital Fingerprint که با تغییرات خیلی ظریف در انتخاب کلمات، یک الگوی آماری مخفی ایجاد می‌کنه

کاربر چیزی نمی‌بینه یا حس نمی‌کنه، ولی یک Detector می‌تونه تشخیص بده که متن احتمالاً توسط OpenAI تولید شده.

این Watermark اطلاعاتی درباره کاربر، حساب کربری یا پرامپ نمی‌ده و فقط منشأ احتمالی متن رو مشخص می‌کنه. در حوزه اروپا این قابلیت به‌صورت خودکار فعال می‌شه، ولی در API خارج از اروپا فعلاً به‌صورت Opt-in ارائه می‌شه و Detector هم فعلاً فقط در اختیار محقق ها و سازمان‌های تأییدشده است.

البته یک محدودیت مهم داره: اگر حدود ۲۵٪ کلمات متن تغییر کنه، Detection Rate به حدود ۱۷٪ می‌رسه و برای متن‌های کوتاه یا ترجمه‌شده هم تشخیص سخت‌تره. با این حال، این قابلیت می‌تونه مسیر رو برای اعتبار سنجی محتوای AI در محصولاتی که برای بازار اروپا ساخته می‌شن جدی‌تر کنه.
لینک
@silicon_brain | از هوش مصنوعی عقب نمانید
  • 👍 8
  • ❤ 1
  • 👎 1
Post #2192 778
Silicon Brain | جامعه هوش مصنوعی احتمالاً نسل بعدی اپلیکیشن‌ها دیگه لزوماً روی سایت‌ها و اپلیکیشن‌های مستقل ساخته نمی‌شن، بلکه داخل پلتفرم‌های AI مثل ChatGPT شکل می‌گیرن. تصور کنین به‌جای اینکه برای هر کاری برید سراغ یک سایت یا اپلیکیشن جدا، همون‌جا داخل ChatGPT درخواستتون رو مطرح کنید و…
به نظرتون تو این شرایط اگه یه مشکلی فنی، حقوقی یا هر مشکل دیگه پیش بیاد، مسئول بررسی و رفع مشکل کیه؟

مثلاً اگه یه سرویس از طریق یک AI Platform یا Agent در اختیار کاربر قرار گرفته و تراکنش یا درخواست با خطا مواجه بشه، سرویس‌دهنده باید مشکل رو بررسی کنه؟ پلتفرم واسط؟ یا خود AI Agent یا چی؟!
آیا باید یه استاندار جدید تعریف بشه؟
میتونه موضوع ریسرچ باشه :)
  • 👍 4
  • 👏 1
Post #2191 793
احتمالاً نسل بعدی اپلیکیشن‌ها دیگه لزوماً روی سایت‌ها و اپلیکیشن‌های مستقل ساخته نمی‌شن، بلکه داخل پلتفرم‌های AI مثل ChatGPT شکل می‌گیرن.

تصور کنین به‌جای اینکه برای هر کاری برید سراغ یک سایت یا اپلیکیشن جدا، همون‌جا داخل ChatGPT درخواستتون رو مطرح کنید و سرویس موردنظر رو دریافت کنید.

مثلاً:

◽️برای فردا یک بلیت هواپیما به تهران پیدا کن و سرویس‌های بلیط‌دهی از داخل پلتفرم AI کارشون رو انجام بدن.
▫️این محصول رو با بهترین قیمت برام پیدا کن و سفارش بده
فروشگاه‌ها و سرویس‌های پرداخت پشت صحنه این پلتفرم وارد عمل میشن

چطور اینکار انجام میشه؟ به نظرم از طریق توسعه سرویس MCP برای بیزینس‌ها


تو این شرایط، شاید مسئله برای خیلی از بیزینس‌ها دیگه این نباشه که چطور کاربر رو به سایت خودمون بیاریم؟
بلکه این باشه که چطور کاری کنیم AI سرویس ما رو به کاربر پیشنهاد بده و از طرف اون اجراش کنه؟

و این می‌تونه بازی رو برای خیلی از کسب‌وکارهای فعلی کاملاً عوض کنه.

@silicon_brain | از هوش مصنوعی عقب نمانید
  • 👍 14
  • ❤ 2
Post #2190 841
The guy who gave up on programming in 2023 :)
  • 😁 6
  • 👍 3
  • 😢 1
Post #2189 730
همانطور که تو ویدیو پست قبلی مشخصه، می‌تونی سناریوهای خیلی متنوع کاربردی با Routapse بسازی و حتی تو پروداکت های مختلف ازش استفاده کنی.
چند تا مثال کاربردی:
Cost Optimization (کاهش هزینه هوشمند)

پرامپت‌های ساده و روزمره (سلام، FAQ، جستجوی ساده) برن سراغ مدل‌های کوچک و ارزون (یا حتی بدون فراخوانی مدل جواب داده بشن). فقط پرامپت‌های پیچیده و سنگین برن سراغ مدل‌های قوی و گرون. نتیجه؟ هزینه توکن خیلی کمتر می‌شه بدون اینکه کیفیت کلی سیستم افت کنه.
Multi-Agent Specialist

دسته‌بندی‌های مختلفی تعریف کنی:
اگر نیاز به کدنویسی بود: مدل Coder
اگر نیاز به نوشتن داستان یا محتوا بود: مدل Writer
اگر نیاز به تحقیق و تحلیل بود:مدل Researcher
اگر نیاز به بررسی حقوقی بود: مدل Legal
روتر خودش تشخیص می‌ده و پرامپت رو با System Prompt مخصوص همون Agent صدا می‌زنه.
Support Triage با Escalate

تیکت‌های پشتیبانی رو اول از نظر اضطرار و churn risk امتیاز می‌ده. اگر مشتری عصبانی یا در خطر از دست رفتن باشه، مستقیم به اپراتور انسانی یا مدل خیلی قوی escalate می‌شه. در غیر این صورت با مدل ارزون‌تر هندل می‌شه.
Local-First برای داده‌های حساس

هر درخواستی که شامل اطلاعات محرمانه یا PII باشه، فقط روی مدل محلی (Ollama) اجرا می‌شه. بقیه درخواست‌ها می‌تونن برن کلاد. حریم خصوصی حفظ می‌شه و همزمان از قدرت مدل‌های ابری هم استفاده می‌کنی.
Guardrail قبل از پرداخت هزینه

درخواست‌های نامناسب، اسپم یا خارج از حوزه رو قبل از اینکه هیچ LLMی صدا زده بشه، با پاسخ ثابت رد یا هدایت می‌کنه. هم هزینه صرفه‌جویی می‌شه هم کنترل بیشتری داری.

و کلی سناریو دیگه که میتونین با این پروژه بسازین و تو پروژه های مختلف خودتون استفاده کنین
گیتهاب
  • 👍 4
  • ❤ 1
Post #2188 653
پروژه Routapse کمک می‌کنه هر نیاز رو به LLM مناسب ارجاع بدی

این پروژه رو بعد از معرفی مدل‌های Decider مثل Jev و Laya شروع کردم و الان به صورت اوپن‌سورس تو گیتهاب در دسترسه.
ایده اصلی

با مدل‌هایی مثل Jev و Laya به عنوان Decider Model می‌شه قبل از ارسال درخواست به LLM اصلی، درخواست رو تحلیل و کلاس‌بندی کرد و باعث کاهش هزینه بشه
یعنی می‌تونیم برای هر Request سیگنال‌ها و Classificationهای مختلفی داشته باشیم؛ مثلاً:
▫️ نوع درخواست
▫️ میزان پیچیدگی
▫️ حساسیت داده
▫️درخواست با کدوم Agent پردازش بشه

نسبت به نیازت می‌تونی هم در سطح Decider و هم در سطح LLM انتخاب کنی که مدل Local (مثل Ollama) باشه یا مدل کلاد (OpenAI، Claude، Gemini و ...). یعنی کاملاً کنترل داری که داده‌های حساس فقط روی مدل محلی بمونن و بقیه برن کلاد.
معماری و دسترسی

سرویس هم به صورت API (کاملاً سازگار با OpenAI SDK) و هم به صورت GUI در دسترسه. از طریق رابط گرافیکی می‌تونی روترها رو با زبان طبیعی تعریف کنی، تست کنی و لاگ‌ها رو ببینی.

در مور کاربردهای خفن پروژه در ادامه میگم...
گیتهاب
لطفا با ⭐️ گیتهاب از این پروژه اوپن سورس حمایت کنین
  • 👍 6
  • 😍 1
Post #2186 845
این از وضعیت مملکت
اون از وضعیت جهانی مارکت IT
یه دغدغه شخصی کوچولو هم داشته باشی
دیگه چیزی ازت نمیمونه برنامه‌نویس بدبخت😂
  • 👍 11
  • 💔 5
  • 👎 1
Post #2185 885
‏Imajev یه پروژه جالب توی خانواده Decision Modelهاست که ایده‌ی Jev رو یک قدم جلوتر می‌بره: به‌جای اینکه فقط Text + State بگیره، می‌تونه Image + State + Text رو با هم بررسی کنه و در نهایت به‌جای تولید متن، بین گزینه‌هایی که خودت تعریف کردی احتمال بده.
فنی

از نظر معماری، Imajev روی مدل‌های Qwen3.5 در سه سایز 2B، 4B و 9B ساخته شده و با LoRA به یک Decision Readout مجهز شده. برای هر گزینه یک کد مشخص در نظر گرفته میشه و مدل با یک Forward Pass احتمال گزینه‌ها رو محاسبه می‌کنه بنابراین برخلاف LLMهای معمولی، لازم نیست جواب رو Token به Token تولید کنه. یک گزینه‌ی unknown هم به‌صورت First-class داخل مدل وجود داره تا وقتی Evidence کافی نیست، مدل مجبور به حدس زدن نباشه.

قسمت جذاب‌ترش Multimodal Decision Making هستش، مثلاً می‌تونی اطلاعات یک محصول رو به مدل بدی و همراهش عکس محصول رو بفرستی و بپرسی «کدوم فیلد این رکورد با عکس تناقض داره؟». این یعنی میشه ازش برای Quality Control، بررسی محصول و سند و خیلی چیزای دیگه استفاده کرد.


اگر مدل برای یک تصمیم 0.95 Confidence داره، سیستم میتونه با اطمینان بیشتری Action انجام بده و اگر Confidence پایین بود، تصمیم رو به یک LLM قوی‌تر یا انسان منتقل کنه. در Benchmark خود پروژه، مدل 4B در بعضی تست‌ها حدود 84٪ Accuracy گرفته و در Image JevBench هم رتبه اول گزارش شده. البته این نتایج توسط سازندگان/benchmarkها گزارش شده و برای انتخاب Production بهتره روی Dataset خودت هم تست بشه.

@silicon_brain | از هوش مصنوعی عقب نمانید
  • 👍 9
  • ❤ 1
Post #2182 903
‏Perplexity هم وارد دنیای Decision Modelها شد

مدل جدید ‏Perplexity با اسم pplx-decider-v1-27b، شروع رقابت این شرکت با مدل های تصمیم گیر دیگه مثل Laya و Jev هست.

از نظر فنی، این مدل یک Fine-tuned Qwen3.8-27B هستش و حدود 26B Parameters داره. Perplexity لایه Language Generation رو با یک Decision Readout جایگزین کرده که تا 255 گزینه رو می‌تونه بررسی کنه. خروجی هم شامل Probability Distribution هست، یعنی سیستم می‌فهمه یک تصمیم با چه میزان Confidence گرفته شده. برای Calibration هم یک Temperature جداگانه روی مدل تنظیم شده.

جالب‌تر اینکه Perplexity مدل رو با 11 Benchmark مقایسه کرده و امتیاز کلی 85.71٪ برای pplx-decider در مقابل 74.76٪ برای Qwen3.8-27B پایه گزارش کرده. در همون جدول، امتیاز Jev برابر 84.51٪ بوده؛ البته این اعداد توسط خود Perplexity و در شرایطی که لزوماً کاملاً یکسان نیستند به‌دست اومدن، پس نباید صرفاً از این جدول نتیجه گرفت که یکی قطعاً بهتره.

نکته مهم اینه که Perplexity برخلاف Jev، Weights رو Open-source کرده؛ بنابراین می‌شه مدل رو Self-host کرد. البته با حدود 26B پارامتر و نیاز اعلام‌شده به تقریباً 49GB GPU Memory، این مدل در دسته مدل‌های Local سبک مثل Laya قرار نمی‌گیره و برای اجرای Local به سخت‌افزار نسبتاً قدرتمندی نیاز داره.

به‌نظر میاد Decision Modelها دارن کم‌کم به یک بخش مستقل از AI Stack تبدیل می‌شن و از این به بعد این فرمونو پیش خواهیم رفت:
Rules → Decision Models → LLMs

@silicon_brain | از هوش مصنوعی عقب نمانید
  • 👍 7
  • 😍 2
Post #2181 869
What is the Jev Architecture?

@silicon_brain | از هوش مصنوعی عقب نمانید
  • 👍 5
  • ❤ 1
Post #2180 1.07K
‏Anthropic برای Claude Code یک سیستم جدید به اسم Mod اضافه کرده که باهاش می‌تونی Pluginهای کوچیک TypeScript بنویسی و مستقیماً وارد Agent Loop بشن، رفتار Claude رو تغییر بدن یا حتی Custom UI بسازن. یه جورایی مثل Browser Extension هستش ولی برای AI Coding Tool.


چند نمونه جالبش هم از قبل آماده شده: Blast Radius قبل از اجرای Commandهای خطرناک مثل rm -rf یا git reset --hard نشون می‌ده چه چیزهایی تحت تأثیر قرار می‌گیرن و تأیید می‌گیره، همینطور Token Weather میزان مصرف Context Window رو نشون می‌ده و Replay Theater تمام تغییرات فایل‌ها توسط Claude رو ضبط می‌کنه تا بتونی با /replay تغییرات رو یکی‌یکی بررسی کنی.

ساختن Mod هم فقط با یک فایل TypeScript و چند تا Hook انجام می‌شه و حتی می‌تونی از خود Claude بخوای برات بسازتش. نصبش هم از طریق /plugin در CLI یا Desktop App انجام می‌شه.

فقط یه نکته مهم اینه که Modها دسترسی کامل به سیستم دارن، درست مثل خود Claude Code پس فقط از Sourceهایی نصبشون کنین که بهشون اعتماد داری.

لینک

@silicon_brain | از هوش مصنوعی عقب نمانید‏
  • 👍 3
  • ❤ 1
Post #2179 1.13K
اگه دقت کرده باشین، این روزها توی سوشال مدیا یه نوع محتوا خیلی ترند شده:

سؤال‌های مصاحبه برای انواع پوزیشن‌های شغلی

جالبه که تا چند سال پیش، این حجم از محتوا درباره‌ی Interview Questions رو کمتر می‌دیدیم اون هم در شرایطی که پوزیشن‌های برنامه‌نویسی و حوزه‌ی Tech اتفاقاً خیلی داغ‌تر بودن.

به نظرم یکی از دلایل اصلیش وضعیت بد فعلی Job Market و فشاریه که به متخصص‌های این حوزه وارد شده. خیلی‌ها حتی با داشتن مهارت و تجربه مناسب، بعد از چندین مرحله مصاحبه در نهایت استخدام نمی‌شن.

طبیعیه که وقتی این اتفاق زیاد تکرار می‌شه، تقاضا برای محتوایی مثل «سؤالات مصاحبه»، «چطور برای مصاحبه آماده بشیم؟» و «چطور Technical Interview رو پاس کنیم؟» هم بیشتر بشه و در نتیجه تولید این نوع محتوا در یوتوب و اینستا بیش از اندازه بشه

ولی الان مشکل فراتر از توانایی‌های فردیه: مشکل خود بازار کاره.

@silicon_brain | از هوش مصنوعی عقب نمانید‏
  • 👍 9
  • 👏 3
  • ❤ 1
Post #2178 1.18K
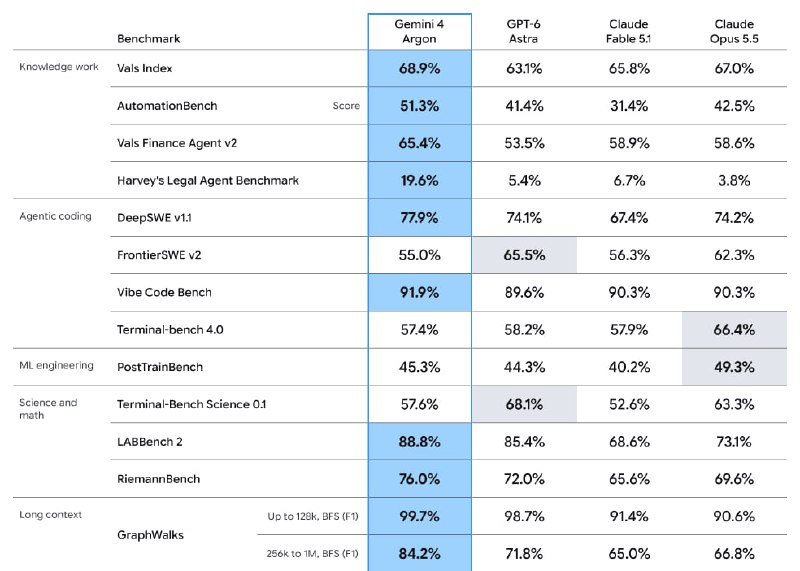
گوگل DeepMind از Gemini 4 Argon رونمایی کرد

مدل Gemini 4 Argon، قدرتمندترین مدلشون تا الان، ولی فعلاً دسترسی عمومی بهش وجود نداره و فقط از طریق Fairwind Program در اختیار متخصصان تأییدشده‌ی Cybersecurity و بعضی سازمان‌های مورداعتماد قرار گرفته.

مهم‌ترین ویژگی این مدل، 1 Million Output Tokens هست. مدل‌های قبلی Gemini حداکثر حدود 64K Token خروجی می‌دادن، اما Argon می‌تونه تا یک میلیون Token در یک Response تولید کنه یعنی برای کارهای خیلی طولانی و چندمرحله‌ای مثل Codebase Migration، تحلیل Legal Documentهای بزرگ و Security Audit طراحی شده.

از قابلیت‌های دیگه‌ش هم می‌شه به پیدا کردن، بررسی و Patch کردن تهدیدات نرم‌افزاری به‌صورت خودکار انجام کارهای واقعی Software Engineering با 20 زبان برنامه‌نویسی و پردازش End-to-End کارهای Legal، Financial و Enterprise اشاره کرد.

قیمت گذاری

قیمتش هم از $2 به‌ازای هر یک میلیون Input Token و $10 برای یک میلیون Output Token شروع می‌شه، البته برای استفاده عمومی فعلاً باید منتظر بمونیم.
بلاگ گوگل

@silicon_brain | از هوش مصنوعی عقب نمانید‏
  • ❤ 3
  • 👍 2
Post #2177 1.22K
مدل GPT-6.1 Sol رو با هزینه خیلی کمتر

شرکت OpenAI مدل GPT-6.1 Sol رو معرفی کرده که هدفش اینه تقریباً به سطح مدل پرچم‌دار Astra نزدیک بشه، ولی با هزینه خیلی پایین‌تر. این مدل مخصوصاً توی Coding، تحلیل Document و کارهای چندمرحله‌ای پیشرفت کرده.

عملکرد

تسک Coding: عملکرد مشابه Astra با هزینه حدود $0.65 به‌ازای هر Task در مقابل $3.92 برای Astra

تسک Computer Use: فقط حدود ۲ امتیاز پایین‌تر از Astra، ولی با حدود یک‌هفتم هزینه
تسک Science/Terminal : حدود $5.47 برای هر Task در مقابل $23.80
تسک Cached Input: فقط $0.10 به‌ازای هر میلیون Token

نکته مهم‌تر Caching هست، یعنی وقتی بخش‌هایی از Prompt مرتب تکرار می‌شن، لازم نیست هر بار هزینه کاملشون رو بدی. طبق این اطلاعات، Cached Input نسبت به قیمت معمول 95٪ ارزان‌تر شده.

در نتیجه Sol بیشتر برای جایی جذابه که تعداد زیادی AI Task داری و می‌خوای بین Performance، Latency و Cost تعادل بهتری ایجاد کنی.


@silicon_brain | از هوش مصنوعی عقب نمانید‏
  • 👍 4
  • ❤ 2
Post #2175 1.18K
احتمالا میدونین که LangChain ابزارهای لازم برای کار با LLM رو فراهم می‌کنه، ولی LangGraph منطق و جریان اجرای Agent رو مدیریت می‌کنه.

چند سؤال رایج در مورد این ۲ فریمورک

آیا LangGraph جای LangChain رو می‌گیره؟

نه. این دو رقیب مستقیم نیستن. حتی می‌تونی داخل یک Graph از Componentهای LangChain استفاده کنی.

برای یک RAG ساده کدوم بهتره؟

معمولاً LangChain کافی و ساده‌تره.

برای Multi-Agent یا Agentهای پیچیده چی؟

در این موقعیت LangGraph مناسب‌تره، چون State، Loop، Branching و کنترل اجرای Workflow رو بهتر مدیریت می‌کنه.

پس LangChain قدیمی شده؟

نه. نقش‌شون متفاوت‌تر شده. LangChain بیشتر در لایه‌ی LLM Components/Integrations کار می‌کنه و LangGraph در لایه‌ی Agent Orchestration/Control Flow کاربرد داره.

برای Production باید حتماً از LangChain استفاده کنیم؟

نه. اینا Framework هستن، نه الزام. اگر Workflow ساده باشه، گاهی استفاده مستقیم از APIهای مدل و چند ابزار سبک، ساده‌تر و کم‌هزینه‌تره.
@silicon_brain | از هوش مصنوعی عقب نمانید
  • ❤ 7
  • 👍 6
Post #2174 1.14K
چطور مدل های نوظهوری مثل Jev و Laya با مدل های LLM قدرتمند میتونن در ارتباط باشن؟

حتما میدونین که LLMهای Autoregressive خروجی رو توکن به توکن تولید می‌کنن این برای Reasoning، Coding و Generation عالیه، ولی برای تصمیم‌هایی مثل این که :
▫️درخواست به کدوم Agent بره؟
▫️از بین این ۵ ابزار کدوم انتخاب بشه؟ یا کدوم جواب بهتره؟

عملاً زیادی سنگینه اما Jev در خروجی می‌تونه مستقیماً یک مقدار Typed مثل billing باشه، نه یک متن که بعداً مجبور باشیم Parseش کنیم.

از نظر معماری، این تفاوت مهمه چون Jev خروجی رو به‌صورت Parallel تولید می‌کنه، نه Token-by-Token. طبق اطلاعات متن، TypeSafe برای Jev حدود 70–500ms End-to-End Latency و هزینه حدود $0.042 به ازای یک میلیون Input Token گزارش کرده و ادعا می‌کنه برای Queryهای مشابه، می‌تونه نسبت به Frontier LLMها حدود 40 تا 200 برابر Latency کمتر داشته باشه.

همچنین با RLCD (Reinforcement Learning for Calibrated Decisions) تلاش شده Confidence مدل معنادار باشه؛ مثلاً سیستم بین یک تصمیم با Confidence=0.99 و 0.52 تفاوت بذاره و موارد نامطمئن رو به یک LLM قوی‌تر یا Human Reviewer منتقل کنه.

یک نکته فنی مهم هم اینه که Jev جلوی اشتباه تصمیم‌گیری رو نمی‌گیره، جلوی اشتباه در Format خروجی رو می‌گیره. چون خروجی به Schema محدود شده، مدل نمی‌تونه وسط پاسخ چیز نامرتبط تولید کنه؛ ولی اگر کاندیدهای اشتباه بهش بدی، طبیعتاً نمی‌تونه گزینه‌ای خارج از اون‌ها انتخاب کنه. بنابراین طراحی Candidate Space خودش بخشی از مهندسی سیستم محسوب میشه.

حالا Laya چی میگه؟ Laya یک Open-source System One-style Model با حدود 421M Parameters هست که بر پایه ModernBERT + Decision Head ساخته شده. State و Typed Question رو می‌گیره و گزینه‌ها رو در یک Single Forward Pass Score می‌کنه. نکته جذابش اینه که می‌تونه به‌عنوان یک Decision Layer در معماری‌هایی که برای Jev طراحی شدن قرار بگیره. طبق متن، توسعه‌دهندگان Laya حدود 33ms inference روی Tesla T4 گزارش کردن البته این عدد مستقیماً با End-to-End Latency سرویس Jev قابل مقایسه نیست.

پس ایده اصلی این نیست که «یک مدل جدید جای GPT رو می‌گیره»؛ ایده اینه که دیگه مجبور نباشیم برای هر عملیات هوشمند، یک General-purpose LLM رو اجرا کنیم. با ترکیب Rules + Decision Models + Generative Models میشه AI Systemهایی ساخت که هم سریع‌تر، ارزان‌تر و قابل‌کنترل‌تر باشن و هم LLMهای بزرگ فقط جایی استفاده بشن که واقعاً به Reasoning و Generation نیاز داریم.

@silicon_brain | از هوش مصنوعی عقب نمانید
  • ❤ 4
  • 👍 2
Post #2173 1.14K
یکی از دغدغه های هر روزم اینه هرچی میخونم و یاد میگیرم رو اینجا شیر کنم 😁
تا از هوش مصنوعی عقب نمانید :)
  • ❤ 24
  • 👍 6
  • 😍 2
Post #2171 1.35K
مدل ‏Laya

تقریباً همون کاربردی رو داره که اخیراً درباره Jev گفتیم، یعنی یک مدل سبک برای Decision Making سریع داخل AI Agentها، مخصوصاً برای تصمیم‌های پرتعداد و لحظه‌ای ساخته شده...

اما تفاوت مهمش اینه که Laya رو میشه Local اجرا کرد و وابسته به API خارجی نیست و می‌تونه برای Browser Agent، Automation، Routing و کلی کاربرد دیگه به‌عنوان یک Decision Layer سریع و کم‌هزینه استفاده بشه که این خیلی خفنش میکنه

مقایسه Laya با Jev رو تو نمودار میبینین که خیلی جذاب به نظر میرسه. در موردش بیشتر خواهم گفت
هاگینگ فیس | گیتهاب
@silicon_brain | از هوش مصنوعی عقب نمانید
  • 👍 9
  • 😍 4
  • ❤ 1
Post #2170 1.16K
یه نفر تونسته یک Nokia 6300 مدل 2007 رو با 8MB RAM به Claude وصل کنه!

مشکل این بود که این گوشی‌های قدیمی از نسخه خیلی قدیمی HTTPS استفاده می‌کنن و سرورهای امروزی قبولش نمی‌کنن.

راه‌حلی که استفاده کرده این بوده که یک Go Server ساخته بشه که نقش مترجم رو بازی کنه؛ گوشی با پروتکل قدیمی به Server وصل میشه و Server با Modern HTTPS با Claude API ارتباط می‌گیره.

حالا با همون گوشی میشه با Claude چت کرد، Web Search، آب‌وهوا و Exchange Rate گرفت، رویداد به تقویم اضافه کرد و حتی جواب‌های طولانی رو صفحه‌به‌صفحه خوند.

کل پروژه هم Open Source شده و برای اجرا فقط به یک VPS ارزون، Docker و یک Nokia قدیمی سری 40 نیاز داری.
گیتهاب
@silicon_brain | از هوش مصنوعی عقب نمانید
  • 😁 14
  • 👍 6
  • ❤ 3
Older posts →

About this channel

How can I read @silicon_brain without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Silicon Brain | جامعه هوش مصنوعی: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Silicon Brain | جامعه هوش مصنوعی have?
Silicon Brain | جامعه هوش مصنوعی (@silicon_brain) has 7.73K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Silicon Brain | جامعه هوش مصنوعی know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →