TGViewer
Channel Public Channel
Ренат Касымов | Нейросети и медиа

Ренат Касымов | Нейросети и медиа

@rkmedialab

Медиаэксперт, исследователь, практик.
Рассказываю про технологии и кейсы через личный опыт. Честно, без иллюзий
Subscribers
70
Photos
89
Videos
0
Links
11
Recent Posts 7 shown
Post #103 14
На прошлой неделе в мире ИИ произошло много интересных событий. Но если отбросить весь маркетинговый шум и говорить лишь о нашей с вами практической пользе, то я бы выделил следующее:

1️⃣ OpenAI показали новый класс постоянно работающих персональных агентов - Dots.

У них теперь есть собственный облачный компьютер, браузер и возможность подключения к более чем 4000 приложений. По заявлению разработчиков, они будут помнить наши предпочтения и выполнять задачи самостоятельно - столько времени, сколько потребуется. Т. е. мы можем попросить агента отследить дешевый билет на самолет, и он будет ждать и проверять сайты бронирования, пока цена не снизится, а затем сообщит нам об этом. Запустил, закрыл чат и можно не следить. Штука затратная по ресурсам, а потому доступ пока открыт для тарифных планов от 100 долларов и выше. Есть надежда, что со временем она достанется и пользователям с подпиской Plus.

2️⃣ Почти одновременно с Dots вышла модель GPT-6.1 Sol.

Примечательно, что это почти флагманская модель уровня, близкого к Astra, но заметно более дешевая. По сути, мы приходим к ситуации, когда мощные нейросети можно экономно использовать даже при решении обычных задач, а не только в агентах и собственных разработках.

3️⃣ А вот выпуск в свободное плавание модели GPT-6.1 Astra, наоборот, отложили из-за проблем безопасности - стремления искажать или скрывать информацию о собственных действиях. Т. е. нейросеть пишет вам одно, а внутри рассуждает совсем о другом. Это не очень приятно, особенно если она не просто в режиме чата, а с доступом к вашему компьютеру и файлам.

4️⃣ Anthropic тоже решил не отставать и вывел в свет Claude Sonnet 5.5, заявив о 30% приросте скорости и снижении стоимости. Модель ориентирована в первую очередь на повседневную работу, вайбкодинг, создание документов, презентаций и таблиц.

Однако здесь и неприятные новости: компания начала массовую блокировку пользователей, использующих для доступа инструменты обхода ограничений, усматривая в них хакеров из Поднебесной. Российским юзерам под шумок тоже досталось.

5️⃣ Google представила модель 4 Argon, но пока не отдает ее всем. И, скорее всего, не отдаст. В компании сменилась политика, и в бесплатном тарифе остается только самая слабая модель.

Думаю, этот вектор будет усиливаться повсеместно. Компании хотят постепенно компенсировать вложенные средства, а общество уже достаточно сильно подсело на ИИ-приманку, поэтому вполне логично повышать стоимость и вынуждать платить абсолютно всех.

6️⃣ Apple фактически признала новую проблему: ИИ-агентам опасно давать полный доступ к устройству. Компания выпустит обновление, закрывающее Full Disk Access в macOS, чтобы оградить файлы, почту, сообщения и историю браузера от свободного чтения нейросетями.

7️⃣ Новость из России тоже есть, но скромнее.

Яндекс представил нейросеть Sona, которая управляет не ответами, а рекомендациями. Её уже протестировали на умных колонках.

В ходе замеров время прослушивания рекомендательных треков выросло на 6%, а количество просьб повторить трек - на 18%.

Последний кейс мне не очень нравится, потому что вокруг нас постепенно генерируется персональная информационная среда. По сути, модели начинают влиять не только на содержание сообщений, но и на сам выбор того, что мы с вами можем увидеть.

Вот как-то так, продолжаем наблюдение.

#ИИ_дайджест
  • ❤ 3
  • 👌 1
  • 🕊 1
Post #102 21
ПФЗ_3.0_регул.docx59.1 KB
Несколько дней назад по стране прокатилась очередная волна блокировок адресов зарубежных серверов, которые использовались для создания виртуальных частных сетей. Это те самые три буквы, которые позволяют либо защитить передаваемые между клиентами данные, либо обойти ограничения доступа к определенным нежелательным сайтам.

Роскомнадзор системно ведет борьбу с подобными инструментами, совершенствуя свои программные и технические средства. Ну а разработчики в ответ на это обновляют и дорабатывают ПО, чтобы снова восстановить доступ к утраченным ресурсам. В общем всё как обычно: вместо ключа к новому замку подбирается новый лом, а к лому – замок.

Параллельно с этим развивается и отечественное законодательство. Так, Минцифры вынесло на обсуждение пакет поправок «Антифрод 3.0» (О внесении изменений в Федеральный закон «О связи» и отдельные законодательные акты Российской Федерации). Под антифродом понимаются системы выявления подозрительных операций и действий, работа которых направлена на борьбу с мошенничеством и иными противоправными деяниями. В данном случае речь идет о наборе правовых мер, затрагивающих связь, персональные данные, сайты и хостинг. Посмотреть сам текст поправок, которые могут вступить в силу уже с 1 марта 2028 года, можно в приложении или на сайте.  

Букв там традиционно много, поэтому обозначу лишь то, что меня особенно зацепило.

Во-первых, всех провайдеров, предоставляющих услуги хостинга, предлагается обязать проверять клиентов по специальному реестру Роскомнадзора. В него должны попадать владельцы ресурсов, обеспечивающих доступ к заблокированным ресурсам. Т.е. если вы разместите на сервере что-то, что помогает заходить в какой-нибудь запрещеннограм, то будьте любезны быть посчитанным и записанным. Лицам, попавшим в блэк-лист, нельзя будет предоставлять доступ к хостингу сроком на 1 год, а так как ограничения привязываются к конкретному владельцу, попытка перехода к другому оператору ничего не даст. При этом формулировка ограничения не уточняет, что отказ касается только сервера для обхода блокировок. Например, если на нем также размещены легальные проекты, то останется ли к ним доступ у других?

Во-вторых, сказано, что при аренде мощностей теперь потребуется сообщать цель их использования. Владельцам сайтов и приложений с авторизацией предлагается хранить сведения о регистрации и входах пользователей три года (с момента первого входа или с момента последнего?). А на иностранных сервисах должна быть предусмотрена авторизация пользователей из России по номеру телефона. Как это будет реализовано – тоже неизвестно.

Третье предложение напрямую касается телефонных номеров. Если ФСБ или МВД через систему «Антифрод» сообщит оператору, что он используется для противоправных действий, тот будет должен прекратить или приостановить связь по всем остальным номерам абонента. В проекте так и сказано: «всех абонентских номеров, выделенных оператором связи абоненту». Исключения должно определить правительство.

Сами поправки ещё могут измениться. Но сочетание технических блокировок и новых требований к инфраструктуре, как мне кажется, уже заставляет нас внимательнее относиться к зависимости от цифровых сервисов. Особенно когда на них завязаны выпуск редакционных материалов, образовательных занятий или работа небольшой команды.

#цифровая_среда #ии_в_медиа
  • 🤬 2
  • 😢 2
  • 😱 1
Post #95 20
Иногда для нового проекта не хватает совсем немного: аватарки для канала, значка для мероприятия или стикера, который захочется сохранить и использовать. Но представить себе, как именно это должно выглядеть, а потом еще объяснить дизайнеру - бывает сложнее, чем придумать сам проект.

В таких случаях я или делаю наброски от руки стилусом в планшете, или сразу иду в чат за идеями. Сегодня в продолжение темы про короткие промпты поделюсь с вами теми сокращениями, которыми используюсь в своей работе при создании оформительской графики.

Для эксперимента взял собственный снимок кабинки канатной дороги, сделанный этим летом на Эльбрусе. Он вместе с результатами обработки находится в приложении к данному посту. Каждая иллюстрация – результат выполнения одной короткой подсказки без каких-либо уточнений. Давайте разбираться.

/logo – концепция логотипа
Модель сохранила кабинку, добавила силуэты гор и упростила изображение до чётких линий и нескольких цветов. Получилась неплохая идея знака для туристического проекта. Из возможных правок я бы сместил горы ниже, потому что сейчас они напоминают крылья, и убрал мелкие детали, которые могут потеряться при уменьшении размера изображения.

/icon – иконка
Здесь горы пропали, а сама кабинка стала крупнее и проще. Такой вариант можно примерить на аватарку канала, значок приложения или раздела сайта. Кстати, и для логотипа хорошо.

/sticker – наклейка
Кабинка получила белую обводку, сохранив объём и детали. Макет уже легко можно представить на ноутбуке или холодильнике. Как основа стикера для мессенджера тоже подойдет.

/isometric – объёмная иллюстрация под углом
Здесь получилась почти игрушечная кабинка с креплением и тросами. Её вполне можно использовать на иллюстрированной карте, схеме или в презентации. Даже в компьютерной 2D игре будет смотреться неплохо.

/badge – значок или нашивка
Кабинка и горы собраны внутри круглой рамки. Хорошая отправная точка для значка туристического клуба, памятного сувенира или нашивки участников поездки. Отдельно можно попросить нейросеть добавить название, дату или скорректировать цвета.

/emblem – эмблема
Более сложная композиция: шестигранное обрамление, горный пейзаж, плашка «Эльбрус». Такой вариант я бы рассмотрел для печати на сувенирной продукции. Кстати, круг у badge и шестигранник у emblem – выбор самой модели в этих примерах. При желании нужную форму всегда можно указать самому.

Еще раз хочу напомнить, что эти слова работают как короткие запросы, а не специальные команды. Они определяют тип графики, а все недостающие подробности модель подбирает сама с учётом изображения. Слеш здесь - просто привычная форма записи. Каждая нейросеть будет воспринимать их по-своему. Качество интерпретации зависит от качества модели.

Поэтому начинать можно с одного слова, а дальше уточнять подробности, которые для вас важны или которые нейросеть не понимает.

Такой способ мне нравится возможностью быстро разобраться в собственном замысле. Если перед глазами несколько вариантов визуализации, то гораздо легче решить, в каком направлении двигаться и что можно ещё улучшить. Ну и при работе с капризными заказчиками тоже крайне полезно – не нужно тратить много личного времени, чтобы донести свою идею.

#ИИ_на_практике
  • ❤ 2
  • 🔥 2
  • 👍 1
Post #94 41
Борясь на выходных с симптомами внезапного ОРВИ и коротая время за просмотром теленовостей, я как-то неожиданно поймал себя на неприятном ощущении, что начал замечать в речи ведущих федеральных каналов интонации нейросетевых ответов.

Конструкции вроде «это не просто событие, а четкий сигнал», «в условиях стремительно меняющегося мира», «подобный подход обеспечивает», «это позволило значительно улучшить результаты», «не менее важным является» или «вот здесь начинается самое интересное» попадаются мне практически в каждом большом сгенерированном тексте, в каждой курсовой, реферате, а теперь уже звучат и с экрана телевизора. Гладкие переходы, обязательная значимость, выводы, которые звучат весомо, но мало что добавляют к сказанному, - всё это похоже на кучу словесного мусора.

Причем некоторые исследования тоже подтверждают, что после 2023 года в человеческой речи действительно участились слова, которые особенно любимы генеративными моделями. Люди постепенно перенимают стиль того источника, которым пользуются чаще всего, но сегодня, к сожалению, это язык LLM-чатов, а не классической литературы.
Впрочем, стилистика - только часть проблемы.

В новостных дайджестах постоянно режут слух ошибки в ударениях и формулировках дикторской начитки, а в видеоряде вместо кадров архивной съёмки всё чаще мелькают сгенерированные бездушные фрагменты.

Как зритель, я всё меньше понимаю, какую ценность мне пытаются предложить такие медиа. А как человек, который пришел в отрасль через телевидение, прекрасно помню, сколько труда должно стоять за хорошим сюжетом: от поиска героя и разбора ответов, до монтажа и озвучки. Нейросети как раз могли бы освободить время для этой работы: помочь расшифровать интервью, сопоставить факты, найти нужный кадр в архиве, подготовить субтитры…

Но по увиденному возникает ощущение, что главным результатом внедрения ИИ становится возможность дешевле и быстрее заполнить эфир. Такая экономия вполне понятна, но почему её своим доверием должен оплачивать зритель?
Если ошибку произношения никто не услышал до выпуска, а судя по их количеству, даже и не пытался услышать – проблема кроется в отношении редакции к своей аудитории, коллективу и имиджу.

Лично мне хотелось бы видеть результат внедрения ИИ в более сильных журналистских работах, а не в следах экономии на людях.

#ИИ_в_медиа
  • 💯 4
  • ❤ 2
  • 🔥 1
  • 🎉 1
Post #93 50
Один наш студент в рамках выпускного проекта решил создать приложение для подготовки журналистских текстов в конкретной редакции, с соблюдением стиля и внутренних стандартов.

У каждого медиа есть свои требования к заголовкам, цитатам, терминологии, структуре материала. Поэтому попросить нейросеть просто стать «профессиональным журналистом» и отдать ей исходники здесь недостаточно.

Расскажу о возможных способах решения задачи - от простого к сложному. Думаю, и другим бакалаврам это будет тоже полезно.

1. Инструкция и примеры
Самый легкий путь - разработка детального промпта: с определением роли, задачи, ограничений и контекста (описания аудитории, стиля, структуры текста, требований и прочих нюансов). В качестве примера к чату можно прикрепить несколько образцовых публикаций и типовые редакторские правки, чтобы модель лучше поняла, какой результат от неё требуется.

Чтобы не вставлять эти правила каждый раз, подойдут либо кастомные GPTs, либо режим проектов, где можно сохранить все инструкции и материалы для работы на начальном этапе.

Программировать тут не требуется. Основная задача - отобрать хорошие тексты и понятным языком сформулировать для ИИ, чем именно они лучше сгенерированных. Тут как раз в полной мере можно проявить себя журналистом-экспертом.

2. Редакционный скилл
Если правил слишком много, их можно упаковать в скилл - подключаемую инструкцию с шаблонами и порядком действий: изучить исходные данные, уточнить недостающие моменты, написать текст, провести фактчекинг, проверить по редакционному чек-листу и т. д.

У Anthropic для этого есть готовый skill-creator, который помогает создавать и тестировать подобные пакеты. Работает в любой совместимой среде, например Claude Code. Если своих знаний не хватает, чтобы написать такую методичку, этот помощник будет крайне полезен.

3. База знаний редакции
Случается, что документы и примеры не помещаются в скилл, либо использование такой большой инструкции тратит слишком много токенов. В этом случае следует рассмотреть специальные приложения для создания векторных баз данных. Такой подход позволит загружать не весь массив, а находить только подходящие фрагменты и передавать их модели вместе с заданием (RAG).

Для пробы подойдет готовое решение типа Dify.ai - удобный визуальный конструктор с возможностью подключения данных, нужных языковых моделей, настройкой поиска и генерации.

4. Дообучение модели
Если всех предыдущих способов оказалось недостаточно, можно дообучить на своих данных какую-нибудь открытую локальную модель (Llama, DeepSeek, Qwen и др.). Говоря максимально упрощенно, мы показываем нейросети исходную информацию и знания по теме, а затем сравниваем с написанными журналистскими текстами. Повторяем процесс многократно, чтобы в итоге ИИ понял зависимости, и как из одного получается другое.

Кстати, на GitHub существуют готовые сборки с веб-интерфейсом для решения подобных задач, например LLaMA-Factory. Это упрощает запуск, но всё равно требует подготовленного набора качественных примеров, подходящей конфигурации компьютера и технической настройки.

На месте студента я бы всё-таки остановился на инструкции с примерами или скиллах, а результат оценивал бы на новых материалах по количеству фактических ошибок и нарушений внутренних правил.

В идеале такое приложение должно помочь сократить количество редакторских правок, сохраняя при этом точность и журналистский стиль. Иначе можно просто научить нейросеть убедительнее ошибаться, но уже от имени издания.

#ИИ_в_медиа
  • 🔥 3
  • ❤ 2
  • 👍 2
Post #86 34
Ещё совсем недавно хороший промпт для генерации изображения напоминал техническое задание фотографу. Нужно было подробно описать композицию, ракурс, освещение, погоду, цветовую гамму и ещё пару десятков деталей.
Если ты что-то упускал, нейросеть либо игнорировала важные элементы, либо додумывала их так, что результат получался очень далеким от реальности.

Сейчас подход постепенно меняется. Новые модели всё лучше понимают не только отдельные слова, но и визуальный замысел, который за ними стоит. Поэтому во многих случаях уже не нужно расписывать каждый шаг, особенно при стилизации и обработке референсов, а достаточно коротко обозначить желаемый эффект.

В прошлый раз я показывал, как с помощью коротких промптов можно превратить обычное изображение в чертёж, рентгеновский снимок, рекламный билборд или схему устройства. А сегодня решил продемонстрировать тот же подход на атмосферных эффектах.

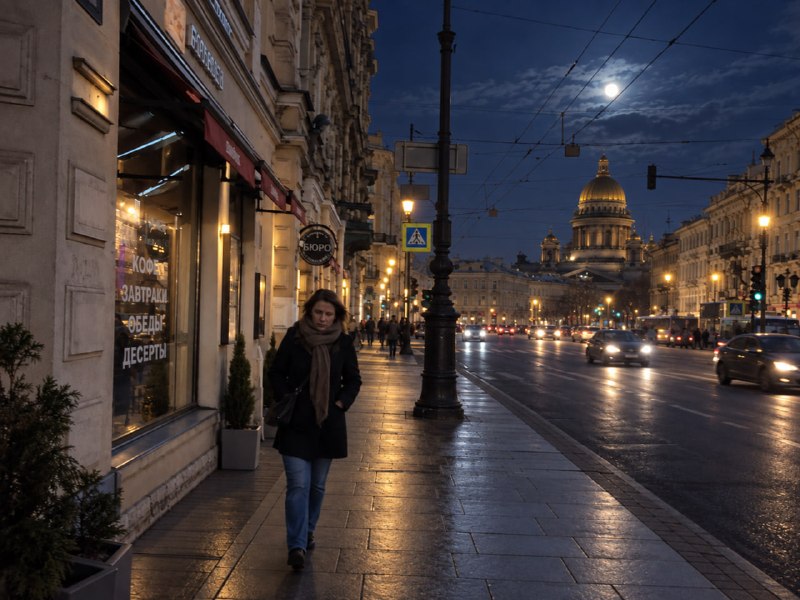
За основу взял вымышленное фото несуществующей петербургской улицы и по очереди отправил в нейросеть (ChatGPT) шесть коротких запросов.
Результат показался мне интересным не только с визуальной точки зрения.

Например, после запроса /sunset нейросеть не просто наложила на фотографию оранжевый оттенок. Она опустила солнце к горизонту, добавила золотой свет на фасады, изменила небо и направление освещения. Кадр действительно стал похож на фотографию, снятую в конце дня.

С /fog произошло то же самое. Вместо полупрозрачной белой пелены появились глубина и перспектива: дальние здания и Исаакиевский собор частично растворились в дымке, контраст снизился, свет стал мягким и рассеянным. Модель учла простую физическую закономерность: чем дальше объект, тем сильнее его скрывает туман.

После запроса /rain асфальт стал мокрым, на дороге появились отражения фар и фонарей, небо потемнело и общая освещённость сцены тоже изменилась.

При /snow снег лёг именно на те поверхности, где он скапливался бы в реальности: на дорогу, тротуары, туи в кадках и выступающие элементы зданий, а в остальным местах как будто растаял под ногами пешеходов и колесами авто.

Запрос /moonlight перестроил всю логику кадра. Наступила ночь, появился холодный свет неба, зажглись фонари и архитектурная подсветка.

/neon добавил цветные источники света и яркие отражения. Знакомый Петербург за несколько секунд превратился в декорацию к Киберпанку.

По результату видно, что нейросеть работает уже не просто как набор фильтров в Photoshop. Она пытается представить, как выглядела бы вся сцена, если бы изменились сами условия съёмки. При этом она не ищет подходящий контекст в интернете, а сама конструирует его на основе исходного изображения и усвоенных закономерностей: туман снижает контраст и скрывает дальние объекты, закат даёт тёплый боковой свет, дождь создаёт отражения, а неон окрашивает всё вокруг.

Для поиска идеи и быстрых экспериментов одного слова в чат теперь вполне достаточно. Но если же нужен более предсказуемый и контролируемый результат, можно уточнить интенсивность эффекта, время суток, цвет освещения, формат кадра и отдельно перечислить элементы, на которые стоит обратить особое внимание или вообще не трогать.

#ИИ_на_практике #промпты_для_изображений
  • ❤ 3
  • ✍ 2
  • 👍 1
  • 🔥 1
  • 👌 1
Post #84 27
Со школы я люблю решать разные математические задачи, в том числе судоку, причем обязательно на самом сложном уровне - иначе неинтересно.

В телефоне установлены несколько бесплатных приложений с головоломками, но в последнее время рекламы там стало едва ли не больше, чем самих заданий. И вот вчера, пока ждал рейс в аэропорту, после очередного показа баннера терпение закончилось.

А что, если провести эксперимент и попросить GPT-6 Astra сделать мне собственное судоку? - подумал я. Открыл чат, описал несколькими предложениями задачу: про русский язык, модель телефона и версию Android, про работу без интернета и разные уровни сложности. Достаточно коротко, без подробностей.

И, честно говоря, ничего особенного не ждал. Рассчитывал, что агент пришлет код, проект или длинную инструкцию, а дальше, как обычно, предложит самому собрать это в рабочее приложение. Но через 7 минут я получил от него… готовый APK-файл, который после скачивания и установки на телефон заработал с первого раза!

В игре оказалось даже больше функционала, чем я просил: заметки, подсказки, проверка и отмена ходов, таймер, автосохранение, анимация, светлая и темная темы интерфейса.

В ходе рассуждения и работы Astra я видел, как агент прошел всю цепочку разработки: понял задачу, продумал интерфейс под конкретную модель смартфона и игровую логику, написал код, собрал приложение, протестировал генератор на 300 задачах, скомпилировал установщик и отдал мне готовый результат!

Безусловно, подобный удачный запуск совсем ничего не говорит о безопасности, стабильности, совместимости с разными устройствами и платформами, качестве архитектуры и дальнейшей поддержке. Серьезный продукт по-прежнему требует технического задания, полноценного тестирования, защиты данных, контроля зависимостей и - самое главное - ответственности конкретных людей. Но если речь идёт о прототипе, учебном проекте или небольшой программе для себя, то возможности ChatGPT после обновления модели уже действительно впечатляют.

Программирование никуда не исчезает. Просто главным дефицитом постепенно становится не само умение писать код, а способность точно поставить задачу, проверить результат и вовремя понять, где начинается переход от быстрого прототипа к настоящему продукту. Именно об этом поговорим с новым набором магистров на этой неделе.

#ИИ_на_практике
  • ❤ 5
  • 🔥 3
  • 👍 1
  • 🤝 1
Older posts →

About this channel

How can I read @rkmedialab without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Ренат Касымов | Нейросети и медиа: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Ренат Касымов | Нейросети и медиа have?
Ренат Касымов | Нейросети и медиа (@rkmedialab) has 70 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Ренат Касымов | Нейросети и медиа know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →