TGViewer
Channel Public Channel
КПД

КПД

@quant_prune_distill

Квантование & Прунинг & Дистилляция

Блог про сжатие сетей и не только.
От древнейших времен по настоящее время.

Группа с комментариями:
@quant_prune_distill_comments
Subscribers
3.49K
Photos
289
Videos
0
Links
502

Showing posts older than #726 · Back to latest

Older Posts 20 shown
Post #725 1.59K
Attention Drift: What Autoregressive Speculative Decoding Models Learn
[Статья][Код]

EAGLE (в особенности 3-ий) и MTP-головы стали уже довольно стандартными техниками ускорения инференса за счет предсказания нескольких токенов наперед.

Однако, длина принятия не так велика, как бы хотелось. Кроме того, драфтеры оказываются неустойчивы к изменению системного шаблона и длинным контекстам.

В данной работе провели анализ причин проблем драфтеров и предложили некоторые архитектурные улучшения.
  • 🔥 4
Post #723 1.67K
К статье выше 👆

На Датафесте в Сбере был очень интересный доклад от Станислава Ильюшина из Хуавея про современное состояние области спекулятивного декодирования, текущие тренды, а также представлен разбор и эксперименты автора с вышеупомянутым DFlash.

Рекомендую всем желающим освежить и углубить знания про спекулятивку!

Примерный таймлайн рассказа
6:37:14-7:00:17
  • 🔥 15
  • ❤ 3
Post #722 1.53K
🔬 Метод

Ключевой идеей работы является использование представлений более мощной таргет - модели для драфта. А именно, берутся активации с разных слоев таргет-модели, конкатенируются, прогоняются через некий адаптер и подаются через kv-кэш (причем во все блоки).

Все токены (в пределах расшумляемого блока) предсказываются за один проход сети.

Процедура обучения выглядит следующим образом:
📌 Сэмплируются anchor токены начала блока
📌 Первый токен в последовательности - чистый, остальные заменяются на [MASK]. Это отличается от типичного обучения диффузии, где зашумляются токены на случайных позициях.

Кроме того, утверждается что более ранние токены более важны для генерации, поэтому лосс убывает по экспоненте от начала расшумляемого блока.

Голова и эмбеддинги берутся от таргет-модели.

🧪 Эксперименты

Учат драфт-модели поверх Llama-3.1 Instruct (8B) , Qwen-3 (4B, 8B, Coder-30B-A3B-Instruct). Драфт-модель - диффузионка (той же архитектуры что и базовая модель?) с 5 блоками, 8 для Qwen-3-Coder. Учат драфт на смеси примеров из Nemotron Post-Training Dataset V2 и Code Alpaca.

Замеряют ускорение (качество не надо, ибо lossless) на разных бенчах на математику/код и MTBench. Оно дает ускорение до 6 раз против ~2 раз у EAGLE-3. Acceptance length тоже заметно больше.

На бенчах на ризонинг тоже все хорошо.

Есть и SGLang интеграция, дающая ускорение до 4х раз на батче 1, и до 2 с чем-то раз на батче 32.

В ablation показывают, что выбранный размер драфта более-менее оптимален по скорости / acceptance. Больше фичей от таргета улучшает качество, но повышает расход памяти. Выбранный размер блока расшумления 16 тоже около оптимален.

💡 Выводы

Если все на самом деле так хорошо, то выглядит просто как имба. Надо учить диффузионный драфтер, но это все равно дешево по сравнению с обучением базовой авторегрессии. Команды, выкладывающие новые модели, могли бы выкладывать их вместе с таким драфтером. Оригинальный репозиторий уже содержит большое количество моделей разного размера - вплоть до Kimi K2.6.
  • 🔥 12
  • ❤ 1
Post #721 1.36K
DFlash: Block Diffusion for Flash Speculative Decoding
[Статья] [Блог] [Код]

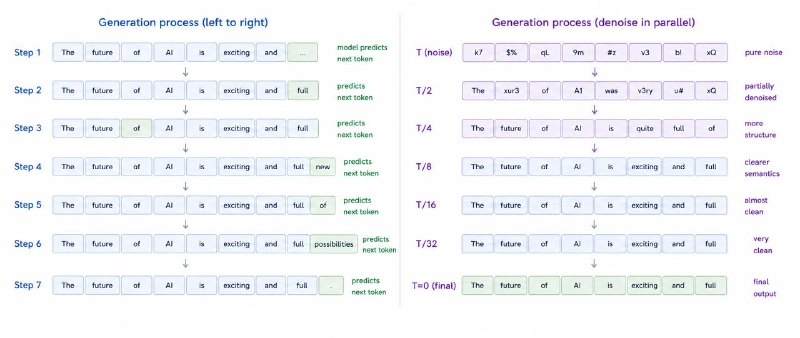
Авторегрессионные модели генерят по одному токену за раз, что медленно, а диффузионные могут за раз выдать много, но не всегда с первого раза хорошо, и на текущий момент все еще нет моделей уровня state-of-the-art AR-ок.

Довольно успешной стратегией по ускорению AR генерации показывает себя спекулятивное декодирование, где маленькая моделька предсказывает несколько токенов наперед. В частности, EAGLE и его версии получили широкое распространение. Однако максимально достижимое ускорение все равно ограничено длиной принятия, и тем что драфт-модель приходится гонять несколько раз авторегрессивно.

Диффузия в качестве драфта предлагает предсказание многих токенов за один проход.
  • 👍 5
Post #720 1.51K
🔬 Метод

В основе идеи статьи лежит следующее наблюдение - query меняется не очень сильно между соседними токенами, косинусная близость порядка 0.9. Отсюда мысль - давайте будем держать в памяти, то что мы подгрузили на прошлом шаге и менять по мере необходимости.

В качестве кратких summary 📜 по группам токенов, используемых для определения важных токенов на оффлоадинге, берутся ландмарки из QuEST (min-max pooled ключи).

Всегда брать одни и те же ключи и значения, очевидно, плохо, и для каждой головы они следят за изменением query (косинусная близость), и если изменение превышает порог - пересчитывают актуальные ключи и значения. На практике, это надо делать не слишком часто.

Кроме того, подгрузку KV можно перекрыть с вычислениями в attention / mlp, тем самым дополнительно сэкономив время.

🧪 Эксперименты

Предложенный подход валидируют на семействах моделей Llama-3, Qwen-2.5 и дистиллах DeepSeek-R1. Удается достичь качества оффлоадинга, при этом будучи в разы, а то и десяток раз быстрее бейзлайнов. Правда, стоит заметить, что везде инференс поверх HF transformers, так что это гонки на инвалидных колясках.

💡 Выводы

Вроде бы не слишком сложно реализуемый и логичный метод оффлоадинга. Но практическое применение будет упираться в возможность интеграции в эффективные фреймворки инференса vllm / sglang.
  • ❤ 2
Post #719 1.54K
FreeKV: Boosting KV Cache Retrieval for Efficient LLM Inference
[Статья] [Код]
Есть две популярные техники сжатия KV-кэшей (вообще говоря гораздо больше, но далее рассказ затронет только эти две):

💣 KV-Cache Pruning/Eviction - убирающий наименее полезные токены
🦾 KV-Cache Offloading - сгружающий KV-кэш в более медленную, но обьемную память RAM

Первый из них потенциально дает некоторое ускорение, но на практике определять важные/неважные токены сложно, из-за чего имеют место заметные просадки в качестве. Оффлоадинг потенциально сохраняет качество, но замедляет инференс из-за дорогостоящего трансфера данных из CPU RAM в VRAM.

А в идеале хотелось бы чего-то быстрого и сохраняющего качество.
  • ❤ 7
  • 🔥 2
Post #717 2.04K
🔬 Метод

Оригинальный DeltaNet делает обновление ранга один, которое в некотором смысле затирает текущую ассоциацию с ключом k_t, и перезаписывает ее с новым value.

S_{t} = (1 - b_t k_t k_t^T) S_{t-1} + \beta_t k_t v_t^T

Gated DeltaNet навешивает еще скалярный forget gate на старое состояние.

S_{t} = \alpha_t (1 - b_t k_t k_t^T) S_{t-1} + \beta_t k_t v_t^T

KDA (Kimi Delta Attention) заменяет скаляр \alpha_t на вектор D_t, так что каждый канал модулируется независимо.

S_{t} = (1 - b_t k_t k_t^T) D_t S_{t-1} + \beta_t k_t v_t^T

В Gated DeltaNet предложили развить идею из KDA и добавить еще две дополнительные векторные модуляции:

S_{t} = (1 - k_t (b_t ⊙ k_t)^T) D_t S_{t-1} + \beta_t k_t (w_t ⊙ v_t)^T

Как и в прошлых версиях DN, GDN работает почанковое обучение, чтобы не взрываться по памяти. Наличие дополнительных гейтов требует некоторой модификации обратного прохода, но не очень сложной.

🧪 Эксперименты

Для Gated DeltaNet-2 и бейзлайнов (Mamba-2, Mamba-3, GDN, KDA, Transformer) учат 1.3B модель 100B токенов (причем Адамом, не Мюоном). На перплексии и бенчах Gated DeltaNet-2 естественно лучше всех.

Гибридный вариант GDN-2 с Sliding Window Attention чуть лучше.

На NIAH (иголка в стоге сена) сырой GDN лучше линейных бейзлайнов, но чуть уступает трансформеру. Гибрид с SWA всех рвет.

По скорости (training throghput) довольно стабильна с длиной контекста. Несколько помедленнее GDN, KDA и Mamba-2, Mamba-3-SISO.

💡 Выводы

Будто бы логичное, но инкрементальное развитие Gated DeltaNet. Сохранится ли значимый прирост от нововведений на масштабе и перевесит ли некоторое замедление обучения 🤔?
  • ❤ 3
Post #716 1.48K
Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention
[Статья][Код]

NVIDIA (без Songling Yang 😱) выкатила развитие идеи про Gated DeltaNet, типа повышающее выразительность модели.
  • 👍 7
Post #715 12.1K
Пока все обсуждают новую Гемини Флэш, NVIDIA тихонько выкатили серию гибридных авторегрессионно-диффузионных моделей Nemotron-Labs-Diffusion.

В коллекции 6 чисто языковых моделей - 3B, 8B, 14B LM-ки с алайнментом и их базовые модели, и еще 8B диффузионная VLM.

Модели имеют 3 режима работы:
🤓 Авторегрессионную генерацию
🚀 Диффузионную генерацию
🧙‍♂️ Спекулятивную генерацию с набрасыванием чернового варианта диффузией и AR самопроверкой

По качеству оно типа немного лучше Qwen-3-8B, но по скорости в самоспекулятивном режиме обходит Qwen3-8B-Eagle3 в 3 раза. Правда, вышел уже Qwen 3.5 (если говорить о моделях в той же весовой) ...

[Техрепорт]
  • 🔥 12
  • ❤ 3
Post #714 1.86K

Forwarded from LiSearch

IDLM: Inverse-distilled Diffusion Language Models (ICML 2026, Our recent work)
Paper | Code | Checkpoints

⚡️ Can a language model generate a 1024-token sequence in just 16 forward passes?

That would mean producing 1024/16=64 tokens per forward pass.

For today’s standard language models, this sounds almost impossible. They are autoregressive, meaning they generate text token by token: first token, then the next, then the next…
So generating 1024 tokens usually requires 1024 forward passes.

This is one of the biggest bottlenecks in LLM inference.

A promising alternative is Diffusion Language Models. Instead of generating tokens one by one, they try to generate or refine the whole sequence in parallel, potentially removing the need for strict autoregressive decoding.

In theory, this could make generation much faster.

But in practice, diffusion-based language models often turn out to be slower, not faster, than autoregressive models.

The main challenge is the space dimension.

If we want the model to generate the next 64 tokens at once, it is not enough to predict one token 64 times independently. Ideally, the model should approximate the joint distribution over all possible 64-token continuations.

But the number of such continuations is enormous.

Even for a relatively small vocabulary, like GPT-2’s vocabulary of about ≈60,000 tokens, the number of possible 64-token sequences is:

60,000⁶⁴ ≈ 10³⁰⁶

That is an astronomically large number. We cannot enumerate these possibilities, store them, or explicitly simulate such a distribution.

So the real question becomes:

Can we generate many tokens in parallel while keeping the model’s complexity only linear in sequence length?
  • ❤ 10
  • 🔥 2
Post #713 1.57K
Выдающаяся работа про дистилляцию дискретной диффузии и подробный ее разбор от товарищей.
  • 🔥 5
Post #712 2.45K
OpenAI выпустили блогпост, посвященный анализу наиболее интересных посылок из Parameter Golf 🏌️ соревнования.

Напомню, что целью соревнования было получить минимальный валидационный лосс на Fineweb, при этом укладываясь в лимит 10 минут на обучение на 8x H100 и размер артефакта (модель + код) 16 Mb.

Отметили следующие решения:
• В одной посылке затюнили инициализацию мюона, weight_decay как-то по умному
• Еще были посылки, использующие интересные вариации GPTQ на post-training квантизации
• В одной посылке накрутили test-time LoRA training
• Были еще идеи с креативными токенизаторами
• Эффективный attention
• Что-то про gating и хэширование
• Рекуррентные (повторяющиеся) слои

А еще были сабмиты, которые не выбили сильный скор, но завоевали приз зрительских симпатий.

В одном из них накрутили state-space модели и JEPA 🤩.
  • ❤ 16
Post #711 2.05K
Квантизовать модельки надо так, чтобы качество на MATH-500 прирастало на 15 c лишним процентов 🤩.

Самое забавное, что авторов это не смутило, и они прямо в abstract так указали.

[Статья]
  • 😁 27
Post #710 4.69K
🔬 Метод

В оригинальной работе метод был из себя весь такой замечательный, но замерялся на сравнительно простых задачах, без интеграций с эффективными фреймворками инференса.

Здесь же решили замерить скорость в работы в vLLM интеграции на широком наборе задач, включая ризонинг.

Рассматривают следующие конфигурации:
👉 bf16 бейзлайн
👉 fp8
👉 TQ k8v4 (6-7 бит на значение)
👉 TQ 4bit-nc
👉 TQ k3v4-nc
👉 TQ 3bit-nc

🧪 Эксперименты

Качество замеряют на Llama-3.3-70B-Instruct, Qwen3-30B-A3B-Instruct-2507, Minimax-2.7.

На long-context retrieval (MRCR) bf16/fp8/2 более высокобитных TurboQuant дают примерно одинаковое качество. Более агрессивные TurboQuant квантизации заметно просаживают.

На ризонинге fp8/k8v4 сохраняют 98% качества, TQ 4bit-nc 96%, а более агрессивные квантизации уже сильно хуже.

В плане экономии памяти fp8 экономит вдвое по сравнению с bf16, TQ k8v4 2.3-2.4 раза, TQ 4bit-nc - 3.1 - 3.4 раза, TQ 3bit-nc до 4-х раз.

На Llama fp8 дает почти двухкратное ускорение инференса, но почти без разницы для Qwen3 MoE. TQ замедляет на 20-40% инференс на Llama, и на 40-60% на Qwen3.

Throughput у FP8/BF16 примерно одинаковый, TQ уменьшает его до 66-80% в зависимости от модели и конфигурации квантизации.

💡 Выводы

📌 FP8 все еще остается хорошим бейзлайном по соотношению качество / экономия.
📌 TurboQuant k8v4 не дает существенной экономии против FP8, но замедляет инференс.
📌 TurboQuant 4bit-nc неплох как баланс между сжатием / качеством, если скорость не критична.
📌 Более агрессивные квантизации бесполезны.

Итого, TurboQuant не то чтобы особо практически полезная шняга.
  • 🔥 14
Post #709 4.24K
A First Comprehensive Study of TurboQuant: Accuracy and Performance
[Блог]

Казалось бы, уже стоило бы забить на этот несчастный TurboQuant, но кому-то он все еще не дает покоя. И команда из Red Hat AI 🤠 провела систематическое исследование нашумевшего метода, фокусируясь на производительности и качестве работы на задачах.
  • 😁 2
Post #708 1.85K
🔬 Метод

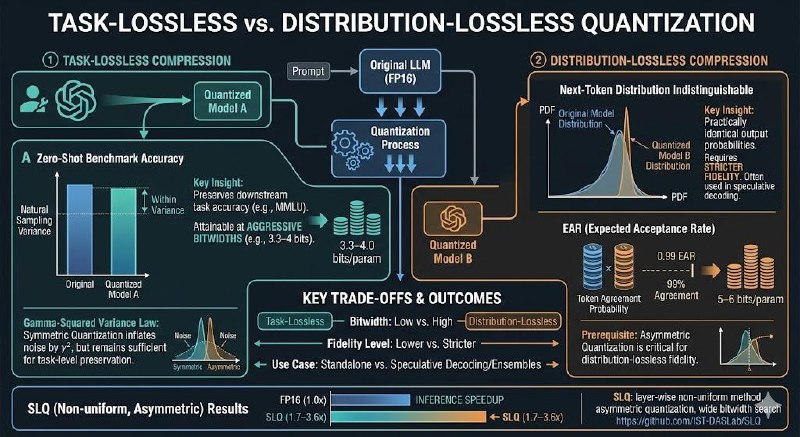
Обыкновенно в статьях про квантизацию, да и сжатие в принципе, стремятся не потерять качество на каком-то наборе задач. Однако, может представлять интерес более сильное требование - чтобы распределение сжатой модели не отличалось от исходной модели в пределах шума сэмплирования.

Отсюда определяем 2 возможные цели сжатия:
🚀 Task-lossless сжатие. Качество не просаживается в пределах стандартного отклонения.
🚀 Distribution-lossless. Распределение сжатой модели неотличимо от исходной. Очевидным решением было бы использовать KL-дивергенцию в качестве меры, но абсолютная ее величина не репрезентативна, и вероятности токенов могут заметно шуметь. Вместо этого предлагают EAR (Expected Acceptance Rate), вероятность того, что предсказанный следующий токен для обеих моделей будет один и тот же.

Чтобы добиться distribution-lossless, оказывается важным использовать ассиметричную квантизацию с вычитанием среднего. Даже небольшой перекос распределения сильно увеличивает ошибку и симметричная квантизация требует на целый бит больше, чтобы добиться той же самой ошибки.

Сеть, минимизирующую ошибку, получают следующим образом:
🔅 Квантуют веса в разные точности базовым алгоритмом (GPTQ).
🔅 Затем определяют важность каждого слоя через Shapley оценку
🔅 На основе важностей подбирают оптимальную конфигурацию

🧪 Эксперименты

Исследование проводят на моделях Qwen-3, Qwen-3.5, Llama-3.3-70B-Instruct.

Task-lossless порог для моделей разнится от 3.3 бит для Qwen-3.5-27B до 4.7 бит для Qwen-3-8B. 4-битная однородная квантизация оказывается lossless для всех кроме Qwen-3-8B.

Порог distribution-lossless выше - от 4.98 бит для Qwen-3-32B до 6.55 бит у Llama-3.3-70B-Instruct.

На ризонинге DL квантизация не меняет длину цепочек, а TL и однородная 4-х битная увеличивает число токенов ризонинга на 2-3% (статзначима ли разница?).

С Humming кернелами от Inclusion AI авторы добиваются нетривиальных ускорений (1.6-2.8) раз для distribution-lossless квантизации.

💡 Выводы

Разбиение на task-lossless и distribution-lossless квантизацию выглядит полезным с точки зрения практиков. Вторая должна давать некоторые более сильные гарантии на качество. Однако, возникает вопрос насколько оценка на калибровочной выборке обобщается на все реальные ситуации.
  • 🔥 6
Post #707 1.62K
Statistically-Lossless Quantization of Large Language Models
[Статья][README.md]

Интересное исследование от авторов IST / ETH, формализующее понятия task-lossless и distribution-lossless сжатия.
  • 👍 4
  • 🔥 3
Post #706 1.88K
🔬 Метод

Каждому параметру задается несколько возможных опций разной стоимости c_k, а также распределения вероятности p_i = softmax(\alpha_i) (\alpha_i - некие исходные логиты). И у каждого параметра есть свой вес w_i. Итоговая стоимость имеет вид:

C = \sum_i w_i <p_i, c>

Фиксированный бюджет C задает некоторое гладкое многообразие в пространстве логитов \alpha, потому можно применять известные техники Римановой оптимизации для нахождения решения.

Алгоритм работает следующим образом:
🔅 Проецируем градиент на многообразие
🔅 Делаем шаг любым оптимизатором (например, Adam-ом)
🔅 Проецируем полученную точку обратно на многообразие
🔅 Проецируем первый момент на текущую касательную плоскость

Логиты зашумляются случайным шумом. Сила шума постепенно понижается от некоторой максимальной до минимальной. Тем самым в начале активно исследуем пространство решений, а затем аккуратно сходимся.

В качестве лосс-функции используется KL дивергенция между исходной и сжатой моделями.

🧪 Эксперименты

Метод сначала валидируют на задаче с рюкзаком, где есть точный алгоритм динамического программирования. Методы с Лагранжианом / расширенным Лагранжианом не находят целевое решение, а Риманова оптимизация находит.

Затем пробуют сжимать экспертов в MoE (OLMoE, Qwen3-30B-A3B, Qwen3-Coder-Next). Заметно опережают по качеству REAP и EvoESAP (эволюционный алгоритм) будучи значительно быстрее последнего.

Однако, метод чувствителен к выбору данных, на Qwen3-Coder если обучаться на коде, хорошо сохраняется качество на коде, но просаживается на остальных доменах. И наоборот, калибровочные данные общего вида просаживают сильно качество на коде.

Для mixed precision квантизации показывают себя не хуже эволюционных алгоритмов, будучи в несколько раз дешевле по стоимости. При 2.5-3.5 битной квантизации опережают MxMoE бейзлайн на 1% в среднем по качеству.

💡 Выводы

Как будто бы сравнительно недорогая и рабочая техника для структурированного прунинга / неравномерной квантизации. Стоит попробовать!
  • ❤ 6
  • 👍 3
  • 🤔 2
Post #705 1.61K
Model Compression with Exact Budget Constraints via Riemannian Manifolds
[Статья][README.md]

Разные слои не в одинаковой степени влияют на качество работы модели. Потому существенный интерес представляет нахождение эффективного способа определять важность структурной единицы в сети.

Существующие подходы обычно полагаются на грубые эвристики, типа косинусного расстояния между входом и выходом модели, либо требуют перебора большого числа конфигураций как в эволюционном поиске / дифференцируемом NAS.

И авторы из ETH/IST предложили сравнительно недорогой и точный алгоритм, основанный на представлении задачи поиска нахождения оптимальной сжатой конфигурации в виде Римановой ⚾ оптимизации.
  • 👍 6
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →