TGViewer
Channel Public Channel
КПД

КПД

@quant_prune_distill

Квантование & Прунинг & Дистилляция

Блог про сжатие сетей и не только.
От древнейших времен по настоящее время.

Группа с комментариями:
@quant_prune_distill_comments
Subscribers
3.49K
Photos
289
Videos
0
Links
502

Showing posts older than #705 · Back to latest

Older Posts 18 shown
Post #704 2.12K
  • 👍 3
Post #703 2.14K
  • 🔥 8
Post #702 2.49K
Занятный блог (не первой свежести, но от этого не менее интересный) от Horace He про замеры скорости матричного умножения.

Естественно было бы ожидать, что скорость матричного умножения не зависит от элементов в матрицах ибо сам алгоритм может определяться размерами матриц, спецификой железа, но не от значений.

Однако, бенчмаркинг показывает, что умножение матриц из одних нулей / матриц из одних единиц работает заметно быстрее, чем в случае, когда элементы сэмплируются из равномерного или нормального распределения (процентов на 20%) 😱.

Оказывается, дело в троттлинге. Если элементы постоянно меняются, то транзисторы каждый раз переключаются при подгрузке элементов, и, чтобы вписаться в лимит по энергопотреблению, GPUшка автоматически снижает частоты. Для матриц из одних и те же элементов переключения транзисторов нет - соотвественно, и нет троттлинга.

Для дальнейшей верификации гипотезы автор пробует разные распределения - матрицы из одних чисел пи, бинарные, тернарные матрицы. Чем более случайное распределение - тем медленнее операция перемножения.

Эффект становится еще более выраженным при ручном снижении порога энергопотребления.

При этом заявленная производителем скорость операций на практике не достигается.
  • ❤ 21
  • 😱 10
  • 👍 5
Post #701 2.37K
Our finding is that Block-Diagonal Rotation (BDR) before token-wise INT4 quantization recovers nearly all accuracy lost by naıve quantization.

[Статья]
  • 🔥 16
  • 😁 8
  • 🗿 2
Post #700 2.97K
Эй браток, не хочешь послушать про Miscoscaling квантизацию?

Вместе с @black_samorez
  • 😁 32
  • 🔥 17
  • 👍 4
  • ❤ 2
Post #697 2.58K

Forwarded from ML Underhood

От забавных постеров к серьёзным разборам

Но тоже постеров. Тех, которые привлекли внимание инженеров Яндекса на ICLR 2026.

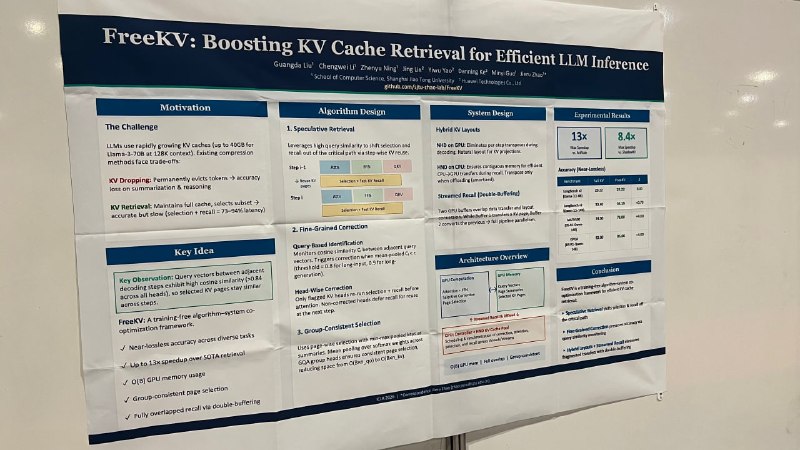
FreeKV: Boosting KV Cache Retrieval for Efficient LLM inference

Авторы работают над развитием класса методов KV selection — он помогает ускорить self-attention на длинных контекстах через подгрузку в кернел не всех токенов, а только важных (выбор может быть обучаемым или по эвристике).

В целом, KV selection может быть скомбинирован с offload кэша в RAM / SSD / NetStorage. Но общее больное место всех таких методов — эффективная работа с подгрузками больших объёмов данных и выбор важных токенов.

В статье предлагают делать такие подгрузки спекулятивно (между итерациями декодинга догружаем только изменения, грузим основное асинхронно), так как заметили, что соседние важные токены в декодинге отличаются слабо. Кроме того, в случае сильного изменения предлагается делать перевыбор с помощью набора эвристик. Итоговый подход отлично себя показал на бенчмарках скорости поверх сильного бейзлайна ShadowKV.

Cache-to-Cache: Direct Semantic Communication Between Large Language Models

Авторы предлагают способ обмена KV-кэшами между разными моделями, чтобы LLM-ки могли коммуницировать друг с другом не на уровне конечных токенов, а на уровне более богатых внутренних представлений. Есть две модели: Sharer и Receiver. Первая отдаёт представления, а вторая получает и генерирует ответ. В практически интересном сценарии — Sharer — большая сильная модель, а Receiver — поменьше и послабее.

Обучают небольшую нейросеть, которая отображает KV-кэш из исходной модели в целевую. Кроме того, есть обучаемый gate, смешивающий представления двух моделей. Receiver-модель обучается воспроизводить ответ более мощного Sharer.

В итоге удаётся зачастую не только не уступить Sharer в качестве, но иногда и превзойти. Авторы показывают, что Cache-to-Cache работает лучше, чем просто подача текстовой информации от Sharer.

LLM Pretraining with Continuous Concepts

Стандартный претрейнинг учит модель только одному — предсказывать следующий токен. Все высокоуровневые абстракции модель должна «выкопать» сама из cross-entropy-лосса. CoCoMix предлагает дать LLM прямой сигнал о концептах, которые должны быть активны. Идея такая:

1 этап — извлечение концептов. Авторы берут предобученую LLM (GPT-2) и обученный на её хидденах TopK SAE. Прогоняют корпус через teacher (взятая LLM), на выбранном слое получают разреженные SAE-активации. Дальше — фильтрация по attribution score (градиент CE × активации): оставляют только те концепты, которые реально влияют на предсказание следующего токена.

2 этап — непосредственно обучение. Модель условно режется на h и f. На выходе h параллельно происходит:

— линейная голова предсказывает распределение SAE-концептов → CE-лосс на метках, которые получили на первом этапе;
— предсказанный вектор сжимается в один continuous concept и интерливится с hidden states: [z₁, c₁, z₂, c₂, …], идёт в f;
— общий лосс получается равен — СЕ_tokens + \lambda * CE_concepts

В итоге достигают того же качества по PPL, что и модели, обученные просто на задачу NTP, но за меньшее — на 21,5% — количество токенов. По бенчмаркам (HellaSwag / PIQA / SIQA / ARC-e / WinoGrande / LAMBADA / WikiText) получается стабильно лучше, чем аналогичная модель, но обученная на NTP задачу.
Для извлечения концептов можно использовать модель меньшего размера, чем ту, которую хотим претрейнить, качество при этом не страдает.

В таком сетапе получается, что на каждый токен последовательности добавляется вектор-концепт, что увеличивает длину контекста в два раза. Авторы проверяли свой метод на контексте в 1024 токена, поэтому с проблемой нехватки контекста не столкнулись.

Интересное увидели ❣ Роман Горб, Денис Кузнеделев и Дмитрий Масный

#YaICLR26

ML Underhood
  • 🔥 9
  • 👍 7
  • ❤‍🔥 1
  • ❤ 1
Post #696 1.9K
Кроме того, стоит быть всегда начеку - ибо специалистов по сравнительно честному и не очень отъему денег у населения пруд пруди.
  • 😁 11
  • 😢 5
Post #695 2.22K
Побывать в Рио-Де-Жанейро было моей детской мечтой еще со времен прочтения "Двенадцати стульев" и просмотра мультфильма "Рио". И город оказался действительно таким же захватывающим, разношерстным, каким и представлялся.

Причудливый рельеф, высокие горы, густо поросшие зеленью, пальмы, банановые деревья, переплетенные лианами, глубокие заливы, обширные песчаные пляжи, перемежающаяся высокая застройка и художественный беспорядок фавел - все это придает городу особый шарм и очарование.

Местная публика тоже очень разнообразная - люди, как тяготеющие к европейскому типажу, так и очень темненькие, но в основном нечто посередине. Бразильянки отличаются нередко пышными и выразительными фигурами.

Коммуникация с местными вызывает зачастую большие затруднения, лишь немногие умеют даже на базовом уровне понимать английский. Бразильцы обыкновенно продолжают диалог на португальском, даже если явно обозначаешь, что не говоришь на нем.
  • ❤ 27
  • 🔥 8
  • 🤩 6
  • 👍 1
Post #692 3.02K
Слив архитектуры Claude Mythos?

Некто выложил на гитхаб проект под названием OpenMythos - типа гипотетическая реконструкция Claude Mythos.

Возникает вопрос: Почему он должен выглядеть именно так? 🤔

Ответ: Ну раз он такой умный, значит это Recurrent-Depth Transformer. Ну и потому что несколько авторитетных чуваков из твиттера так считают.

Осталось только взять реализацию модельки, заскейлить до триллиона параметров, обучить на сотнях триллионов токенов и миллионах роллаутов - и, вуаля, AGI готов.
  • 😁 31
  • 🤩 3
  • 🤔 2
  • ❤ 1
Post #690 2.99K
Страсти вокруг TurboQuant продолжаются.

Попытки воспроизвести TurboQuant у сообщества приводят к тому, что люди переизобретают HIGGS...

• Пост Тима Деттмерса в X
• PR в vLLM
  • 👀 13
  • 🤔 4
  • 😁 2
Post #689 3.22K
  • 😁 46
Post #686 3.46K
🔬 Метод

Сначала выводят некоторые теоретические оценки на минимально достижимую ошибку квантизации линейного слоя для GPTQ с хаффмановым кодированием весов и WaterSIC, который будет предложен ниже. Полученные выражения - некоторые формулы, зависящие от элементов матрицы Холески для матрицы ковариации входных активаций.

Алгоритм WaterSIC состоит из следующих компонент:
🔅 Сначала находят ближайшее значение к вектору W L (вес на фактор Холески) на решетке, образованной столбцами матрицы L. По существу, переформулировка GPTQ. Для большей точности делают еще сжатие на некий фактор, оптимизирующий MSE.
🔅 Затем учитывают тот факт, что активации в прошлых слоях несколько разъехались по сравнению с исходной моделью и добавляют компенсацию ошибки.
🔅 Потом применяют диагональное перемасштабирование для минимизации MSE.
🔅 Энтропийное кодирование (Хаффман).
🔅 В матрицах слоев внимания перевзвешивают матрицы ковариации активаций на внимание токенов (приоритезируя оптимизацию ошибки на важных токенах).
🔅 Убирают размерности с околонулевым разбросом около среднего.

🧪 Эксперименты

Метод валидируют на weight-only сжатии Llama-3.2-1B и Qwen3-8B в битностях от 1 до 4 бит. При всех степенях сжатия на Llama-3.2-1B метод выдает качество лучше бейзлайнов, среди которых QTIP и предложенный Huffman-GPTQ (из статьи, правда, непонятно, какая базовая битность). На Qwen3-8B предложенный подход также выдает хорошую перплексию.

💡 Выводы

Ну что, мощные серверы больше не нужны?

А если серьезно, то результат интересный. Однако можно придраться к замерам одной лишь перплексии без каких-либо бенчей. Кроме того, хаффманово кодирование на GPU вроде бы эффективно не реализуешь, и достижимо ли хоть какое-то ускорение или хотя бы замедление в разумных пределах в такой постановке?
  • ❤ 6
Post #685 2.29K
WaterSIC: information-theoretically (near) optimal linear layer quantization
[Статья] [Кода нет, как и кернелей]

Вопрос об оптимальной квантизации продолжается оставаться актуальным. Есть методы достигающих хорошего баланса между качеством и сжатием за счет использования продвинутых представлений - векторной квантизации, треллисов. Но можно ли приблизиться к информационно-теоретическому пределу в рамках скалярной квантизации?

И группа исследователей разработала метод WaterSIC, который квантизует адаптивно в разную битность скалярной квантизацией и отстает от IT предела всего на 0.255 бит.
  • ❤ 3
  • 👍 3
  • 🔥 3
Post #684 2.42K
  • 🔥 10
Post #683 2.38K
Вдохновленный autoresearch от маэстро Андрея Карпатого, я решил попробовать поискать оптимальный метод квантизации при помощи LLMного агента.

Если конкретно, то агенту 🤖 дается следующая установка
📌 Получить как можно более низкую перплексию на wikitext2 при фиксированной битности / размере группы.
📌 Можно менять алгоритм квантизации, но нельзя трогать вид квантизованного представления (битность, векторную квантизацию вместо скалярной, скажем).
📌 Скрипт замера перплексии фиксирован.

В качестве стартовой точки дается ванильный GPTQ с параметрами по умолчанию.

Агент (Claude Sonnet 4.6) сделал следующее
🧪 На первой же итерации изменил порядок квантизации на actorder (каналы с большими активациями вначале). По всей видимости, это у него уже было в обучающей выборке.
🧪 Еще он пробовал тюнить параметры регуляризации и размер калибровочной выборки.
🧪 Наиболее интересным изменением был подбор скейлов квантизации. Он пришел к какому-то поиску, взвешенному на послойный Гессиан, и в самом топовом решении даже накрутил какой-то Ledoit-Wolf оценщик для матрицы ковариации (применительно к скейлам).

Если резюмировать - Америку оно не открыло, но нашло (или знало) мелкие эмпирические трюки для прокачки квантизации. Для более интересных результатов, наверное, надо отправить его лазить в интернет откапывать давно забытые труды советских математиков и кибернетиков.

🐈‍⬛ проекта выложен 👉 здесь
  • 🔥 21
  • ❤ 3
Post #682 2.58K
🔬 Метод

Длинные цепочки рассуждений, как известно, позволяют заметно улучшить качество на определенном классе задач. В то же время, бывает так, что избыточные рассуждения 🤔 могут вредить и уводить от правильного ответа.

Данная работа ищет ответ на следующие вопросы - что происходит с рассуждениями при наличии дополнительного контекста, может ли модель так же хорошо решать поставленную задачу?

Рассматриваются следующие постановки:
🔅 Baseline. Просто исходная задача и вопрос.
🔅 Subtask. Одно пользовательское сообщение и две подзадачи.
🔅 Long input. Много иррелевантного контекста и задача,
🔅 Multi-turn. Многошаговый диалог после которого идет сама задача.

🧪 Эксперименты

Проверяют следующие модели:
🚀 Qwen-3.5-27B
🚀 GPT-OSS-120B
🚀 Gemini 3 Flash Preview
🚀 Kimi K2 Thinking

Для всех не Baseline вариантов наблюдается следующее:
🩳 Длина ответа сокращается
⬇️ Качество несколько проседает

Затем подают в Qwen3.5-27B разное количество токенов иррелевантного контекста и наблюдают монотонную просадку длины генераций. 64к токенов укорачивают ответ вдвое (с 8к до 4к).

Кроме того, пробуют модели семейства Olmo-3:
🔅На Instruct чекпоинте почти не наблюдает описанное явление.
🔅Для Thinking чекпоинтов сокращение длины имеет место.
Для Qwen-3-32B укорачивание генераций тоже гораздо более заметно в reasoning режиме.

💡 Выводы

Данный результат показывает, что рассуждающие модели имеет смысл специальным образом дообучать, чтобы адаптировать к большему объему релевантного или постороннего контекста, который может возникать в агентных сценариях.
  • 🔥 10
  • ❤ 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →