


Но тоже постеров. Тех, которые привлекли внимание инженеров Яндекса на ICLR 2026.
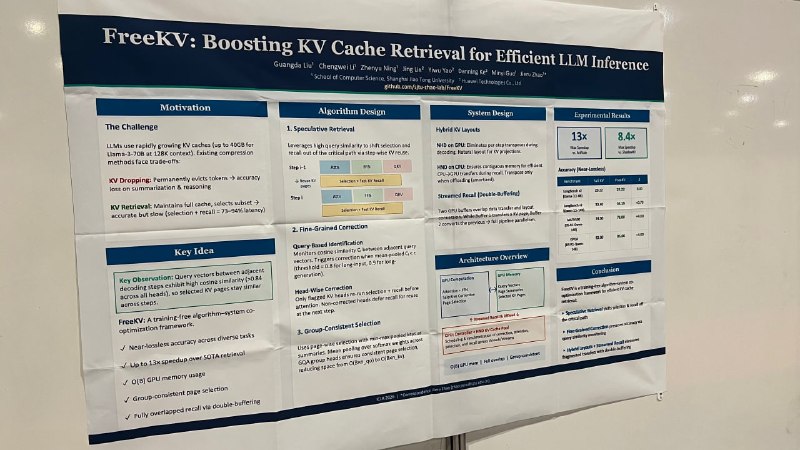
FreeKV: Boosting KV Cache Retrieval for Efficient LLM inference
Авторы работают над развитием класса методов KV selection — он помогает ускорить self-attention на длинных контекстах через подгрузку в кернел не всех токенов, а только важных (выбор может быть обучаемым или по эвристике).
В целом, KV selection может быть скомбинирован с offload кэша в RAM / SSD / NetStorage. Но общее больное место всех таких методов — эффективная работа с подгрузками больших объёмов данных и выбор важных токенов.
В статье предлагают делать такие подгрузки спекулятивно (между итерациями декодинга догружаем только изменения, грузим основное асинхронно), так как заметили, что соседние важные токены в декодинге отличаются слабо. Кроме того, в случае сильного изменения предлагается делать перевыбор с помощью набора эвристик. Итоговый подход отлично себя показал на бенчмарках скорости поверх сильного бейзлайна ShadowKV.
Cache-to-Cache: Direct Semantic Communication Between Large Language Models
Авторы предлагают способ обмена KV-кэшами между разными моделями, чтобы LLM-ки могли коммуницировать друг с другом не на уровне конечных токенов, а на уровне более богатых внутренних представлений. Есть две модели: Sharer и Receiver. Первая отдаёт представления, а вторая получает и генерирует ответ. В практически интересном сценарии — Sharer — большая сильная модель, а Receiver — поменьше и послабее.
Обучают небольшую нейросеть, которая отображает KV-кэш из исходной модели в целевую. Кроме того, есть обучаемый gate, смешивающий представления двух моделей. Receiver-модель обучается воспроизводить ответ более мощного Sharer.
В итоге удаётся зачастую не только не уступить Sharer в качестве, но иногда и превзойти. Авторы показывают, что Cache-to-Cache работает лучше, чем просто подача текстовой информации от Sharer.
LLM Pretraining with Continuous Concepts
Стандартный претрейнинг учит модель только одному — предсказывать следующий токен. Все высокоуровневые абстракции модель должна «выкопать» сама из cross-entropy-лосса. CoCoMix предлагает дать LLM прямой сигнал о концептах, которые должны быть активны. Идея такая:
1 этап — извлечение концептов. Авторы берут предобученую LLM (GPT-2) и обученный на её хидденах TopK SAE. Прогоняют корпус через teacher (взятая LLM), на выбранном слое получают разреженные SAE-активации. Дальше — фильтрация по attribution score (градиент CE × активации): оставляют только те концепты, которые реально влияют на предсказание следующего токена.
2 этап — непосредственно обучение. Модель условно режется на
h и f. На выходе h параллельно происходит:— линейная голова предсказывает распределение SAE-концептов → CE-лосс на метках, которые получили на первом этапе;
— предсказанный вектор сжимается в один continuous concept и интерливится с hidden states:
[z₁, c₁, z₂, c₂, …], идёт в f;— общий лосс получается равен — СЕ_tokens + \lambda * CE_concepts
В итоге достигают того же качества по PPL, что и модели, обученные просто на задачу NTP, но за меньшее — на 21,5% — количество токенов. По бенчмаркам (HellaSwag / PIQA / SIQA / ARC-e / WinoGrande / LAMBADA / WikiText) получается стабильно лучше, чем аналогичная модель, но обученная на NTP задачу.
Для извлечения концептов можно использовать модель меньшего размера, чем ту, которую хотим претрейнить, качество при этом не страдает.
В таком сетапе получается, что на каждый токен последовательности добавляется вектор-концепт, что увеличивает длину контекста в два раза. Авторы проверяли свой метод на контексте в 1024 токена, поэтому с проблемой нехватки контекста не столкнулись.
Интересное увидели ❣ Роман Горб, Денис Кузнеделев и Дмитрий Масный
#YaICLR26
ML Underhood