Scaling Laws for Looped Mixture of Experts
📄 Статья
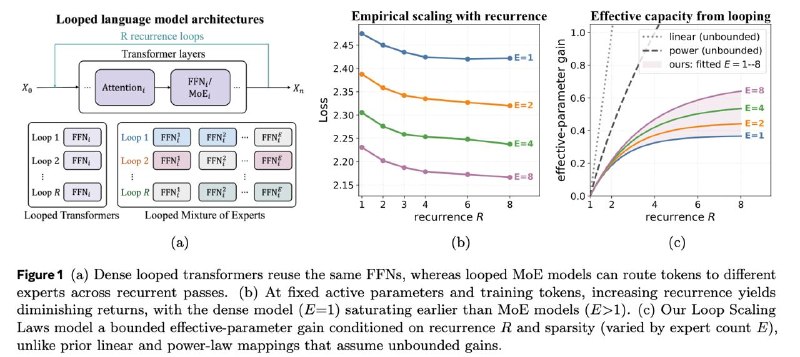
Есть MoE, которые как-то скейлятся (по разреженности / гранулярности).
Есть Looped-модели, где несколько прогонов дают качество потенциально выше, чем однократный прогон.
И для них по отдельности есть свои законы масштабирования.
Но если мы хотим Looped MoE, то как скейлить разреженность и число рекурсий?
И данная работа подбирает некий анзатц, который неплохо согласуется с экспериментом, и выводит правила оптимального масштабирования при заданном размере модели и вычислительном бюджете на обучении.
Post #848
656