Квантование & Прунинг & Дистилляция
Блог про сжатие сетей и не только.
От древнейших времен по настоящее время.
Группа с комментариями:
@quant_prune_distill_comments
Post #849
630
🛠 Метод
Типичный scaling law имеет вид:
L(N, D) = A N^α + B D^β + c
🔄 Скейлинг по рекурсии
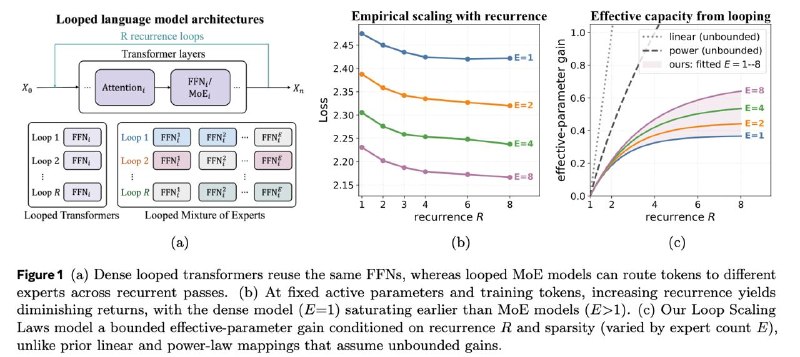
Ранее делали попытки вывести scaling law для looped-моделей, считая, что эффективное количество параметров N_eff масштабируется линейно с глубиной рекурсии либо убывает как-то степенным образом. Но на практике на самом деле быстро наступает насыщение, потому авторы предлагают экспоненциальное затухание, ограниченное сверху (κ₁, κ₂ — некоторые константы, R — глубина рекурсии).
N_eff(R) = N + κ₁ N_loop (1 − e^(−(R−1)/κ₂))
И опыт показывает, что такое лучше согласуется с экспериментом.
🧩 Скейлинг по рекурсии для MoE
Для MoE ситуация несколько интереснее, потому что при повторном прогоне могут активироваться другие эксперты, потому несколько прогонов могут извлечь больше информации. В пределе бесконечного числа экспертов ожидаем, что эффективное число параметров должно линейно масштабироваться с глубиной рекурсии. Отсюда возникает идея сделать константы κ₁, κ₂ функциями от m — разреженности модели.
N_eff(R, m) = N_act + κ₁(m) N_loop (1 − e^(−(R−1)/κ₂(m)))
κⱼ(m) = κⱼ m
🧪 Эксперименты
Дабы проверить на практике свои законы масштабирования, авторы обучают семейство моделей разного размера на разном количестве данных, с разным числом экспертов и глубиной рекурсии. Смотрят на валидационный лосс.
📈 Наблюдение 1. Масштабирование рекурсии приводит к выходу на плато, но чем больше экспертов, тем выше польза (прирост N_eff против R = 1).
⏳ Наблюдение 2. Чем дольше мы учим и чем больше разреженность, тем полезнее делать больше рекурсий.
💾 Наблюдение 3. Чем больше у нас VRAM и рекурсия, тем выгоднее иметь высокую разреженность.
⚖️ Наблюдение 4. При фиксированном бюджете на вычисления при нехватке памяти лучше инвестировать в рекурсию, при обилии — в разреженность MoE.
Потом пытаются понять, как это скажется на масштабе при обучении на downstream.
Учат бейзлайновый MoE и вдвое меньший как по числу активных, так и по числу общих параметров. При фиксированном бюджете обучения удаётся выжать около паритета при R = 4, 5 на MMLU/GSM8k, но уступая всё же в среднем по бенчам.
💡 Выводы
Вопрос оптимального масштабирования Looped MoE, безусловно, интересен, ибо потенциально даёт путь к более мощным, но компактным по общему числу параметров моделям. Однако, судя по экспериментам, всё же при заданном числе FLOPs на инференсе при том же претрейне Looped-модель будет слабее более жирной.
- ❤ 2