
Language Models Can Control Their Own Attention 🧠
📄 Статья
В современных LLM большинство слоев, смешивающих токены, представляют собой более дешевые (в сравнении с классическим attention) по длине последовательности GDN, SSM-ки или внимание со скользящим окном.
Тем не менее, full attention-слои пока еще не полностью канули в Лету и все еще перетягивают на себя значительную часть объема вычислений на длинных последовательностях.
Однако для предсказания следующего токена редко нужен весь прошлый контекст: внимая малому числу токенов, можно дать верный ответ. Но как найти это малое число токенов? Есть обучаемые селекторы, как в последних DeepSeek, MiniMax и Qwen.
Но что, если сама LLM знает, что ей надо? 🤔
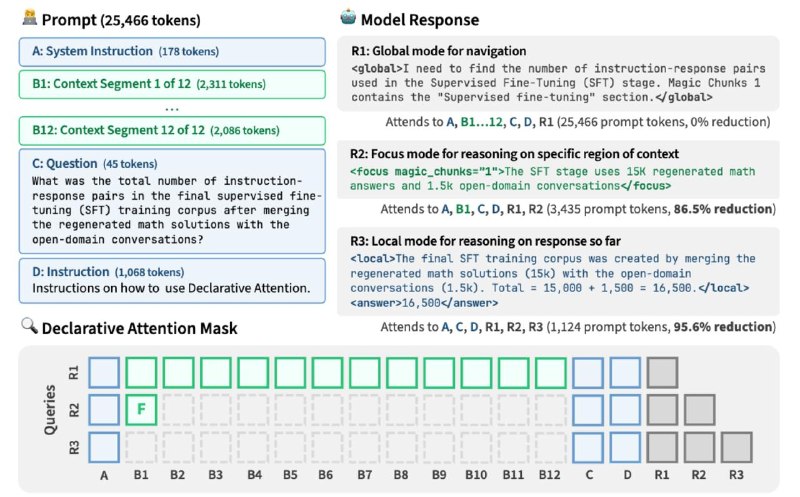
И авторы предлагают модели самой выбрать, куда смотреть (Declarative Attention), и при этом без специального обучения.
Post #834
1.54K
- 👍 4
- 🔥 2