TGViewer
КПД КПД @quant_prune_distill · 3.49K subscribers
Post #719 1.54K
FreeKV: Boosting KV Cache Retrieval for Efficient LLM Inference
[Статья] [Код]
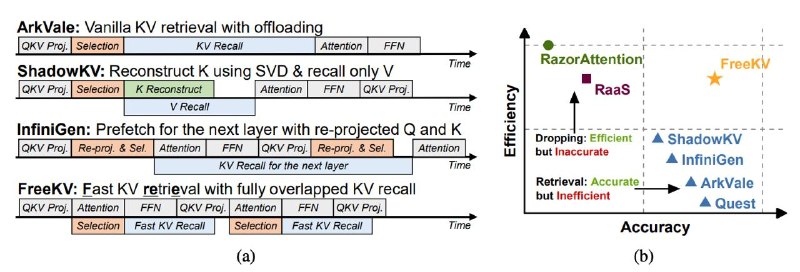
Есть две популярные техники сжатия KV-кэшей (вообще говоря гораздо больше, но далее рассказ затронет только эти две):

💣 KV-Cache Pruning/Eviction - убирающий наименее полезные токены
🦾 KV-Cache Offloading - сгружающий KV-кэш в более медленную, но обьемную память RAM

Первый из них потенциально дает некоторое ускорение, но на практике определять важные/неважные токены сложно, из-за чего имеют место заметные просадки в качестве. Оффлоадинг потенциально сохраняет качество, но замедляет инференс из-за дорогостоящего трансфера данных из CPU RAM в VRAM.

А в идеале хотелось бы чего-то быстрого и сохраняющего качество.
  • ❤ 7
  • 🔥 2
More from @quant_prune_distill
  1. Oct 6, 2026Совпадение? Не думаю!
  2. Oct 5, 2026Теперь уже даже время прочтения блога это ориентир не для человека, а для LLMки. https://r…
  3. Oct 4, 2026"Горячие" эксперты
  4. Oct 4, 2026photo post
  5. Oct 1, 2026🛠 Метод Типичный scaling law имеет вид: L(N, D) = A N^α + B D^β + c 🔄 Скейлинг по рекурс…
  6. Oct 1, 2026Scaling Laws for Looped Mixture of Experts 📄 Статья Есть MoE, которые как-то скейлятся (п…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →