по всем вопросам @workakkk
@itchannels_telegram - 🔥 все ит каналы
@ai_machinelearning_big_data -ML
@ArtificialIntelligencedl -AI
@datascienceiot - 📚
@pythonlbooks
РКН: clck.ru/3FmxmM
Post #4298
12.2K


👩💻 Pdf-extract-API
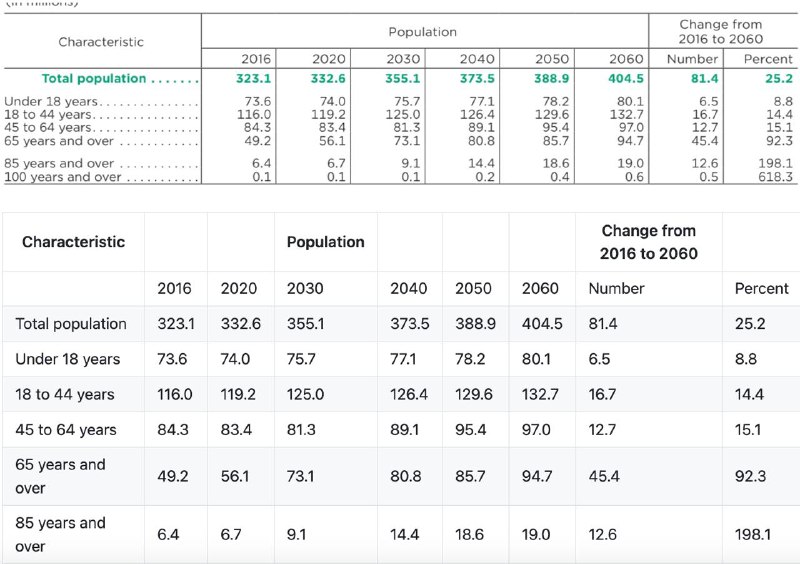
Этот Python проект представляет собой инструмент для преобразования изображений и PDF-документов в текст в формате Markdown и JSON с высоким уровнем точности.
💡 Поддерживаются табличные данные и математические формулы.
В основе проекта лежит использование FastAPI, а для асинхронной обработки задач применяется Celery.
Для кэширования результатов оптического распознавания символов (OCR) используется Redis.
В проекте реализованы разные методы конвертации, среди которых Marker, Surya-OCR и Tesseract. Также предусмотрена функция удаления персональных данных.
✔️ Установка:
🖥 Код
@pythonl
Этот Python проект представляет собой инструмент для преобразования изображений и PDF-документов в текст в формате Markdown и JSON с высоким уровнем точности.
💡 Поддерживаются табличные данные и математические формулы.
В основе проекта лежит использование FastAPI, а для асинхронной обработки задач применяется Celery.
Для кэширования результатов оптического распознавания символов (OCR) используется Redis.
В проекте реализованы разные методы конвертации, среди которых Marker, Surya-OCR и Tesseract. Также предусмотрена функция удаления персональных данных.
✔️ Установка:
git clone https://github.com/CatchTheTornado/pdf-extract-api.git
cd pdf-extract-api
🖥 Код
@pythonl
- 👍 38
- ❤ 7
- 🔥 7