TGViewer
Channel Public Channel
Python/ django

Python/ django

@pythonl

по всем вопросам @workakkk

@itchannels_telegram - 🔥 все ит каналы

@ai_machinelearning_big_data -ML

@ArtificialIntelligencedl -AI

@datascienceiot - 📚

@pythonlbooks

РКН: clck.ru/3FmxmM
Subscribers
58.5K
Photos
2.6K
Videos
200
Links
3.3K

Showing posts older than #3657 · Back to latest

Older Posts 14 shown
Post #3656 7.85K
Вышла Django 5.0 🔥

Что добавили/обновили/исправили?

• В предыдущих версиях мы использовали nulls_last=False. Теперь nulls_first и nulls_last могут быть True или None. Поэтому теперь в некоторых местах вместо значения по умолчанию находится nulls_last = None


- nulls_last = False
+ nulls_last = None
if ordering_by == OrderingField.FIELD_START_AT:
nulls_last = True


• В сигналах появился новый тип асинхронных ресиверов async_receivers. Его добавили в класс SignalBlocker, теперь он временно отключает сигнал.

• Если после refresh_from_db надо дальше по коду использовать закешированные значения из базы данных, появился такой хак:

my_model_obj._meta.private_fields = []
my_model_obj.refresh_from_db()


https://docs.djangoproject.com/en/5.0/releases/5.0/

@pythonl
  • 👍 10
  • ❤ 5
  • 🔥 1
  • 😁 1
  • 🤩 1
Post #3654 6.95K
🖥 VS Code, python, контейнеры — как обуздать эту триаду и разрабатывать внутри контейнера

⏩Держите небольшой, но очень полезный туториал о настройке VS Code для работы с контейнерами при помощи Python.
После того, как вы всё настроете по примеру из статьи останется только нажать F1, и в появившейся строке ввода ввести "Open folder in container". После этого выбрать корневую папку проекта. После чего запустится сборка контейнера и папка откроется внутри контейнера.

📎 Статья

@pythonl
  • 🔥 10
  • ❤ 8
  • 👍 4
Post #3652 6.01K
⚡️ MindGraph

Демонстрационный прототип концепции для создания и обработки запросов к постоянно расширяющемуся графу знаний с помощью искусственного интеллекта.

▪ Github
  • ❤ 8
  • 👍 6
  • 🔥 2
Post #3650 7.31K
🖥 Форк Newspaper4k продолжает развитие библиотеки Newspaper3k

⏩Библиотека Newspaper3k для Python 3 предназначена для скрейпинга и автоматического парсинга новостных статей. С 2018 года проект не обновляется. Разработчик Андрей Параскив представил проект-форк Newspaper4k, в рамках которого он планирует закрывать баги и продолжать улучшать работу библиотеки.

⏩Newspaper предназначена для парсинга статей с новостных сайтов. Все данные Newspaper обрабатывает в Юникоде и поддерживает 38 языков, включая русский. В библиотеку встроены автоматические парсеры с механизмами естественной обработки языка. Кстати, поэтому этот проект часто рекомендуют с припиской «искусственный интеллект». Основная задача библиотеки — извлечь релевантные данные (заголовок, автор, тело статьи, изображения, тэги, краткие пересказы и прочее), убрав ненужные элементы и тексты-заглушки, которые не несут полезной информации.

⏩По качеству работы Newspaper и Newspaper3k сравнивали с сервисом социальных закладок Instapaper. Хотя Оу-Ян поделился подробной документацией, библиотека доросла до того, что к ней писали сторонние руководства. Некоторые из них остались на GeeksforGeeks и ScrapeOps: это инструкции по скрейпингу с помощью Newspaper3k.

🖥 GitHub

@pythonl
  • 👍 18
  • 🔥 3
  • ❤ 1
Post #3648 6.53K
🖥 HTTP-запросы и обработка JSON в Python: API Google Directions

⏩Для выполнения HTTP-запросов и обработки JSON в Python используйте модуль requests:
import requests

response = requests.get('https://api.example.com/end-point')
data = response.json()

Замените 'https://api.example.com/end-point' на необходимый API endpoint. Прежде чем приступить к обработке данных, проверьте, был ли запрос успешным.


⏩Составление продуктивных HTTP-запросов. Для более продвинутых запросов передавайте параметры в requests.get() используя словарь, чтобы избежать конкатенации строк:
params = {'origin': 'Нарния', 'destination': 'Хогвартс', 'waypoints': 'Средиземье|Мордор', 'sensor': 'false'}
response = requests.get('https://maps.googleapis.com/maps/api/directions/json', params=params)

Важно: значение waypoints должно быть указано в виде одной строки, например, 'Средиземье|Мордор'.


⏩Тщательное извлечение данных из JSON

После получения ответа, преобразуйте JSON с помощью метода .json() и проверьте код ответа:
data = response.json()
if response.status_code == 200:
from pprint import pprint
pprint(data) # Выведем данные структурированно для удобства
else:
print("Ошибка HTTP-запроса:", response.status_code)


⏩Обработка вложенных структур JSON

Обработка вложенных структур в JSON требует внимательного подхода. На Python это выполнимо:
for route in data['routes']:
for leg in route['legs']:
for step in leg['steps']:
print(step['html_instructions'])

Используйте циклы для перемещения по структуре данных.


⏩Важные моменты, которые надо запомнить
— Всегда проверяйте статус ответа.
— Применяйте метод .json(), а при необходимости — json.loads(response.content).
— Не ограничивайтесь в использовании параметров запроса: чем больше их, тем лучше.

@pythonl
  • 👍 20
  • 🔥 5
  • ❤ 3
Post #3644 8.07K
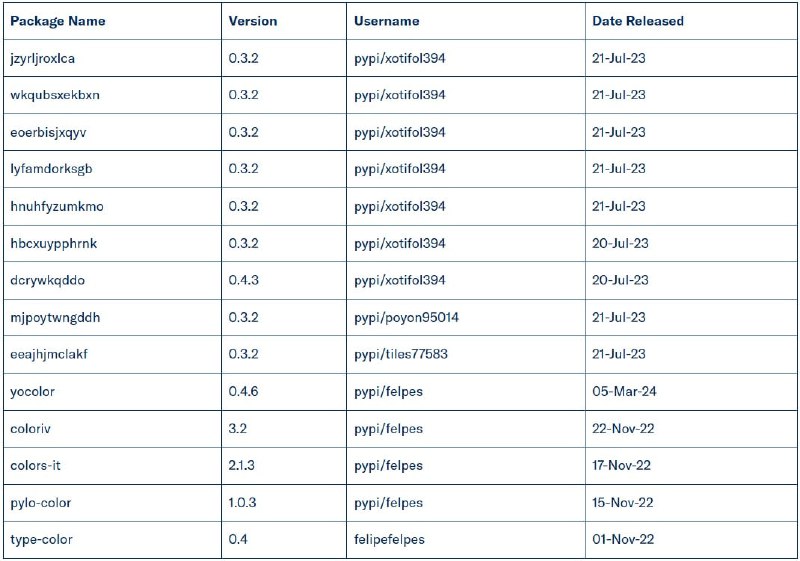
🖥 Python-разработчики подверглись сложной атаке на цепочку поставок

⏩Аналитики компании Checkmarx сообщили, что после загрузки вредоносного клона популярной утилиты Colorama несколько Python-разработчиков, включая сопровождающего Top.gg, оказались заражены малварью, похищающей информацию. По мнению специалистов, основной целью кампании, скорее всего, была кража данных и их последующая монетизация.

⏩Атака началась аж в ноябре 2022 года, когда хакеры впервые загрузили вредоносные пакеты в Python Package Index (PyPI). В последующие годы на PyPI было добавлено еще больше пакетов с малварью. Все они были похожи на популярные опенсорсные инструменты, что повышало вероятность их попадания в результаты поисковых систем.

⏩Утилита Colorama, которую в числе прочих подделали злоумышленники, обеспечивает работу последовательностей символов ANSI в Windows и в настоящее время насчитывает более 150 млн загрузок ежемесячно.

⏩Чтобы организовать атаку на цепочку поставок, хакеры клонировали эту утилиту, внедрили в нее вредоносный код и разместили вредоносную версию на поддельном домене. Благодаря тому, что атакующие использовали тайпсквоттинг, сайт хакеров (files.pypihosted[.]org) походил на легитимное зеркало files.pythonhosted.org.

⏩Для распространения вредоносного пакета злоумышленники не только создали вредоносные репозитории под собственными учетными записями, но также взломали ряд известных аккаунтов. В их числе был GitHub-аккаунт editor-syntax, поддерживающий платформу для поиска и обнаружения серверов, ботов и других социальных инструментов в Discord, Top.gg, сообщество которой насчитывает более 170 000 участников.

⏩Аккаунт, скорее всего, был взломан через украденные cookies, которые злоумышленники использовали для обхода аутентификации и выполнения вредоносных действий, при этом не зная пароля аккаунта. В результате взлома пострадали несколько членов сообщества Top.gg.

📎 Читать подробнее

@pythonl
  • ❤ 9
  • 😱 7
  • 👍 1
  • 🔥 1
Post #3643 6.1K

Forwarded from Zen of Python

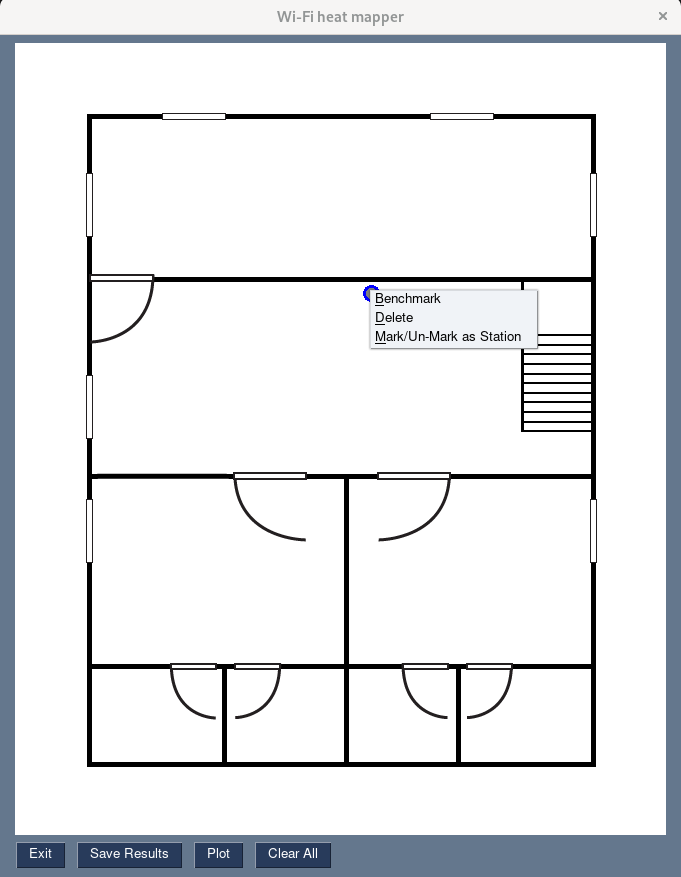
​​Бенчмарк Wi-Fi сетей на wifi-heat-mapper

wifi-heat-mapper — питонская версия Wi-Fi Analyzer, позволяющая не только визуализировать силу сигнала, но и рассчитывать мощность в любой точке помещения

#библиотека

@zen_of_python
  • 🔥 9
  • ❤ 2
  • 👍 1
Post #3639 8.26K
🖥 Шпаргалка для подготовки к собеседованию Python

Держите, это нереальная квинтэссенция примеров кода, паттернов, покрывает 99% того, что могут спросить на собеседовании
Объём всей шпаргалки приличный, редактор показывает, что время чтения 96 минут)

📎 Шпаргалка
Enjoy)

@pythonl
  • 👍 24
  • 🔥 6
  • ❤ 5
Post #3637 5.73K
🖥 Spelling Correction with Python

Исправление орфографии с помощью Python

@pythonl
  • 👍 30
  • 🔥 6
  • ❤ 3
  • 😁 2
Post #3636 6.29K
🖥 PyPI приостановил регистрацию новых пользователей и проектов из-за всплеска вредоносных публикаций

⏩Репозиторий Python-пакетов PyPI (Python Package Index) временно запретил регистрацию новых пользователей и создание новых проектов из-за непрекращающейся массовой загрузки вредоносных пакетов в ходе автоматизированной атаки. Блокировка была введена после того, как 26 и 27 марта в репозиторий было загружено 566 пакетов с вредоносным кодом, стилизованных под 16 популярных Python-библиотек.

⏩Имена пакетов сформированы с использованием тайпсквотинга, т.е. назначение похожих имён, отличающихся отдельными символами, например, temsorflow вместо tensorflow, requyests вместо requests, asyincio вместо asyncio и т.п. При проведении подобных атак злоумышленники рассчитывают на невнимательных пользователей, совершивших опечатку или не заметивших отличий в названии при поиске или переходе по ссылке из форумов и чатов, в которых злоумышленники оставляют обманные инструкции.

Будьте аккуратнее, когда качаете что-то через pip)

@pythonl
  • 👍 36
  • 😢 6
  • 🔥 2
  • ❤ 1
Post #3635 6.31K
🖥 Руководство по веб-скрейпингу на Python

Отличная статья, в которой описывается создание надёжных веб-краулеров с использованием таких библиотек, как BeautifulSoup.
Рассказывается про техники, позволяющие преодолевать реальные трудности при скрейпинге, а также даются рекомендации по крупномасштабному скрейпингу.

После прочтения вы получите ценную информацию для скрейпинга сложных сайтов и решения проблем, которые касаются ограничений частоты запросов, блокировок и генерируемых при помощи JavaScript страниц.
Пользуйтесь)

📎 Статья

@pythonl
  • 👍 20
  • ❤ 4
  • 🔥 3
Post #3634 6.98K
🖥 Отладка Python кода в PyCharm

Держите полезный туториал по дебаггингу кода в PyCharm.

⏩Описывается процесс запуска программы в режиме Debugging и установка точек останова (Breakpoints).

⏩Рассматриваются различные окна и кнопки в интерфейсе дебаггера для анализа кода и пошагового выполнения.

⏩Обсуждаются ошибки в коде и способы их исправления с помощью дебаггера.

⏩Упоминается возможность автоматической остановки выполнения кода в строке с ошибкой.

⏩Описывается использование окна Watches для просмотра результатов выражений и функций.

📎 Туториал

@pythonl
  • 👍 16
  • ❤ 4
  • 🔥 3
Post #3632 8.26K
🖥 Cheatsheet по Pandas

Держите годную шпаргалку по работе с библиотекой Pandas, тут описано самое основное, что может понадобиться в работе:

⏩Группировка данных по заданным параметрам.

⏩Объединение нескольких таблиц в одну сводную.

⏩Очищение данных от дубликатов и невалидных строк или столбцов.

⏩Вывод определенных значений по фильтрам или уникальности.

⏩Использование агрегирующих функций, включая подсчет значений, суммы элементов, определение среднего значения.

⏩Визуализация собранных данных.

Пользуйтесь)

@pythonl
  • 👍 23
  • 🔥 4
  • ❤ 3
Post #3630 6.08K
🖥 Designing a Pure Python Web Framework

Reflex — Разработка веб-приложений на чистом Python.

Библиотека, котороя упрощает разработку приложений с помощью инструментов командной строки для инициализации и запуска проектов. Изначально инструмент был выпущен под названием Pynecone.

Недавно была выпущена новая версия Reflex 0.4.0, которая включает в себя следующие улучшения:
- Запуск сервиса хостинга с возможностью бесплатного размещения приложений.
- Руководство по созданию клонов ChatGPT с использованием Reflex.
- Новые ключевые компоненты на основе Radix UI с единой системой тем.
- Расширенные руководства по интеграции настраиваемых компонентов React.

pip install reflex

▪Документация
▪GitHub
▪Гайд с примерами

@pythonl
  • 🔥 13
  • 👍 8
  • ❤ 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →