TGViewer
Channel Public Channel
MLinside - школа ML

MLinside - школа ML

@ml_inside

Предзапись на 5 поток курса "База ML": https://forms.yandex.ru/cloud/6a4275fe505690a71a0fead6
Наши курсы: https://taplink.cc/mlinside
Чат коммьюнити: @ml_insidechat
По вопросам: @marinagartm
Subscribers
4.05K
Photos
282
Videos
26
Links
242

Showing posts older than #524 · Back to latest

Older Posts 20 shown
Post #523 1.54K
MLinside - школа ML Обучаем первую модель машинного обучения за час Кажется, что машинное обучение – это что-то очень сложное? Множество формул, непонятная математика и тысячи строк кода? На самом деле начать можно гораздо проще. В четверг, 9 июля в 19:00 (МСК) приглашаем…
Вебинар уже начался, подключайтесь!

https://mlinside.getcourse.ru/pl/webinar/show?id=3302056&view=1
Post #522 2.1K
Ищем участника для открытого ML-собеседования

Если вы уже изучаете машинное обучение, но пока не работаете ML-инженером, приглашаем подать заявку.

Ищем человека с базовыми знаниями ML – не новичка с нуля, но и не действующего ML-инженера. Главное – желание получить честную обратную связь и не бояться разбирать свои ответы публично.

Если готовы поучаствовать, заполните форму: https://forms.yandex.ru/cloud/6a4b8211d04688001e046a73

Из всех заявок выберем одного участника и свяжемся с ним.
  • 🔥 4
  • ❤ 3
Post #521 1.64K
MLinside - школа ML Метрики выросли. Код работает. Можно катить в прод? Если вы не можете ответить «да» с цифрами в руках – вы не закончили работу. Вы её только начали. Чтобы отвечать на этот вопрос уверенно, в специализации появился новый блок, посвящённый A/B-тестированию.…
  • ❤ 5
  • 🔥 3
Post #520 1.5K
Метрики выросли. Код работает. Можно катить в прод?

Если вы не можете ответить «да» с цифрами в руках – вы не закончили работу. Вы её только начали.

Чтобы отвечать на этот вопрос уверенно, в специализации появился новый блок, посвящённый A/B-тестированию. В нём всё, что нужно, чтобы грамотно проектировать эксперименты, анализировать их результаты и понимать, действительно ли изменения приносят пользу продукту.

Зачем это вам:
Даже если метрики выросли, это ещё не означает, что новая модель лучше. Разница в 0,3% может оказаться обычной случайностью, а команда потратит месяцы на оптимизацию, которая не приносит значимой пользы.

Именно A/B-тестирование помогает отделить реальные улучшения от статистического шума и понять, действительно ли изменения работают.

В новом блоке вас ждут 24 урока и 7 часов практики, на которых разберём:

▪️Основы экспериментов:
— как проектировать A/B-тесты;
— какие статистические критерии выбирать;
— какие ошибки чаще всего допускают и как их избежать.

▪️Продвинутые методы:
— бутстрэп и доверительные интервалы;
— ускорение экспериментов с помощью CUPED;
— последовательный анализ на практике.

▪️Индустриальную практику:
— инструменты продуктовых команд: GrowthBook и аналоги;
— реальные кейсы из индустрии, включая опыт МТС.

Что в итоге:
Это один из тех блоков, после которого меняется сам подход к работе с ML-моделями. Вместо «кажется, стало лучше» вы сможете проектировать эксперименты, выбирать корректные статистические критерии, интерпретировать результаты и принимать решения на основе данных.

Новый блок по A/B-тестированию уже доступен в специализации «AI и анализ данных».

Переходите по ссылке, чтобы посмотреть полную программу, сравнить варианты подписки и выбрать подходящий формат обучения: https://mlinside.ru/specializaciya/?utm_source=telegram&utm_medium=social&utm_campaign=post_anons-blok-5
  • ❤ 6
  • 🔥 3
Post #519 1.36K
Прямой эфир с Виктором Кантором и Валерием Бабушкиным уже начался!

Трансляцию перенесли на GetCourse: https://mlinside.getcourse.ru/pl/webinar/show?id=3302131&view=1

Ещё можно присоединиться к эфиру и задать свой вопрос в чате.
  • ❤ 7
Post #516 2.29K
Обучаем первую модель машинного обучения за час

Кажется, что машинное обучение – это что-то очень сложное? Множество формул, непонятная математика и тысячи строк кода?

На самом деле начать можно гораздо проще.

В четверг, 9 июля в 19:00 (МСК) приглашаем на вебинар «Обучаем первую модель машинного обучения за час» где спикер – Андрей Жогов, ML-инженер в Сбере и преподаватель Физтеха сделает именно то, что указано в названии.

Андрей не только работает ML-инженером в Сбере, но и имеет большой опыт обучения начинающих специалистов. До Сбера он занимался задачами машинного обучения в МТС, а сегодня ведёт семинары по ML и помогает студентам делать первые шаги в профессии.

На вебинаре вы увидите, как выглядит обучение модели машинного обучения на практике, и поймёте, что первый шаг в ML может оказаться гораздо проще, чем кажется.

Этот вебинар будет особенно полезен, если вы:
▪️хотите войти в ML, но не знаете, с чего начать;
▪️уже изучаете Python и хотите перейти к машинному обучению;
▪️давно откладываете знакомство с ML, потому что кажется, что это слишком сложно.

Участников вебинара ждет небольшой, но приятный бонус, о нем расскажет Андрей на самом вебинаре.

Итак, четверг, 9 июля, 19:00 (МСК), регистрируйтесь заранее: https://t.me/ml_insideBot?start=web090726
  • 🔥 3
Post #513 25.9K
Перенос старта курса и прямой эфир с Виктором Кантором и Валерием Бабушкиным

Старт курса ML System Design переносится на 17 июля. Если вы планировали присоединиться, у вас появилось ещё немного времени, чтобы принять решение и подготовиться к обучению.

В следующий понедельник, 6 июля проведем на YouTube прямой эфир. Виктор задаст Валерию вопросы о ML System Design, а Валерий ответит на них и поделится своим опытом в проектировании ML-систем. Плюс, ответим на ваши вопросы.

О чем еще поговорим на эфире:
▪️зачем ML-инженеру вообще нужен System Design;
▪️как меняются требования к специалистам с развитием LLM и AI-агентов;
▪️как проектировать системы, а не только модели;
▪️какие навыки действительно востребованы в индустрии;

Если у вас есть вопросы про ML System Design, архитектуру ML-систем, production ML, карьеру, собеседования, LLM или обучение – напишите их в форме: https://forms.yandex.ru/cloud/6a44d2dff47e73beb4bf22b0.

Не упустите возможность задать свои вопросы топам ML-индустрии!

Регистрация на прямой эфир: https://t.me/ml_insideBot?start=web060726
  • ❤ 5
  • 👍 1
  • 👎 1
  • 🔥 1
Post #512 1.91K
«Кажется, я слишком поздно начал изучать ML»

Это одна из самых частых фраз, которые мы слышим от новых студентов.

Кто-то откладывал обучение несколько лет. Кто-то думал, что без сильной математики в машинном обучении делать нечего. Кто-то смотрел на вакансии и был уверен, что индустрия уже переполнена специалистами.

Но каждый новый поток показывает одно и то же: в ML приходят люди с очень разным опытом и стартовыми знаниями. Аналитики, разработчики, инженеры, менеджеры и даже те, кто раньше вообще не работал с данными.

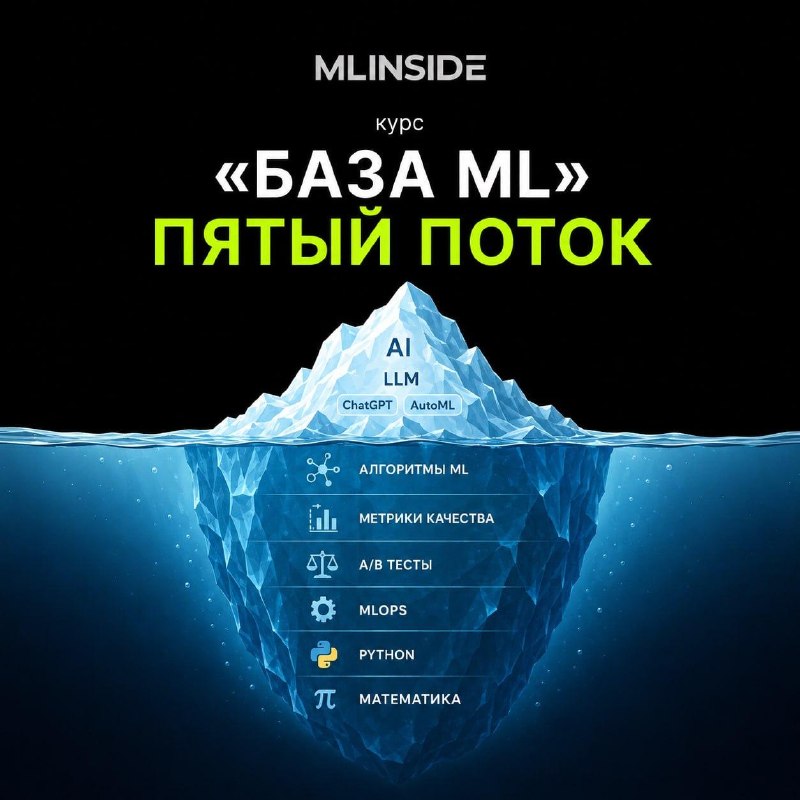
Главное не то, когда вы начали, а то насколько системно вы учитесь. И мы рады сообщить, что открываем набор на 5 поток курса «База ML».

Это курс для тех, кто хочет разобраться в машинном обучении последовательно и без бесконечных пробелов в знаниях. От основ Python и математики до построения собственных моделей и понимания того, как ML применяется в реальных продуктах.

За время обучения вы:
▪️освоите ключевые алгоритмы машинного обучения;
▪️научитесь работать с данными и строить модели на Python;
▪️разберетесь в метриках и оценке качества моделей;
▪️познакомитесь с нейронными сетями;
▪️поймете, как устроены современные ML-системы;
▪️выполните практические задания и соберете проект для портфолио.

В 5 потоке мы также усилили программу темами, которые сегодня активно используются в индустрии:
-применение AI-инструментов в работе ML-специалиста;
-основы ML System Design;
-разбор реальных бизнес-кейсов;
-больше практики и поддержки от кураторов.

Мы не обещаем, что путь будет простым. Машинное обучение требует времени, практики и настойчивости. Но если вы давно хотели разобраться в ML и не знали, с чего начать, сейчас хороший момент сделать первый шаг.

Набор на 5 поток уже открыт, заполните форму для предзаписи: https://forms.yandex.ru/cloud/6a4275fe505690a71a0fead6

Подробности о программе, формате обучения и тарифах на сайте: https://mlinside.ru/base-ml/?utm_source=telegram&utm_medium=social&utm_campaign=anons_29_06_2026

А если у вас есть вопросы о курсе, задавайте их в комментариях. Постараемся ответить на каждый.
  • ❤ 2
  • 👍 2
  • 🔥 2
Post #510 1.8K
Учимся на практике: решаем реальные ML-задачки

Это рубрика #петпроект_MLinside и тут мы публикуем задачи из реальных (ну или почти реальных) проектов, чтобы лучше запомнить теорию. Плюс, упоминание об этом можно включить в портфолио, что определенно поможет вам на собеседованиях.

Пятнадцатая задача

Что нужно сделать:
По различным параметрам и результатом анализов женщины определить есть у нее диабет или нет

Как можно сделать:
▪️Построить confusion matrix для нескольких признаков, посмотреть есть ли между ними зависимость или нет
▪️Обучить классификаторы на данных
▪️Посмотреть на важность признаков, если некоторые зависят друг от друга и важны, то попробовать их как-то разделить и обучить классификатор снова
▪️или сделать что-то другое

Данные можно взять на Kaggle: https://www.kaggle.com/datasets/uciml/pima-indians-diabetes-database

Пример ноутбука (с случайными пропусками строк): https://colab.research.google.com/drive/1NZXRFcxHAR-RABH7cEplpUd4wX67dibw?usp=sharing

Готовы попробовать? Делитесь своими результатами в комментариях. А другие посты этой рубрики можно посмотреть по тэгу: #петпроект_MLinside
  • ❤ 8
Post #509 1.83K
Кажется, что к собеседованию по ML нужно заново выучить всю математику?

На практике это не так. Большинство математических вопросов на интервью связаны не со сложными доказательствами и выводами формул, а с пониманием того, как работают модели, метрики и эксперименты.

У нас на YouTube, в ВК и Дзен вышло видео, где Александр Дубейковский (ML Engineer в Avito, ex-Yandex, эксперт MLinside) расскажет, какие математические темы чаще всего встречаются на ML-собеседованиях, как быстро восстановить знания перед интервью и почему решение задач работает намного лучше, чем чтение учебников в последний момент.

Кому будет полезно это видео:
▪️Тем, кто готовится к ML-собеседованиям
▪️Junior и Middle ML-инженерам
▪️Data Scientists
▪️Студентам, ищущим первую работу в ML
▪️Всем, кто давно не открывал математику и хочет быстро освежить знания

Нашли себя в этом списке? Тогда велком на удобную площадку:
https://youtu.be/LQif1TY84s0?is=PyaQPNF08kmPMe9w
https://vkvideo.ru/video-228219607_456239242
https://dzen.ru/video/watch/6a3d7bbb2dd9ef51bfaa2a60?share_to=link
  • 👍 2
  • 🔥 1
Post #507 2.11K
Это рубрика «ML в реальной жизни» и у нас третья задача

Мы продолжаем нашу рубрику, где задаем ситуации, с которыми сталкиваются ML/DS-команды в продакшене. В этой рубрике нет единственно правильных ответов. Её цель – научиться рассуждать, обсуждать подходы и смотреть на проблемы с разных сторон.

Поэтому, если хотите, чтобы рубрика была вам максимально полезна, в комментариях важно не просто выбрать вариант, а объяснить:
— почему выбрали именно его
— что бы вы проверяли
— какие риски вы бы учитывали

Сегодня у нас ситуация №3:

Ситуация: Модель молча сломалась

Контекст:
Модель в продакшене перестала обновлять прогнозы. Логи в норме, ошибок нет, пайплайн "зелёный". Но свежие предсказания не появляются. Вы подозреваете тихий сбой: завис джоб, кончилось место, изменился формат входных данных – но где именно, непонятно.

Варианты действий:
Что будете делать в первую очередь?

Все посты этой рубрики можно будет посмотреть по тэгу: #риллайф_MLinside
Post #506 8.36K
А у нас там подкаст вышел, видели?

Если вдруг нет, то заходите на YouTube, в ВК или Дзен, там увидите подкаст Виктора Кантора и Татьяны Гайнцевой – AI Researcher и PhD-кандидат в Queen Mary University of London, исследовательница в области интерпретируемости и управления поведением генеративных моделей. Обладательница стипендии DeepMind, преподаватель Deep Learning School и Nebius Academy, соосновательница Deep Learning School, автор телеграм-канала DLStories и подкаста Deep Learning Stories. Ранее занималась исследованиями в Huawei и Philips, работая над задачами компьютерного зрения и медицинского AI.

В выпуске разговор получился не столько про карьеру в AI, сколько про исследовательское мышление. Почему одни специалисты годами улучшают метрики моделей, а другие пытаются понять, что происходит внутри них? Зачем вообще исследовать интерпретируемость нейросетей? Можно ли управлять поведением LLM через активации отдельных слоев? И почему иногда самый интересный вопрос в машинном обучении – не «как сделать лучше», а «почему это вообще работает»?

Ждём вас на удобной для вас площадке:
https://youtu.be/pXMd0N6xSAQ
https://vk.com/video-228219607_456239235
https://dzen.ru/video/watch/6a314bf1a6d473684e1eb721
  • ❤ 15
Post #504 1.95K
9 июля пройдет форум Data Day 2026 — одно из крупнейших событий про данные, аналитику и AI.

На форуме обсудят:
— как бизнес использует data-driven подходы,
— реальные кейсы внедрения AI и аналитики,
— тренды рынка,
— практику команд и компаний, которые уже строят решения на данных.

Соберутся сильные эксперты, практики и лидеры индустрии — будет много прикладного контента и полезного нетворкинга.

🎫 И у вас есть возможность попасть на форум бесплатно.

Для этого нужно подписаться на каналы спикеров и организаторов через бота.

Чтобы получить билет, переходите в бота.

👉 Посмотреть программу и состав спикеров можно на сайте Data Day
  • ❤ 7
  • 👍 2
  • 🔥 2
Post #503 2.19K
Учимся на практике: решаем реальные ML-задачки

Это рубрика #петпроект_MLinside и тут мы публикуем задачи из реальных (ну или почти реальных) проектов, чтобы лучше запомнить теорию. Плюс, упоминание об этом можно включить в портфолио, что определенно поможет вам на собеседованиях.

Четырнадцатая задача

Что нужно сделать: По разным параметрам сделать классификатор уволится человек с работы или нет (переменная attrition)

Как можно сделать:
▪️Обучить классификатор на всех данных
▪️Определить при каких значениях разных переменных человек с большой вероятностью уволится. Определить топ 5 для каждого уровня образования, посмотреть насколько этот топ меняется
▪️Определить насколько важен ворк/лайф баланс
▪️Обучить свой классификатор увольнения для каждого значения переменной PerformanceRating, изменился ли топ 5 значимых переменных в этих классификатор по сравнению с топ 5 у общей модели
▪️или сделать что-то другое

Данные можно взять на Kaggle: https://www.kaggle.com/datasets/pavansubhasht/ibm-hr-analytics-attrition-dataset

Пример ноутбука (с случайными пропусками строк): https://colab.research.google.com/drive/1tAgD5KleAkCtYHKI0uUHWTfW1ucDv5ZX?usp=sharing

Готовы попробовать? Делитесь своими результатами в комментариях. А другие посты этой рубрики можно посмотреть по тэгу: #петпроект_MLinside
  • ❤ 5
Post #502 1.99K
Если вы открыли курс по Machine Learning (или любой другой курс) и через 15 минут поняли, что не понимаете вообще ничего...

...то видео, которое у нас вышло на YouTube, в ВК и Дзен будем вам полезно. Большинство людей думают, что проблема в них: "не хватает таланта", "слишком поздно начал", "ML не для меня". Но на практике почти все специалисты проходили через этот этап. Машинное обучение объединяет программирование, математику, статистику и работу с данными, поэтому первое время мозгу просто не на что опереться.

Александр Дубейковский (ML Engineer в Avito, ex-Yandex, эксперт MLinside) расскажет, почему непонимание это нормальная часть обучения, как правильно изучать сложные темы и что делать, если очередной урок кажется набором незнакомых слов.

Кому будет полезно это видео
▪️Тем, кто только начинает изучать Machine Learning
▪️Студентам онлайн-курсов по ML и Data Science
▪️Разработчикам и аналитикам, которые переходят в AI
▪️Тем, кто думает бросить обучение из-за сложных тем
▪️Всем, кто хочет выстроить правильную стратегию обучения

Если вы тоже сталкивались с ощущением, что "ничего не понятно", напишите в комментариях, какая тема в ML оказалась для вас самой сложной.
  • 👍 9
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →