TGViewer
Machine learning Interview Machine learning Interview @machinelearning_interview · 30.3K subscribers
Post #1379 4.42K
📌Методология оценки LLM

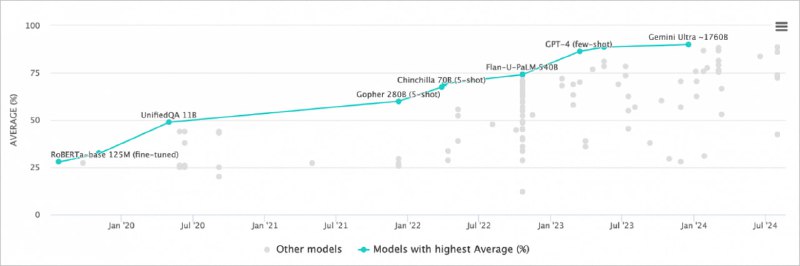
На Хабре вышла статья о современных подходах к оценке языковых моделей. Традиционно используются академические методы оценки (школьные тесты, профэкзамены) и специальные бенчмарки вроде COPA, PIQA для проверки базового понимания контекста, но они не отражают реальной ценности моделей в бизнес-задачах — способности к диалогу, переводу или генерации идей.

Для решения этой проблемы, например, в Яндексе разрабатывают внутренние бенчмарки под каждую практическую задачу YandexGPT, учитывая, что стандартные тесты подвержены протечкам данных и быстро устаревают. Для комплексной оценки привлекаются AI-тренеры — специалисты со строгим отбором по навыкам фактчекинга.

Ключевой вывод: нет универсального метода оценки, необходимы постоянный анализ данных и ручная разметка.

📌 Оригинал

@machinelearning_interview
  • 👍 10
  • ❤ 6
  • 🔥 3
  • 👌 2
More from @machinelearning_interview
  1. Oct 9, 2026🧠 ИИ, который сразу выбирает ответ K2-Type-0.9B от IFM получает контекст в виде текста ил…
  2. Oct 9, 2026Извлечь текст из PDF мало. LightOnOCR-3 достаёт ещё и данные из графиков 📄 LightOn выпуст…
  3. Oct 8, 2026⚡ Liquid AI открыла веса двух моделей, которые принимают решения без генерации текста. d1…
  4. Oct 8, 2026Как мы перешли от CatBoost к нейросетям в рекомендациях Авито Рекомендации на главной дают…
  5. Oct 7, 2026🌍 Google Earth AI помогает прогнозировать вспышки заболеваний по данным о местности Модел…
  6. Oct 6, 2026🧮 Математика для ИИ на русском: от школьной базы до трансформеров и диффузии Бесплатный к…
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →