TGViewer
Channel Public Channel
AI Engineers

AI Engineers

@llmengineers

A highly technical blog tailored for AI engineers.

Chat: @AI_LLMs

Personal blog: mshojaei77.github.io/

Contact me: @realshojaeii
Subscribers
2.62K
Photos
164
Videos
17
Links
246

Showing posts older than #381 · Back to latest

Older Posts 20 shown
Post #380 1.62K
داشتم روی سیستم RAG که برای تحلیل ریپوهای گیت‌هاب کار می‌کردم و باز به همون بن‌بست قدیمی مدیریت Context Window خوردم... واقعیت اینه که OpenAI و Anthropic دو تا استراتژی کاملاً متضاد برای حل این مشکل دارن. OpenAI شبیه یه Oracle رفتار می‌کنه؛ یعنی سعی می‌کنه یه Thread طولانی و واحد رو با تکنیک Compaction زنده نگه داره. توی استفاده‌های شخصی‌م از مدل‌های جدیدشون دیدم که چقدر خوب می‌تونه جزئیات ریز رو توی تسک‌های طولانی یادش بمونه، چون کلاً سرور-ساید داره پیام‌ها رو فشرده می‌کنه بدون اینکه رشته کلام از دست بره. این یعنی انسجام یا Coherence بالا، حتی اگه پنجره محتوای فیزیکی‌ش کوچیک‌تر از رقیب باشه.

برعکس، رویکرد Anthropic بیشتر شبیه یه Firm یا سازمانه... توی ابزاری مثل Claude Code می‌بینیم که مدل به جای فشرده‌سازی، مدام Sub-agent می‌سازه. مثلاً برای گشتن توی فایل‌های پروژه من، چند تا ایجنت کوچیک‌تر ران می‌کنه و اونا فقط خلاصه رو به ایجنت اصلی برمی‌گردونن. این موازی‌سازی باعث می‌شه حس کنی سرعت یا Perceived Speed خیلی بالاست و انگار مدل داره "بیشتر" کار می‌کنه، اما یه ریسک بزرگ داره که بهش می‌گن Forgetfulness. اگه اون ایجنت کوچیک یه فکت رو بی‌خیال بشه و گزارش نکنه، ایجنت اصلی اصلاً از وجودش باخبر نمی‌شه. بارها توی تست‌های خودم روی کدبیس‌های سنگین دیدم که مدل یهو یه تابع مهم رو نادیده می‌گیره، صرفاً چون توی مسیر انتقال داده بین ایجنت‌ها گم شده.

هزینه توکن هم توی مدل آنتروپیک به خاطر همین ساختار ایجنتی و دوباره‌کاری‌ها معمولاً بالاتره... اما تجربه کاربری هیجان‌انگیزتری داره. OpenAI اما فعلاً روی پایداری تمرکز کرده. توی پروژه‌هایی که انسجام منطقی و دقت روی جزئیات حرف اول رو می‌زنه، هنوز Oracle بودن جواب‌تره. در نهایت فکر می‌کنم جفتشون به یه نقطه تعادل برسن؛ یعنی ترکیبی از فشرده‌سازی هوشمند و ایجنت‌های متخصص. چیزی که ما هم موقع Prompt Engineering و طراحی سیستم‌های Agentic باید بهش دقت کنیم: انتخاب بین سرعتِ موازی یا دقتِ متمرکز.

source: https://calv.info/the-oracle-and-the-firm

🛠 Join @LLMEngineers Community
  • ❤ 15
  • 👍 7
  • 👌 1
Post #379 1.13K
چند روزه دارم درباره پیاده‌سازی یه ریسرچر آکادمیک با LangGraph تحقیق میکنم...
داستان از اونجایی شروع شد که دیدم LLMها موقع مقاله نوشتن مدام رفرنس فیک تولید می‌کنن و توی متودولوژی فاجعه می‌سازن. قبلاً واسه کارهای دیگه ابزارهای اتصال API نوشته بودم ولی واسه ریسرچ قضیه جدی‌تره و نباید همه چیز رو بسپاریم دست مدل. ایده اینه که ساختار رو مثل یه سیستم‌عامل بچینیم؛ تسک‌های نگارش با مدل باشه ولی گیت‌های ارزیابی کاملاً deterministic کار کنن.

توی معماری این سیستم، یه گراف تک‌استیت داریم که کلی گیت کنترلی روش سواره. جریان رو طوری چیدم که از پروپوزال اولیه شروع می‌کنه، بعد می‌ره سراغ سرچ و تک‌تک استنادها رو با Crossref و Semantic Scholar تطبیق می‌ده. واسه اعتبارسنجی نوآوری هم کلاً به نظرِ خود مدل اتکا نمی‌کنیم؛ سرچ adversarial روی کارهای قبلی می‌زنیم و اگه امتیاز نوآوری پایین باشه، گراف متوقف می‌شه تا research question بازنگری بشه... دقیقاً شبیه کاری که توی معماری‌های ابزارمحور با MCP واسه سرچ عمیق استفاده می‌کنیم.

خلاصه اینکه ایجنت‌ها واسه کارهای روتین، فرمت‌دهی، چک کردن کامل بودن دکلریشن‌ها و پکیج کردن سابمیشن خوبن، ولی تایید نهایی منطق و مسئولیت علمی با ریسرچره. تمام دغدغه‌های فنی پیاده‌سازی و جزئیات کد رو توی یه پست مدیوم نوشتم:

https://medium.com/@mshojaei77/how-to-build-an-academic-research-agent-with-langgraph-42274bc3cd02?sharedUserId=mshojaei77
  • ❤ 17
  • 👍 1
Post #377 1.2K
AI Engineers https://x.com/philhchen/status/2072793818945167475?s=46
خلاصه:
هوش مصنوعی هر کاری که بشه براش تابع هزینه (loss function) تعریف کرد، به زودی می‌گیره. دانشگاه و سیستم آموزشی هم دقیقاً همین ساختار رو دارن.
پس کارای واقعاً باحال، باارزش و پول‌ساز این دهه، دقیقاً همون کارهایی هستن که تو فرآیند آموزش مدل نمی‌شه بهشون نمره داد.

پس چیکار کنیم؟
برو سراغ منابع واقعاً کمیاب: زمان، رابطه‌های عمیق و کانکشن‌های قوی
یاد بگیر مسئله پیدا کنی، نه فقط مسئله‌های دیگران رو حل کنی
همیشه جاه‌طلبانه‌ترین نسخه‌ی ممکن از هر مشکلی رو انتخاب کن
تو عصری هستیم که هوش مصنوعی کارهای متوسط رو خیلی خوب انجام می‌ده. برنده‌ها اونایی هستن که طعم، تشخیص مسئله و جاه‌طلبی دارن.
  • 👍 10
  • ❤ 4
  • 👎 1
Post #375 1.64K
AI Engineers https://lnkd.in/p/eYMtGpDU
شهریار توی این اسلایدهای تعاملی، از همون پله اول یعنی Tokenization شروع کرده و تا مفاهیم پیچیده‌تر و Multimodal پیش رفته. برای منی که شب‌ تا صبح با کد و مدل درگیرم، دیدن این‌که چطور این مفاهیم انتزاعی به شکل بصری پیاده شدن، واقعاً لذت‌بخش و البته کاربردیه.

جدیدا دنیای LLMها پر شده از هایپ‌های الکی، اما این کار شهریار فاکتورهای آکادمیک رو با جذابیت‌های بصری قاطی کرده تا بفهمی واقعاً زیر پوسته این مدل‌ها چی می‌گذره.

https://insidellm.shahriarshm.com

🛠 Join @LLMEngineers Community
  • 👍 7
  • ❤ 1
Post #374 1.42K
Post #373
AI Engineers pinned «‏دوستان من دنبال موقعیت شغلی دورکاری، تمام وقت یا پاره وقت هستم ‏اگه شرکتتون AI Engineer نیاز داشت، خیلی ممنون میشم بهم اطلاع بدید. ‏رزومه من رو اینجا میتونید ببینید : mshojaei77.github.io/about.html⁩ ‏ ایدی تلگرام: @realshojaeii»
Post #372 1.49K
‏دوستان من دنبال موقعیت شغلی دورکاری، تمام وقت یا پاره وقت هستم
‏اگه شرکتتون AI Engineer نیاز داشت، خیلی ممنون میشم بهم اطلاع بدید.
‏رزومه من رو اینجا میتونید ببینید :


mshojaei77.github.io/about.html⁩
‏
ایدی تلگرام:
@realshojaeii
LLMs: From Foundation to Production Portfolio A comprehensive tutorial for mastering Large Language Models (LLMs) – from core mathematics and computing principles to production deployment, advanced applications, and emerging research trends.
  • ❤ 9
  • ⚡ 1
  • 👌 1
Post #371 1.33K
یه تست باحال انجام دادن که ببینن Frameworkهای هوش مصنوعی چقدر با "فهمِ" ماشین سازگارن. لنگ‌گراف با اختلاف اول شده... کلاً ۱ دقیقه و ۴۲ ثانیه طول کشیده تا ایجنت بفهمه چطوری باید نصبش کنه و یه Hello World سالم باهاش بالا بیاره. این نشون می‌ده که داکیومنت‌هاشون برای ایجنت‌ها عالی بهینه شده.

باید بگم که DX یا همون تجربه توسعه‌دهنده دیگه فقط واسه ما آدما نیست. وقتی فریمورکی مثل Mastra شش دقیقه وقت ایجنت رو می‌گیره و کلی Error می‌ده، یعنی ساختارش برای اتوماسیون هنوز پخته نیست. من تو پروژه‌های ایجنتیک، LangGraph رو به خاطر کنترل دقیق روی State و لوپ‌ها ترجیح می‌دم. این بنچمارک ثابت کرد چرا خروجی کدش معمولاً تمیزتر درمیاد؛ چون مدل موقع خوندن مستنداتش کمتر گیج می‌شه.

https://2027.dev/arena/ai-frameworks

🛠 Join @LLMEngineers Community
  • 👍 8
  • 🔥 3
  • 👌 1
Post #370 1.35K
  • 👌 2
Post #369 1.47K
AI Engineers مدل LongCat-2.0 منتشر شد
  • ❤ 3
  • 🎉 2
Post #368 1.39K
امروز مدل LongCat-2.0 منتشر شد (همون Owl Alpha معروف OpenRouter) یه غول 1.6T پارامتری MoE که فقط 48B فعال داره.
چیزی که برام جالب بود اینه که کل این پروژه روی ASICهای چینی (Huawei Ascend) جمع شده و خبری از NVIDIA نبوده. 35T توکن دیتا دیده و ادعا می‌کنن توی SWE-bench Pro حتی GPT-5.5 رو هم زده.

ساختارش بر پایه LongCat-Flash بنا شده ولی با یه سری خلاقیت جالب مثل N-gram Embedding که فضای Embedding رو بدون سنگین کردن Inference تا ۱۰۰ برابر بازتر می‌کنه.
واسه هندل کردن 1M Context اومدن LongCat Sparse Attention یا همون LSA رو دادن که یه جورایی تکامل‌یافته DeepSeek Sparse Attention محسوب می‌شه. سیستم Indexing رو سه لایه کردن (Streaming-aware، Cross-Layer و Hierarchical) تا کوئری زدن توی سکانس‌های میلیونی، کمر سخت‌افزار رو نشکنه.

من خودم تو پروژه‌های قبلی با مدل‌های Long Context زیاد ور رفتم، معمولاً Performance بعد یه مدتی افت می‌کنه ولی اینا میگن روی صدها میلیارد توکن دیتای یک میلیون توکنی تمرینش دادن، یعنی فقط RoPE Scaling خالی نیست...

نکته اصلی اینه که کلاً Agent-centric طراحی شده. تمرکزش روی Tool Calling و Coding هست. با Claude Code و Hermes قشنگ جفت‌وجور می‌شه. قیمت‌گذاری‌اش هم برای ۱ میلیون توکن خروجی ۱.۲ دلاره که فعلاً رقابتیه.
هنوز فایل Weights توی Hugging Face نیست و فقط Model Card رو گذاشتن...

اینجا Technical blog اش رو میتونید بخونید:
https://longcat.chat/blog/longcat-2.0/

🛠 Join @LLMEngineers Community
  • ❤ 4
  • ⚡ 2
  • 👍 1
Post #367 1.27K
یه سری گزارش و بنچمارک جدید درباره Chunking توی سیستم‌های RAG دیدم که خیلی از ابهام‌هام رو برطرف کرد... واقعیت اینه که هنوزم خیلیا دارن از Fixed-size Splitting استفاده می‌کنن که توی پروژه‌های جدی جواب نمی‌ده و باعث می‌شه Context توی پاراگراف‌ها تیکه پاره بشه و مدل گیج بزنه.

هنوز هم Recursive Character Splitting امن‌ترین نقطه شروع برای اکثر داکیومنت‌هاست. توی داکیومنت ها روی حدود ۴۰۰ تا ۵۰۰ توکن با ۱۰ تا ۲۰ درصد Overlap تاکید شده بود که معمولاً تعادل خوبی بین Precision و هزینه Embedding ایجاد می‌کنه. اما اگه دیتای تخصصی مثل متون حقوقی یا پزشکی داری، استراتژی‌های Semantic و Hierarchical قطعا خیلی بهترن.

با اینکه Semantic Chunking هزینه پردازشی بالاتری داره (چون برای هر جمله باید Embedding بگیری) ولی چون بر اساس شباهت معنایی و شکست‌های منطقی متن رو تقسیم می‌کنه، حدود ۹ درصد Recall رو بهتر می‌کنه. من خودم توی پروژه قبلی دیدم که وقتی از Parent-Document Retrieval استفاده کردیم (یعنی تیکه‌های کوچیک برای سرچ و تیکه‌های بزرگتر برای کانتکست LLM) دقت جواب‌ها به طرز عجیبی بالا رفت.

رویکردهای جدیدتر مثل Late Chunking هم دارن ترند می‌شن. ایده‌ش اینه که کل سند رو یک‌جا Embed کنی و بعد نمایش‌های میانی رو تیکه‌تیکه کنی تا ارتباط بین جملات حفظ بشه. نکته طلایی که خیلیا نادیده می‌گیرن Metadata Augmentation هست... اضافه کردن تیترها، خلاصه‌ها و تگ‌های منبع به هر Chunk، فیلتر کردن رو موقع بازیابی خیلی دقیق‌تر می‌کنه.

به نظرم به جای هایپ روی مدل‌های خفن‌تر، باید روی همین جزئیات وقت گذاشت.

🛠 Join @LLMEngineers Community
  • 👍 11
  • ❤ 1
Post #366 1.19K
اگه دنبال «استخراج دیتا» هستی، یعنی فقط می‌خوای خروجی نهایی مدلت یه فرمت خاص داشته باشه (مثلاً لیست فاکتورها یا دسته‌بندی تیکت) مستقیم برو سراغ Structured Output. اینجا هدف اینه که مدل رو مجبور کنی دقیقاً طبق Schema تو حرف بزنه. ضریب خطاش هم خیلی کمتره چون توی سطح توکن محدود می‌شه و خروجی ۱۰۰ درصد معتبر می‌ده.

اما اگه قراره مدل «تصمیم بگیره» که کاری انجام بده، مثلاً بره فلان API رو چک کنه یا توی دیتابیس بگرده، اونجاست که Function Calling میاد وسط. اینجا JSON فقط یه واسطه‌ست برای اینکه پارامترهای اون Action رو بهت بده تا تو اجراشون کنی و دوباره نتیجه رو برگردونی به مدل... یعنی یه جریان دوطرفه و Agentic.

🛠 Join @LLMEngineers Community
  • ❤ 1
Post #365 1.16K
امروز داشتم یه سری داکیومنت و پست درباره AI Agents و تعاملشون با دیتابیس رو بالا و پایین می‌کردم... واقعیت اینه که خروجی مستقیم LLM به SQL یا همون NL2SQL توی محیط Production هنوز خیلی ریسکی و ترسناکه. ت
استفاده از استراتژی Hybrid. یعنی از LLM فقط برای Labeling و استخراج Intent استفاده کنیم (مثلاً وقتی کاربر می‌گه «فروش دو هفته آخر مرداد»، مدل فقط بیاد این رو به پارامترهای زمانی مشخص تبدیل کنه) و بعدش با Logic کد خودمون، Query نهایی رو بسازیم.

تجربه شخصی منم توی پروژه‌های قبلی همینه... سپردن کل پروسه Join زدن و Query نوشتن به Agent، مخصوصاً روی دیتابیس‌های شلوغ و پیچیده، تهش به Hallucination و کندی ختم می‌شه. توی Reddit هم بحث‌های زیادی بود که Agentها بدون Guardrailهای درست، ممکنه حتی دستورات مخرب بزنن یا دیتای کاملاً اشتباه تحویل بدن که فاجعه‌ست.

برای پیاده‌سازی، فریم‌ورک‌هایی مثل LangChain و LlamaIndex ابزارهای خوبی مثل SQLDatabaseToolkit دارن، ولی به نظرم برای کارهای جدی‌تر باید سراغ LangGraph رفت تا کنترل بیشتری روی Loopهای تصحیح خطا داشته باشیم. حتماً قبل اجرا باید از پکیج‌هایی مثل sqlglot برای Validate کردن استفاده بشه تا مطمئن شیم فقط SELECT انجام می‌شه و ساختار کوئری سالمه.

امنیت اینجا حرف اول رو می‌زنه. همیشه باید از Read-only User استفاده کرد و Row-level security رو جدی گرفت (اعمال LIMIT اجباری و Timeout هم برای جلوگیری از Runaway Queries واجبه) وگرنه Agent با یه Query سنگین ممکنه کل زیرساخت رو بخوابونه.

بیشترین ارزش افزوده این Agentها فعلاً برای دموها و Internal Tools هست که آدم‌های غیرفنی بتونن راحت‌تر با دیتا کار کنن... ولی برای سیستم‌های حساس، حتماً باید خروجی رو قبل اجرا به کاربر نشون داد تا تایید نهایی رو بگیره.

🛠 Join @LLMEngineers Community
  • 👍 11
  • ❤ 2
Post #364 1.27K
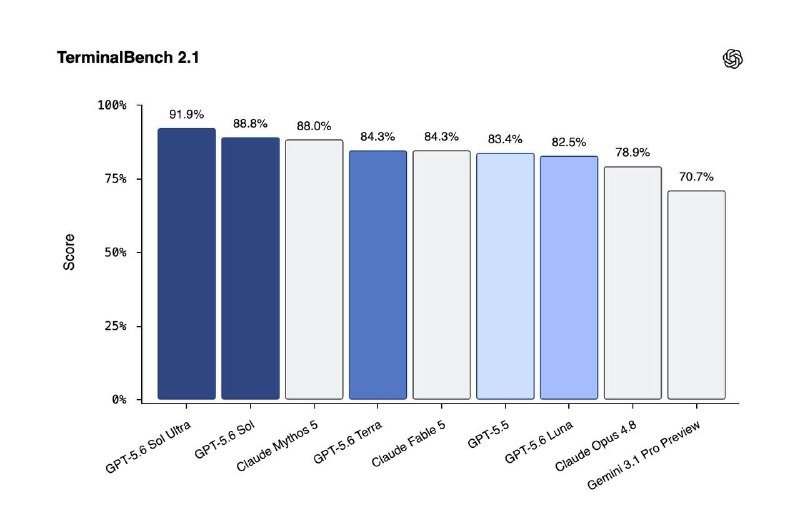
AI Engineers امروز OpenAI رسماً پیش‌نمایش محدود سری GPT-5.6 رو منتشر کرد. این بار به جای یک مدل واحد، سه مدل تخصصی معرفی کردن که هر کدوم برای نوع خاصی از کارها بهینه شدن. به نظرم این رویکرد خیلی هوشمندانه و حرفه‌ایه. مدل‌های جدید: GPT-5.6 Sol پرچم‌دار واقعی و مدل frontier…
  • 👍 1
Post #363 1.35K
AI Engineers GPT-5.6 is here… (Limited Access)
امروز OpenAI رسماً پیش‌نمایش محدود سری GPT-5.6 رو منتشر کرد. این بار به جای یک مدل واحد، سه مدل تخصصی معرفی کردن که هر کدوم برای نوع خاصی از کارها بهینه شدن. به نظرم این رویکرد خیلی هوشمندانه و حرفه‌ایه.
مدل‌های جدید:
GPT-5.6 Sol

پرچم‌دار واقعی و مدل frontier نسل بعدی. برای کارهای پیچیده، بلندمدت و agentic طراحی شده. در بنچمارک‌های سخت مثل Terminal-Bench 2.1 (اتوماسیون خط فرمان، برنامه‌ریزی و ابزارها) امتیاز فوق‌العاده ۹۱.۹٪ (حالت Ultra) گرفته. تو حوزه امنیت سایبری و ExploitBench هم عالی عمل کرده و با توکن خیلی کمتر از مدل‌های قبلی، نتایج رقابتی به دست آورده. مخصوص پروژه‌های تحقیق آسیب‌پذیری، کارهای تحقیقاتی طولانی و workflowهای پیچیده.
GPT-5.6 Terra
مدل متعادل و همه‌کاره. عملکرد نزدیک به GPT-5.5 رو با هزینه تقریباً نصف ارائه می‌ده. برای کارهای روزمره حرفه‌ای، تحلیل، تحقیق و استفاده‌های عمومی عالیه.
GPT-5.6 Luna
سریع، سبک و اقتصادی. مناسب پروژه‌های حجیم، چت‌بات‌ها، اتوماسیون و جاهایی که سرعت و قیمت مهمه.

جزئیات بنچمارک و کارایی:
سول در کارهای agentic و long-horizon واقعاً می‌درخشه. تو GeneBench (زیست‌شناسی و ژنومیکس) هم دقت
بالاتری با مصرف توکن کمتر نشون داده.

قیمت‌گذاری هم به این صورته (به ازای هر میلیون توکن):
Sol:
۵ دلار ورودی / ۳۰ دلار خروجی
Terra:
۲.۵ دلار ورودی / ۱۵ دلار خروجی
Luna:
۱ دلار ورودی / ۶ دلار خروجی

علاوه بر این، prompt caching بهینه‌تری هم اضافه کردن و حتی روی سخت‌افزار Cerebras (تا ۷۵۰ توکن در ثانیه) در دسترس خواهد بود.

تمرکز روی ایمنی:
مث همیشه
OpenAI روی ایمنی خیلی تأکید کرده. طبقه‌بندهای misuse realtime و red-teaming گسترده و محدودیت اولیه برای شرکای مورد اعتماد (به درخواست دولت آمریکا).
دسترسی عمومی گسترده‌تر احتمالاً طی هفته‌های آینده باز می‌شه.
  • 👍 2
  • 💯 2
Post #362 947
GPT-5.6 is here… (Limited Access)
  • ❤ 4
  • 🔥 2
Post #361 1.5K
یه مقاله ترسناک امروز خوندم پشمام ریخت، به تیم اومدن ۱۱۱ میلیون رفرنس رو توی ۲.۵ میلیون مقاله بررسی کردن و دیدن از ۲۰۲۳ به این ور، آمار Citation‌های فیک عجیب رفته بالا... فقط واسه سال ۲۰۲۵ تخمین میزنن ۱۴۶ هزار تا رفرنس غیرواقعی تولید شده.

نکته‌ش اینه که این یه مورد "چند تا آدم متقلب" نیست؛ Hallucination توی کل مقالات پخش شده. یعنی طرف مقاله رو نوشته، آخرش واسه رفرنس‌ها داده یه LLM براش لیست ردیف کرده، اونم از خودش اسم کتاب و مقاله درآورده. بیشترین نفوذ هم توی کامپیوتر و علوم اجتماعی بوده؛ جاهایی که AI-assisted writing بیشتر استفاده میشه. جالبه که نویسنده‌های تازه‌کار و تیم‌های کوچیک بیشتر از همه توی این تله افتادن.

من خودم وقتی داشتم یه Agent واسه Research خودکار می‌ساختم، دقیقاً به همین خوردم. مدل‌ها مخصوصاً مدل‌های کوچیک‌تر، وقتی تحت فشار قرار می‌گیرن یا ابزار جستجو دم دست‌شون نیست، شروع می‌کنن به ساختن رفرنس‌هایی که خیلی "منطقی" به نظر میان ولی اصلاً وجود ندارن. بدتر اینکه این رفرنس‌های فیک بیشتر به نفع آدم‌های معروف و مردهای پرکار تموم شده؛ یعنی AI داره Bias‌های قبلی رو توی سیستم اعتباردهی علم هم بازتولید می‌کنه.

فاجعه اصلی کجاست؟ اینکه سیستم‌های بازبینی و داوری مجلات اصلاً متوجه این موضوع نمیشن. یعنی این دیتای سمی داره وارد پایگاه داده‌های دائمی میشه. از اون طرف، ما داریم مدل‌های جدید رو روی همین مقالات Train می‌کنیم. این یعنی یه Feedback Loop سمی؛ یعنی مدل از روی توهمات مدل قبلی یاد می‌گیره.


لینک مقاله:
https://arxiv.org/abs/2605.07723

🛠 Join @LLMEngineers Community
arXiv.org LLM hallucinations in the wild: Large-scale evidence from... Large language models (LLMs) are known to generate plausible but false information across a wide range of contexts, yet the real-world magnitude and consequences of this hallucination problem...
  • 👍 15
  • ❤ 3
  • 👨‍💻 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →