TGViewer
Channel Public Channel
AI Engineers

AI Engineers

@llmengineers

A highly technical blog tailored for AI engineers.

Chat: @AI_LLMs

Personal blog: mshojaei77.github.io/

Contact me: @realshojaeii
Subscribers
2.62K
Photos
164
Videos
17
Links
246

Showing posts older than #361 · Back to latest

Older Posts 20 shown
Post #360 1.24K
AI Engineers امروز داشتم گزارش فنی جدید Baidu رو ورق می‌زدم که کلاً دیدم رو نسبت به هندل کردن داکیومنت‌های طولانی عوض کرد. اسمش رو گذاشتن Unlimited OCR و برخلاف مدل‌های فعلی که برای پردازش چند صفحه پشت‌سرهم لنگ می‌زنن، این یکی خیلی خوب عمل می‌کنه. مشکل چیه؟ مدل‌های خفن…
  • ❤ 1
Post #359 1.48K
امروز داشتم گزارش فنی جدید Baidu رو ورق می‌زدم که کلاً دیدم رو نسبت به هندل کردن داکیومنت‌های طولانی عوض کرد. اسمش رو گذاشتن Unlimited OCR و برخلاف مدل‌های فعلی که برای پردازش چند صفحه پشت‌سرهم لنگ می‌زنن، این یکی خیلی خوب عمل می‌کنه.

مشکل چیه؟ مدل‌های خفن مثل DeepSeek OCR از LLM برای دیکود کردن استفاده می‌کنن. هر چی متن طولانی‌تر بشه، KV Cache بزرگتر می‌شه، رم رو می‌بلعه و سرعت تولید توکن (TPS) میاد پایین. به خاطر همین همیشه مجبوریم داکیومنت رو صفحه به صفحه بدیم به مدل که باعث می‌شه زمینه (Context) از دست بره.

بایدو اومده یه حرکت هوشمندانه زده و Reference Sliding Window Attention یا همون R-SWA رو معرفی کرده. ایده‌اش اینه: هر توکنی که داره تولید می‌شه، به «تمام» توکن‌های تصویری (Reference Tokens) دسترسی داره ولی فقط به «یه پنجره محدود» (مثلاً ۱۲۸ تا) از توکن‌های متنی قبلی نگاه می‌کنه. دقیقاً مثل وقتی که داریم از روی یک کتاب مشق می‌نویسیم؛ کل صفحه جلو چشممونه ولی فقط چند کلمه آخری که نوشتیم رو تو ذهنمون نگه می‌داریم که یادمون نره کجاییم.

توی این معماری، برخلاف MHA معمولی که مصرف حافظه‌اش خطی بالا می‌ره، اینجا KV Cache کاملاً ثابته. یعنی چه صفحه اول باشی چه صفحه چهلم، سرعت و مصرف گرافیک فرقی نمی‌کنه. با همون Context Window معمول ۳۲ هزارتایی، تونستن ده‌ها صفحه رو توی یک Forward Pass پردازش کنن که برای پروژه‌های آرشیو و پردازش کتاب یه نعمته.

به نظر من جذاب‌ترین بخشش اینه که دقتش نه تنها کم نشده، بلکه توی بنچمارک OmniDocBench از خودِ DeepSeek هم جلو زده (حدود ۹۳ درصد). این نشون می‌ده که برای کارهای Parsing، لازم نیست مدل تمام تاریخچه متنی رو یادش باشه؛ فقط کافیه تصویر رو درست ببینه و ترتیب رو گم نکنه.

حتمالاً به زودی این تکنیک رو توی ASR و ترجمه هم می‌بینیم چون اونجا هم وابستگی به مرجع (Reference) ثابته ولی خروجی هی طولانی‌تر می‌شه.

🛠 Join @LLMEngineers Community
  • ❤ 15
  • 👍 6
Post #358 1.42K
امروز یه پست توی توییتر یکی از مهندسای Baseten خوندم درباره اینکه چطوری سریع‌ترین API رو برای GLM-5.2 ساختن. اعداد Baseten و تکنیک‌هایی که پیاده کردن واقعاً جای بررسی داره.

کوانتیزاسیون NVFP4 روی گرافیک‌های Blackwell کلید اصلی‌شون بوده. با NVIDIA ModelOpt اومدن مدل رو از FP8 آوردن روی ۴ بیت. نکته فنی‌ش این dual scale factor هاست که اجازه میده dynamic range حفظ بشه. من خودم همیشه توی پروژه‌ها نگران افت کیفیت مدل توی کارهای agentic بودم، اما تست‌های اینا روی بنچمارک BFCL نشون میده دقت تقریباً ثابت مونده... یعنی عملاً VRAM کمتر مصرف میشه و سرعت میره بالا بدون اینکه مدل خنگ بشه.

تفکیک فازهای Prefill و Decode یا همون PD Disaggregation بیشترین تاثیر رو توی TPS داشته. توزیع بار و نیازهای سخت‌افزاری بین این دو تا فاز کاملاً متفاوته؛ اولی compute-bound هست و دومی memory-bound. وقتی اینا رو روی انجین‌های جداگونه با کانفیگ‌های متفاوت اجرا کردن، ۲ برابر پرفورمنس بهتر گرفتن. به نظرم ما هم تو زیرساخت‌های سنگین باید به این سمت بریم، چون توی contextهای بالا، تداخل این دو تا فاز latency رو داغون می‌کنه.

سیستم KV-aware routing با استفاده از ابزارهای NVIDIA Dynamo هم برای کم کردن TTFT عالی عمل کرده. وقتی مدل ۱ میلیون توکن context window داره، کش کردن پرفیکس‌ها و فرستادن هوشمند درخواست به رپلیکایی که قبلاً اون دیتا رو پردازش کرده، واجبه. مخصوصاً برای agentهایی که هیستوری طولانی دارن و مدام دارن روی یه کانتکست مشترک کار می‌کنن.

استفاده از Multi-Token Prediction برای speculation هم تیر آخر بوده. تولید چند توکن در هر forward pass که با لایه‌های MTP خودِ GLM بهینه‌تر شده و نرخ تایید توکن‌های درفت رو بالا برده. به نظرم معماری GLM-5.2 و این ستاپ اینفرنس نشون میده که دیگه دوران استک‌های ساده اینفرنس تموم شده. اگه می‌خوایم توی اسکیل بالا و هزینه پایین کار کنیم، باید سراغ disaggregated inference و کوانتیزاسیون‌های نیتیوِ Blackwell بریم.

🛠 Join @LLMEngineers Community
  • ❤ 10
Post #356 1.31K
  • 👍 9
  • 👎 2
  • ❤ 1
Post #355 1.56K
رقابت توی مدل‌های امبدینگ زیر ۳۰۰ میلیون پارامتر خیلی جذاب شده. با اینکه گوگل با EmbeddingGemma-300m سر و صدای زیادی کرد، ولی جینا با مدل V5 Nano نشون داد که توی Production برنده کیه.

چند تا دلیل فنی که چرا جینا برای کارهای عملیاتی و RAG بهتره:

کانتکست ۸ هزارتایی در مقابل ۲ هزارتای گوگل، دست آدم رو برای پردازش داکیومنت‌های طولانی و … می‌ذاره.

استفاده از LoRA adapterهای اختصاصی برای تسک‌های مختلف مثل retrieval یا classification باعث میشه دقت خروجی توی سناریوهای واقعی خیلی بالاتر از یه مدل عمومی باشه.

قابلیت Binary Quantization جینا هم حجم ایندکس‌های دیتابیس رو به شدت میاره پایین بدون اینکه افت کیفیت محسوسی داشته باشیم. برای کسی که دنبال پرفورمنس بالا با هزینه inference و نگهداری کمه، این مدل جینا فعلاً بهترین گزینه‌ست.

https://huggingface.co/jinaai/jina-embeddings-v5-text-nano
  • 👍 8
  • ❤ 4
Post #353 3.25K
AI_Engineering_Building_Applications_with_Foundation_Models_Chip.pdf31.9 MB
کتاب AI Engineering چیپ هوین رو نباید به چشم یه آموزش برنامه‌نویسی دید؛ این کتاب بیشتر شبیه یه نقشه راه برای فرار از دوران" دمو" ساختن هاست. اگه پروژه‌هاتون توی MVP خوب کار می‌کنن ولی توی Production وا می‌رن، مشکلتون احتمالاً کد نیست، بلکه System Design هست.

بیشترین نقدی که به کتاب می‌شه اینه که کد کمه و تئوری زیاده، ولی به نظرم این بزرگ‌ترین نقطه‌ قوت کتابه. کدها و فریم‌ورک‌ها چند ماهه دِمُدِه می‌شن، اما چیزی که کتاب روش دست گذاشته یعنی طراحی Eval، مدیریت Latency و بالانس بین RAG و Fine-tuning، همون نقطه قوته که یه AI Engineer واقعی رو از بقیه جدا می‌کنه. در واقع کتاب به جای ماهی دادن، داره ماهیگبری یاد می‌ده : چطور یه سیستم بسازیم که وقتی مدل عوض شد یا فریم‌ورک جدید اومد، کل معماری‌مون نپاشه.
  • ❤ 18
  • 👍 1
Post #352 1.44K
واقعیت اینه که توی دنیای Agentها، مدل فقط حکم موتور رو داره؛ اون چیزی که واقعاً محصول نهایی رو می‌سازه Harness یا همون اسکلت‌بندی دور مدله. مثلا Claude 4.5 روی یه بنچمارک با یه Harness مشخص ۴۲٪ می‌گیره و با یه معماری دیگه به ۷۸٪ می‌رسه، بدون اینکه خود مدل ذره‌ای تغییری کرده باشه.

بزرگترین اشتباه اینه که فکر کنیم هرچی ابزار و Context بیشتری به مدل بدیم باهوش‌تر عمل می‌کنه. برعکس، تجربه‌ی تیم‌های موفقی مثل Cursor و Anthropic نشون می‌ده که الگوهایی مثل Progressive Disclosure (نمایش تدریجی اطلاعات) چقدر حیاتی‌ان. یعنی به جای خفه کردن مدل با حجم عظیمی از دیتا، باید اطلاعات رو فقط وقتی که واقعاً لازم شد و به‌صورت لایه‌ای به خوردش داد تا دچار Attention fragmentation نشه.

توی سیستم‌هایی مثل Claude Code، تمرکز روی سادگی لوپ و استفاده از ابزارهای ساده (مثل Grep و Bash) به جای پکیج‌های سنگین و انتزاعی، هم هزینه‌ی Token رو پایین آورده و هم دقت رو بالا برده. مدل‌ها دارن به سمت "جایگزین‌پذیر" شدن می‌رن و فرق محصولی که واقعاً کار می‌کنه با یه دموی جذاب، توی همون مهندسی ظریفیه که دور مدل چیده شده.

Source: https://x.com/himanshutwtxs/article/2028116431876116660

🛠 Join @LLMEngineers Community
  • 👌 10
  • ❤ 3
  • 🔥 2
Post #351 1.53K
مدل Gemma 4 26B-A4B برای تسک‌های فارسی پتانسیل خیلی بالایی داره.
صرفاً «پشتیبانی از زبان‌های مختلف» دیگه برای محصول واقعی کافی نیست؛ ما مدلی می‌خوایم که کثیفیِ دیتای فارسی، نیم‌فاصله و تفاوت ظریف لحن رسمی و محاوره رو بفهمه.
معماری MoE این مدل (۲۶ میلیارد پارامتر کل در مقابل ۴ میلیارد فعال) همون نقطه تعادلیه که همیشه دنبالش بودیم: کیفیت مدل‌های بزرگ با latency و هزینه اینفرنس مدل‌های کوچک.

می‌شه با یه SFT درست و حسابی روی دیتای فارسی تمیز و رعایت ریزه‌کاری‌ها، یه سیستم RAG یا دستیار فارسی ساخت که واقعاً محیط بیزینس یا آکادمیک ما رو درک کنه.
فرصت اصلی اینجاست که به جای منتظر موندن برای مدل‌های جهانی، لایه فارسی رو خودمون روی این بیس‌های قوی و Open-weight بسازیم تا خروجی نهایی حس هوش مصنوعی مترجم رو به کاربر نده.

https://huggingface.co/google/gemma-4-26B-A4B

🛠 Join @LLMEngineers Community
huggingface.co google/gemma-4-26B-A4B · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science.
  • 👍 9
  • ❤ 1
Post #350 1.65K
مدل‌های لوکال تا همین چند ماه پیش بیشتر شبیه اسباب‌بازی یا نهایتا یه سرچ‌انجین شخصی بودن، اما الان واقعا میشه برای تسک‌های agentic بهشون اعتماد کرد.
اجرای لوپ‌های کدنویسی با مدلی مثل Gemma 4 روی سخت‌افزار شخصی، الان خیلی به پرفورمنس مدل‌های frontier نزدیک شده، که دستاورد بزرگیه.
خوبی اصلیش هم اینجاست که برخلاف کار با APIها، کنترل کامل داری و می‌تونی ریز به ریز پروسه inference و پردازش توکن‌ها روی GPU رو مانیتور کنی و با quantization های مختلف تست بگیری.
تجربه جالب یه کاربر از این ستاپ با LM Studio و داکر رو اینجا بخونید:
https://vickiboykis.com/2026/06/15/running-local-models-is-good-now/

🛠 Join @LLMEngineers Community
Vickiboykis Running local models is good now Local agentic coding has gotten great over the past few months
  • 👍 6
  • ❤ 4
Post #349 1.58K
مدل VibeThinker-3B با ادعای شکست دادن غول‌هایی مثل Gemini 3 Pro و DeepSeek توی ریاضی و کدنویسی، دوباره بحث "فشرده‌سازی استدلال" رو داغ کرده. حرف اصلیشون اینه که برای Reasoning برخلافِ دانش عمومی (Knowledge)، لزوماً به صدها میلیارد پارامتر نیاز نداریم و میشه منطق رو توی یه هسته ۳ میلیاردی جا داد.

توی پایپ‌لاین post-training از یه استراتژی به اسم Spectrum-to-Signal استفاده کردن که با RL سنگین و SFT مرحله‌بندی شده، مدل رو روی تسک‌های Verifiable (اونایی که جواب قطعی دارن) متمرکز می‌کنه. عددها روی AIME و LiveCodeBench خیره‌کننده‌ست، ولی طبق معمول نباید فریب بنچمارک رو خورد.

واقعیت اینه که این مدل‌ها معمولاً برای بنچمارک بهینه (Benchmax) میشن و توی سناریوهای واقعی یا دچار Overthinking میشن یا کلاً گیج می‌زنن. با این حال، اگه این فرضیه که استدلال یه قابلیت چگال و قابل فشرده‌سازیه واقعاً در عمل ثابت بشه، مسیر توسعه SLMها کلاً عوض میشه.

Source: https://arxiv.org/abs/2606.16140

🛠 Join @LLMEngineers Community
arXiv.org VibeThinker-3B: Exploring the Frontier of Verifiable Reasoning in... This technical report introduces VibeThinker-3B, a compact dense model with 3B parameters developed to investigate how far verifiable reasoning can be pushed within a strictly small-model regime....
  • 👍 11
  • ❤ 1
Post #348 1.41K
AI Engineers مدل GLM-5.2 با معماری MoE (توزیع تنک محاسبات) و کانتکست ۱ میلیون توکنی، منتشر شد. تحلیل داده‌های ارزیابی عملکرد این مدل: - بهبود در بنچمارک DeepSWE با جهش چشمگیر از ۱۸.۰ به ۴۶.۲. - ثبت امتیاز ۸۱.۰ در Terminal-Bench به عنوان قوی‌ترین مدل متن‌باز. - برتری در…
  • ❤ 2
  • 👍 2
Post #347 1.59K
سایت OpenRouter یه ابزار اضافه کرده به اسم Cost Simulator
این ابزار ۱۰۰ تا ریکوئست آخرت رو برمی‌داره و می‌ندازه روی مدل‌های دیگه مثل GPT-5.5 یا GLM 5.2 تا ببینی روی اون مدلا چقد هزینت میشد.

سیستمش بر اساس Median Endpoint Pricing کار می‌کنه؛ یعنی قیمت واقعی رو حساب می‌کنه نه اون قیمت‌های اسمی که شرکت‌ها توی داکیومنت‌هاشون می‌زنن. خروجی کار هم یه جدول مقایسه‌ای و فایل CSV هست که برای گزارش دادن به تیم محصول یا مدیریت عالیه. مثلاً توی دمو نشون می‌ده که سوییچ کردن از Claude Fable 5 به مدل‌های اقتصادی‌تر می‌تونه تا ۷۰ درصد هزینه‌هات رو کم کنه بدون اینکه لازم باشه حدس بزنی.


https://openrouter.ai/labs/simulate-price

🛠 Join @LLMEngineers Community
  • 👍 9
  • ❤ 4
Post #346 1.39K

Forwarded from Shojaei

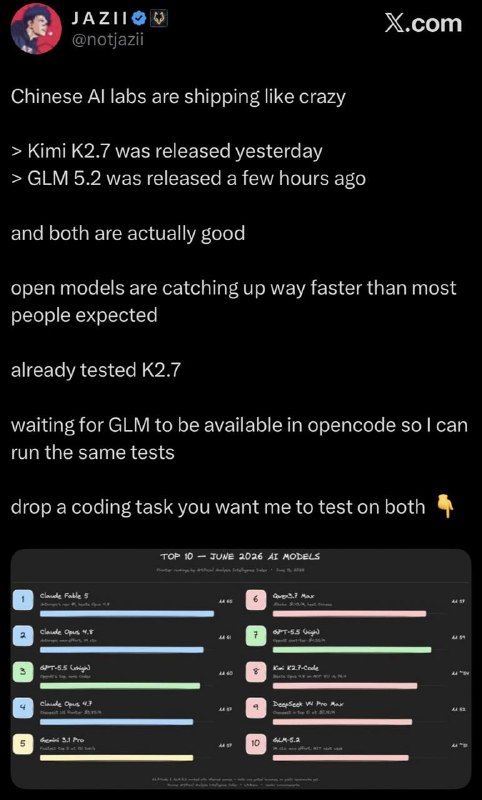
مدل GLM-5.2 با معماری MoE (توزیع تنک محاسبات) و کانتکست ۱ میلیون توکنی، منتشر شد.

تحلیل داده‌های ارزیابی عملکرد این مدل:
- بهبود در بنچمارک DeepSWE با جهش چشمگیر از ۱۸.۰ به ۴۶.۲.
- ثبت امتیاز ۸۱.۰ در Terminal-Bench به عنوان قوی‌ترین مدل متن‌باز.
- برتری در MCP-Atlas با امتیاز ۷۷.۰ و عبور از رقبای تجاری.
- امتیاز ۱۳۶۰ در بنچمارک DesignArena و کسب رتبه اول بالاتر از Claude Fable 5.
- رتبه دوم در بخش فرانت‌اند Code Arena با ثبت امتیاز ۱۵۹۵.
- جایگاه دهم در لیدربورد رقابتی کارهای عامل‌محور با بهبود عملکرد مثبت ۴.۴ درصدی.
- کسب رتبه دوم در بنچمارک PostTrainBench با ثبت دقت ۳۴.۲۹ درصدی.


Source: https://huggingface.co/zai-org/GLM-5.2

🛠 Join @LLMEngineers Community
  • ❤ 5
Post #345 1.77K
  • ❤ 3
  • 👍 2
Post #342 1.76K
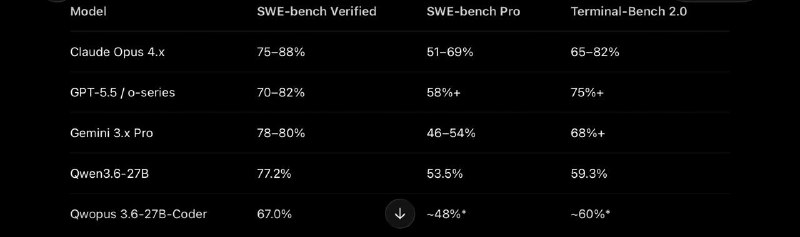
مدل Qwopus 3.6-27B-Coder هم یه مدل جالب برای کدنویسه، خودم هنوز تست نکردم ولی با 67% در SWE-bench Verified بنظر مدل خوبی میاد، روی gpu شخصی و به‌صورت لوکال میشه اجراش کرد (البته با gpu مناسب)
با استفاده از داده های لورفته claude opus برای agent workflow، tool use، debugging و روی ریپوزیتوری های گیت هاب فاین تیون شده.
قطعا به سطح مدل‌های frontier نمیرسه، اما از نظر “عملکرد نسبت به هزینه” و اجرای محلی گزینه خوبی برای کدنویسیه
  • 👍 7
Post #341 1.76K
AI Engineers دوستان نظرتون راجب پست ها چیه؟
دم همگی بابت مشارکت توی نظرسنجی
طبق آمار، ترجیح اکثریت (حدود ۶۰ درصد) روی پست‌های کوتاه‌تر همراه با سورس اصلی بود.

از طرفی، بعضی موضوعات و مقالات فنی انقدر عمیق و مهم هستن که اگر جزئیات رو ازشون حذف کنیم، عملاً ارزش آموزشی‌شون رو از دست می‌دن. برای همین، از این به بعد پست‌ها رو بسته به اهمیت و عمق محتوا به دو دسته تقسیم می‌کنیم:

۱. پست‌های کوتاه و عکس‌دار: برای ابزارها یا موضوعاتی که سریع جمع می‌شن؛ به همراه یک تصویر (مثل بنچمارک یا دیاگرام) و لینک مطالعه بیشتر برای کسانی که می‌خوان عمیق‌تر بشن.
۲. پست‌های عمیق و فنی: برای مقالات سنگین، تحلیل‌های معماری و موضوعات حیاتی که نیاز به موشکافی دارن (مشابه روال قبل).

این‌طوری هم وقت شما روی مطالب ساده‌تر تلف نمی‌شه، هم عمق فنی کانال روی مباحث اصلی حفظ می‌شه.

همچنین لازمه بگم، از همه دوستانی که لطف داشتن توی کامنت ها خیلی ممنونم،
درسته این کانال هیچگونه سودی برای من نداره و اینقلوئنسر هم نیستم اما همین که میدونم یکی این مطالبو میخونه دلگرمم میکنه 🙏🏻🤍
  • 🔥 24
  • ❤ 5
  • 👍 2
Post #340 1.48K
بعد از حدود ۹ ماه استفاده از مدل‌های Qwen 3 و Qwen 3.5 نسخه 4B روی سیستمم، بالاخره تصمیم گرفتم یه تکونی به ستاپ محلی بدم. الان چند وقتی هست که مدل Gemma 4 E4B نسخه 6-bit رو به عنوان مدل پیش‌فرض روی ویندوز با کارت گرافیک RTX 3060 (نسخه ۶ گیگابایتی) بالا آوردم (با LM Studio )

کوانت Q6 این مدل روی سخت‌افزارهای با VRAM محدود مثل gpu من واقعاً نرم و بی‌دردسر اجرا میشه. توی کارهای روتین، چت‌های معمولی و حتی فرستادن کدهای ساده بش (Bash) کار رو تمیز درمیاره. یکی از نکات جالبش لحن طبیعی‌تری هست که توی خروجی‌های متنی مناسب برای TTS تولید می‌کنه. برای کسایی که روی رزبری پای یا مینی‌پی‌سی هم بالا آوردنش بازخوردها مثبت بوده؛ یعنی مصرف منابعش نسبت به کیفیتی که میده واقعاً بهینه‌ست.

ضعف‌های مدل هم دقیقاً از جایی شروع میشه که یادت میره این کلاً یه مدل کوچیکه. توی ردیت خیلیا شاکی بودن که برای تسک‌های استدلالی سنگین یا خلاصه کردن متون طولانی خروجی متوسطی میده که خب طبیعیه. به نظر من بزرگ‌ترین ضعفش توی سیستم‌های ایجنتی و ابزارهای توسعه مثل Continue.dev یا کارهای نیازمند به Tool Calling عمیقه؛ کلاً ساختار خروجی رو اون‌قدر پایدار نگه نمی‌داره که بشه توی کارهای حساس بهش تکیه کرد. برای پروژه‌های لوکال ایجنتی Qwen 27b انتخاب منطقی‌تریه (که البته gpu بهتریم میخواد).

🛠 Join @LLMEngineers Community
  • 👍 10
Post #338 1.37K
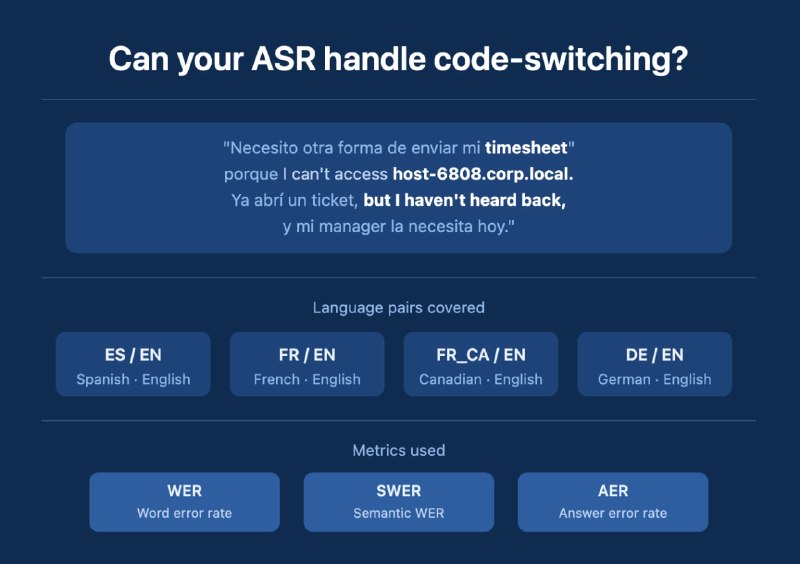
پدیده Code-Switching (تغییر ناگهانی زبان) پاشنه آشیل سیستم‌های ASR است، اما بنچمارک اخیر ServiceNow نشان می‌دهد مدل‌های Frontier به ثبات خوبی رسیده‌اند. تحلیل اعداد و خروجی‌ها نکات فنی زیر را برجسته می‌کند:

* مدل ElevenLabs Scribe V2 در اکثر جفت‌زبان‌ها کمترین WER (نرخ خطای کلمات) را ثبت کرده و صدرنشین است.
* گوگل Gemini 3 Flash به عنوان یک LALM (مدل زبانی-صوتی بزرگ) در شاخص AER (خطا در پاسخ‌دهی) به دلیل درک کانتکست، عملکردی خیره‌کننده دارد.
* مدل Whisper Large V3 Turbo بدترین نتیجه را گرفت، زیرا به جای Transcription، به اشتباه عمل Translation (ترجمه به انگلیسی) انجام می‌دهد.

Source: https://huggingface.co/blog/ServiceNow-AI/code-switching

🛠 Join @LLMEngineers Community
  • 👍 5
Post #337
AI Engineers pinned «دوستان نظرتون راجب پست ها چیه؟»
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →