TGViewer
Channel Public Channel
law.exe

law.exe

@law_exe

Subscribers
202
Photos
15
Videos
0
Links
17
Recent Posts 16 shown
Post #46 99
Развеем тишину в канале. Пишу редко, буду стараться чаще.
13 сентября закончилась летняя акция Anthropic, временно раздувавшая токенные лимиты в Claude Code. Честно скажу - мне и тех лимитов не хватало, но спасибо за летние каникулы. Сегодня стало известно, что недельные лимиты поднимут на 25% (ну хоть что-то).
Так что с сегодняшнего дня затягиваем пояса потуже и учимся выжимать воду из Дарио камня. Начнем с теории:

Кто там в нашем зоопарке
⬖ Fable 5.1 - упрощенная версия модели Mythos, которую широкой публике не показывают. Упор на написание кода и кибербезопасность. Парадокс: формально это модель «для айтишников», но по ощущениям - самая приятная модель Anthropic. Не склонна упорствовать. Модели поглупее обычно грешат обороной своей точки зрения по принципу «я сделаль», а эта - дипломатичная и податливая к эксплуатации. Ну и самая дорогая, естественно. У нее отдельный лимит внутри недельного, то есть наговориться с ней вам дадут меньше всего.
⬖ Opus 5 - следующая по интеллекту и моя основная рабочая лошадка.
⬖ Sonnet 5 - модель крайне тупая. Постоянно переспрашивает, делает сверх нужного и додумывает там где не просили.
⬖ Haiku 4.5 - самый младшенький, Иван-дурак семейства. Уровней размышления у него нет вообще.

Что такое effort
Effort - это усилие, то есть сколько токенов модель тратит на размышление перед тем, как открыть рот.
Ступеней пять: low, medium, high, xhigh, max.
Сразу предупреждаю: max - режим крайне затратный. А если врубить его на Fable, то неиллюзорен шанс выжечь пятичасовой лимит за несколько минут и при этом не решить задачу. Отдельной строкой стоит ultracode - это уже не уровень размышления, а режим, в котором Claude Code выкатывает на задачу целую бригаду агентов. Жрет бригада соответственно. Кстати небольшой юмор - если в тексте промпта будет слово ultracode, то обвязка автоматически включит использование той самой бригады (мультиагентный режим из ultracode), поэтому фильтруем базар.
И еще одна кнопка - fast mode (включается командой /fast, доступен на Opus 5 и 4.8). Это тот же Opus, просто перенастроенный на скорость - до 2,5 раз быстрее при том же качестве. Нюанс тут не в токенах, а в деньгах. На подписке fast mode в лимиты не входит вообще: он списывается с usage credits, то есть с карты, даже если недельный лимит у вас еще не выбран. Пока кредиты не подключены, /fast просто откажется включаться.


Мои настройки
⬖ Fable 5.1 - high. По множеству наблюдений это оптимум по соотношению качества и токенов, выше - расточительство. Модель умная, большинство вопросов закрывает сама. Скажу больше: я очень часто гоняю ее на medium, мне этого хватает.
⬖ Opus 5 - high и xhigh. На medium он резко тупеет относительно high: включает режим вахтера и начинает принимать глупые решения за вас. Поэтому на medium я доверяю ему только редактуру текста. Под архитектурное проектирование иногда ставлю xhigh, но честно скажу - вместо Opus на xhigh чаще выгоднее взять Fable на medium.
⬖ Sonnet 5 - только high. Для этой модели у меня фактически одна настройка: ниже high она становится совсем тупой, а если нужно выше - стоит призадуматься над Opus. Задачи ей достаются соответствующие: резюмирование и редактура текстов, глубокие исследования, составление списков, проверка документации и сверка с ней кода. На большее годится мало.
⬖ Haiku 4.5 - не использую вовсе. Наверное, с какими-то задачами она справится, но жечь ради этого подписку Anthropic я не стану.

Очередной нюанс
Opus 5 болтлив, и не лечится (промптом). Поэтому иногда - а также при сработавших фильтрах безопасности - я отползаю на Opus 4.6 и 4.8, которые подобным страдают меньше.

#LLM
  • 👍 7
  • 🔥 6
Post #45 228
Я очень часто использую глубокие исследования. Почти каждый день. Это когда вместо тебя гуглит робот, который сайт за сайтом собирает досье по теме - от профессиональных вопросов до выбора пылесоса. По пылесосу, кстати, у меня вышло пять исследований и отдельный проход синтеза информации. Пылесос - это серьезно!

Стал ловить себя на том, что после прочтения по диагонали все это добро летит в корзину. Сожженные токены оплачены, выбор сделан, цель достигнута, но осадочек, как говорится, остался.

LLM-wiki
Андрей Карпатый (один из отцов-основателей OpenAI, а теперь перебежчик в Anthropic) в апреле выкатил идею LLM-вики. План прост и поэтому красив - папка с markdown-файлами и три служебных файла: инструкция, индекс (содержание библиотеки) и журнал. LLM ведет всю бухгалтерию, человек только читает. Идея, справедливости ради, не его. До этого ровно то же самое называли Obsidian-зависимой памятью и вторым мозгом. Просто авторитета Карпатого хватило на шестнадцать миллионов просмотров.

Иди и сделай
Собственно, я бросил в искина десяток исследований и сказал: вот тебе идеи Карпатого, а дальше сам разбирайся, инструкцию себе тоже напиши сам. Чукча - читатель, чукча не писатель. Ответственным библиотекарем был назначен Claude Opus. На этом библиотечное дело закончилось и начался цирк. В бухгалтерии традиционно все перепутали: индекс заполнялся криво, ссылки были битые, а журнал выглядел как сводка боевых действий. Поглядев на это побоище со здравым смыслом, я включил золотое правило - если работу может сделать алгоритм, то работу должен делать алгоритм. Получилось дофига строк кода, которые превратили типичные действия в кнопки: заведение нового материала, заполнение содержания библиотеки, проверка ссылок. А еще я прикрутил поиск, словарь и дизайн-систему. Но основной смысл: накосячил - кнопка не нажмется.

Дисциплина
Но самое интересное вот в чем - инструкцию роботы писали для себя сами, и она пережила не десятки, а сотни правок (204, если точно). Собственно, любой косяк облекался в правило, которое Клод величаво называл дисциплиной. Но уже на паре десятков итераций все распухло до неприличных размеров: куча объяснений, почему это здесь и какая у этого была история, декларативные положения, разбор типовых ошибок и прочие нейрослопные прелести. В итоге простое правило жми на красную кнопку превращается в жми на красную кнопку, потому что она вызовет определенную функцию, но не перепутай ее с зеленой, обрати внимание, что рядом желтая, а чуть дальше - фиолетовая. Периодически я брал бритву Оккама и устраивал поножовщину, но вербальные сорняки прорастали обратно.

Собственно нюанс
Казалось бы, отпусти инструкцию в свободный самотек - работает же, пусть Клод пишет, как ему вздумается. Но привязываться я не хочу ни к Anthropic, ни к кому-либо еще, а вести библиотеку в итоге планирую с помощью локальных моделей. Такую простыню они не переварят - да и человек тоже.

Все вместе это напомнило эксперимент по синтетической эволюции: напихал пауков в банку и изучаешь результат. И оно работает. Но есть нюанс.

#project
  • 🔥 11
  • 👍 3
Post #44 220
llm-wiki.zip702.8 KB
Вдогонку сброшу результат - тут инструкции для Клода, скрипты на питоне и базовая структура библиотеки.

А потом отдельным постом расскажу как все это получилось - история не менее интересная.
  • 🔥 11
  • 👍 4
Post #40 125

Forwarded from ilovedocs | AI

Как можно создать личную библиотеку знаний

Новый тренд — собирать свою LLM-wiki. По сути, это личная база знаний, где материалы не просто свалены в папку, а разложены по понятной структуре.

Именно такую систему сделал для себя Степан Леонтьев @law_exe и поделился ею с участниками нашего чата.

Технически система устроена как папки с данными + набор инструментов вокруг них.

Есть несколько обычных папок:

• wiki/ — основная база знаний, где лежат готовые материалы и заметки
• raw/ — первоисточники (документы, из которых потом собираются материалы)
• media/ — картинки и иллюстрации
• inbox/ — новые входящие материалы, которые еще не разобраны
• trash/ — уже отработанные исходники после разбора

Чтобы не делать все руками, рядом работает набор небольших инструментов на Python (один из самых простых и популярных языков программирования для таких задач). Они помогают разбирать новые материалы, перемещать файлы, обновлять базу и в целом поддерживать порядок.

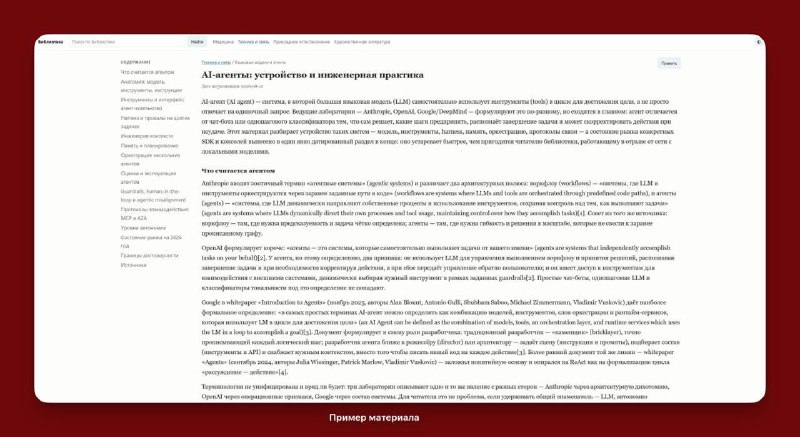
На скринах показали краткий механизм работы этой системы и добавили скрины от Степана — как всё это выглядит уже в готовом виде.


В итоге получается локальная библиотека знаний, которая лежит прямо на компьютере. Это один из ключевых принципов всей конструкции: данные хранятся у вас, а нейросети и другие инструменты уже работают поверх этой базы.

_______________________________
Сообщество юристов, которые покоряют нейросети
Канал | Курс
  • 🔥 7
  • 👍 1
Post #39 279
Все эти MMLU и HumanEval - детский сад по сравнению с реальной жизнью. Если мы хотим доказать существование искусственного интеллекта, нам нужен суровый отечественный ЖКХ-бенчмарк. Суть проста: скармливаешь квитанции за полгода и несколько фотографий счетчиков, сделанных на тапок где-то в темном коробе за унитазом, и просишь разобраться с правильностью начисления платежей. Никаким vision-тестам такой треш и не снился: тут вам и красное-черное, и неверный угол, да еще и некоторые цифры стыдливо застыли в промежуточном значении.

Дальше переходим к math-части, и тут тоже все жестко: бухгалтер ТСЖ производит начисления как Боги на душу положат, а некоторые позиции явно привязаны к фазам Луны. И как вишенка на торте - мистические строки «недопоставка» и «корректировка», которые искажают пространство и здравый смысл.

Я прогнал несколько моделек через это чистилище:
⬖ Fable 5 - фото распознал, математику посчитал верно, но сделал неверный итоговый вывод.
⬖ Opus 5 - фото распознал, но в расчетах намотал целый ком галлюцинаций, окончательно сдался и посоветовал ножками дойти до ТСЖ.
⬖ Sonnet 5 - фото интерпретировал неверно и предсказуемо посыпался в вычислениях дальше.
⬖ Gemini 3.1 Pro - фото распознал, но в расчетах поплыл и также посоветовал обратиться за разъяснениями к ТСЖ.
⬖ Gemini 3.6 Flash - фото распознал отлично, но ошибся в расчетах.

Итоговый счет: ЖКХ - ИИ 5:0, всухую. Теперь я думаю, что Skynet решит уничтожить человечество только потому, что не сможет понять, откуда взялись пени в 12 рублей при регулярной переплате.

#пятничное
  • 😁 17
  • 👍 4
Post #38 213
Обычно такое письмо счастья от Anthropic означает, что ваша работа пошла по борозде. Я тут провел postmortem своего кладбища забаненных аккаунтов Claude (а их уже с десяток!) и сделал некоторые выводы:

⬖ Средство платежа

Если вы пытаетесь накормить Claude неименными виртуальными картами или, хуже того, криптокартами, то бан прилетит быстро и стремительно. Именной пластик защитой также не является (хоть и снижает риск) - множество моих знакомых были отправлены в баню с картами Казахстана, Узбекистана и Киргизии. Я почти полгода использовал мутные подписки у перекупов - и хоть бы хны (до этого лета).

⬖ Google-аккаунты
Их качество имеет значение - обычно аккаунты без двухфакторной идентификации (2FA) отлетают в мир иной за несколько часов. С двухфакторкой выживаемость аккаунта резко возрастает, но опять же не дает полный иммунитет. И да - Claude перестал настойчиво требовать номер при регистрации с помощью Google, но начал шустро банить сомнительные аккаунты. Желательно зайти на Youtube и подписаться на пару каналов и лайкнуть несколько видео, а еще подписаться на какую-нибудь почтовую рассылку.

⬖ Высокая нагрузка на Claude
Обычно я не спрашиваю искинов, как сделать бомбу или свергнуть правительство США, но зато гоняю их и в хвост и в гриву. Например, для меня типично выжечь все недельные лимиты за 3 дня, но видать в этом случае за океаном начинает плакать кучерявый мужчина и помечает мой аккаунт как подозрительный. И дело не в задачах, по которым легко узнать, что я злобный русский - бывало я работал по месяц или несколько на одном аккаунте и только потом получал бан. Как вишенка на торте - на помывку спустя полгода после регистрации отправляются бесплатные аккаунты без какой-либо нагрузки вовсе.

Путешествуем по миру: А вот на что Claude точно плевать, так это на сетевую гигиену. Я сперва был КВН-резидентом США, а потом стал прыгать между Францией и Литвой, без каких-либо последствий со стороны Anthropic.

⬖ Выводы
Платите именными картами и расслабьтесь. В Anthropic за систему банов отвечает колода Таро. Или генератор случайных чисел. А может и то и другое.
  • 🔥 12
  • 👍 4
Post #37 251
Эпоха нейрослопа

Давненько не писал - меня тут Anthropic забанил (пять раз, об этом чуть позже), и я решил больше трогать траву и шашлык.

Журнал The Economist выкатил интересную статью о том, как ИИ трансформируют рынки контента. Оригинал скрыт за пейволом, но кому это мешало в наши дни. Фабула простая: ИИ сильно облегчил уровень входа практически везде, и Интернет предсказуемо захлебывается в нейромусоре (AI slop в оригинале). Небольшая статистика по пяти индустриям:
Суды. Начнем с родной юридической гавани. В США доля истцов-одиночек (без адвокатов) скакнула почти в два раза, а в самих исках отмечается большое количество выдуманных прецедентов (так называемые slopsuits).

Книжный рынок. Объем книжных релизов на Amazon вырос втрое - до 300 тысяч в месяц. Больше половины - тексты с явным следом генерации.

Наука и программирование. На портале научных статей arXiv доля статей с лексическими маркерами ИИ (использование специфических слов) взлетела с 12% до 57%. В App Store льют по 100 тысяч приложений в месяц, а треть отказов модерации приходится на неоптимизированный код (чую монетизацию вайб-кодинга).

Музыка. Тут самый смак. На стриминг Deezer ежедневно грузят 75 тысяч ИИ-треков (44% от всех новинок). В слепых тестах 97% людей не могут отличить их от музыки белковых авторов. При этом 70–85% прослушиваний синтетики приходится на бот-фермы - боты слушают ботов (здрасьте роялти и теория мертвого Интернета).

Выводы? Старые институты верификации - как бумажный зонтик под кислотным дождем. Они создавались для мира, где производство контента стоило человеческих усилий.

Я считаю, что спасение утопающих - дело рук криптографии. Рано или поздно мы придем к жесткой верификации авторства цифровыми подписями. А пока - готовьтесь разгребать тонны... ну вы поняли.
  • 🔥 6
  • 👍 2
  • 🤯 1
Post #36 330
Циферки против людей

Илья Семухин нашел очень интересное дело про детекцию сгенерированного текста. А дело-то родное - Верховный суд Республики Татарстан и Вахитовский районный суд Казани. Фабула простая: студентка пытается защитить диплом, работу прогоняют через "Антиплагиат.ВУЗ" - систему, которая вроде как умеет находить ИИ-контент. И тут начинается цирк.

Работу загружали трижды:
⬖ 7 июня - ИИ-контент 41,91%;
⬖ 8 июня - научрук заявляет, что более чем в 70% текста намеренно перемешаны слова, чтобы искусственно поднять оригинальность ценой смысла, называет это фальсификацией и отправляет работу на доработку;
⬖ 9 июня - ИИ-контент 11,92%, а оставшиеся 88,08% суд потом зафиксирует как показатель авторского текста и приравняет к требованию оригинальности не менее 50%.

Тут необходимо сделать оговорку, что неясно, изменялся ли текст между загрузками. Но в сухом остатке - отчисление. Добро пожаловать во взрослую жизнь.

Но девушка решила побороться в суде и победила. Основные выводы суда:
⬖ Человеческой верификации не было. Уже в заседании представитель ответчика признал: научный руководитель вообще не в курсе, как работает Антиплагиат, и компетенции проверять текст на ИИ у нее нет. Представитель также не смог объяснить принципы работы программы, пределы погрешностей и критерии достоверности - короче, ничего. Все просто посмотрели на выводы программы и решили: "И так сойдет!"
⬖ У Антиплагиата нет прозрачной методологии. Отчет системы - вероятностный по своей природе, и в нем самом стоит оговорка: окончательное решение за живым экспертом. А этот "эксперт" немножечко кнопкожим, да и не эксперт вовсе. Вишенка на торте: сравнили отчеты от 7 и 9 июня - одни и те же куски текста в одном помечены как "написал ИИ", а в другом - как "написал человек". И наоборот.

Итоги: вероятностная циферка, которую никто не понимает и не может перепроверить, не может быть единственным и бесспорным доказательством того, что студент жульничает.

Важный нюанс: судя по тексту, представитель вуза давил на то, что определенный процент сгенерированного текста сам по себе является проблемой. Правда, почему это проблема и как ее определять, не рассказал. От себя еще раз отмечу, что в отсутствие цифровых отпечатков в контенте способы определения ИИшницы больше напоминают гадание на кофейной гуще.

Грустная история (благо хоть с хорошим концом) о том, как непроверенные алгоритмы решают судьбу человека.
  • 🔥 11
  • 🤔 3
Post #34 319
Детекция ИИ контента

Искины генерят контент с огромной скоростью, а теория мертвого Интернете становится ближе. Мы с Евдокией по уши закопались в тему и написали препринт статьи «Маркировка ИИ-изображений».

База: автором по закону может быть только человек, роботы авторства не порождают. Российские суды пока в тему особо не вникают, а вот EU AI Act требует вшивать в сгенерированный контент машиночитаемую метку.
Есть прямой способ - C2PA, открытый «паспорт контента»: криптоподпись и история правок, прицепленные паровозиком к файлу. Но паспорт лежит в кармане у файла и теряется на раз - пересохранил или загрузил в соцсеть, и метаданных нет.

А ТЕПЕРЬ САМОЕ ВКУСНОЕ

Для EU AI Act хватило бы одного C2PA. Но Google идет дальше и зашивает в картинки SynthID - клеймо, выжженное в самих пикселях. Переживает сжатие, кадрирование и множество других финтов ушами. Зачем делать больше, чем велит регулятор? Накидали мыслей:
⬖ Удалил водяной знак Google - нарушил пользовательское соглашение, а оттуда и до отказа в доступе ко всем сервисам недалеко (вместе с твоими данными на их серверах).
⬖ SynthID позволяет Google безошибочно узнавать «свой» контент - отсюда один шаг до приоритетного показа своего и тихого задвигания чужого в выдаче.


Выводы невеселые: штука, придуманная ради прозрачности и защиты человека, прекрасно конвертируется в инфраструктуру контроля и монополии. PDF под постом, будем рады критике.

#longread
  • 🔥 13
  • 👍 5
Post #32 356
Пять часов - новый стандарт

Хотелось бы говорить о пятичасовом рабочем дне, но увы. Разговор будет о пятичасовом скользящем окне лимитов:
Claude - первая ласточка. Скользящее окно работает у него уже давно: привязка идёт не к конкретному времени, а к началу использования. Отправил первое сообщение - время пошло.
ChatGPT - подхватил эстафету. Раньше при слишком активном диалоге тебя на пару часов переключали на модельку попроще, но теперь пятичасовое окно зафиксировано в документации.
Gemini - присоединился к профсоюзу буквально на днях. Ввел новую политику с пятичасовыми и недельными лимитами.

Итого: 5 часов - это индустриальный стандарт, под которым подписались все большие дяди.

Перекрой привычек

Чтобы пост был не чисто новостным, расскажу, как новый хронометраж перетряхнул мой распорядок. Последние несколько лет работаю на удаленке, пару месяцев плотно живу в Claude.
⬖ Только продрав глаза, врубаю комп и кидаю банальное «Привет, какие новости». Цель - запустить скользящее окно ДО начала работы. Дальше иду на утренние процедуры, а таймер тикает.
⬖ Считаем: рабочий день 8 часов + обед = 9, а два полных цикла лимитов - это 10. Таким образом, обновление попадает плюс-минус на обед.
⬖ Первая половина дня всегда самая нагруженная, иду обедать - возвращаюсь к обновлённому Claude. Второго присеста обычно хватает, чтобы добить работу до вечера.
⬖ Вечером лимиты обновляются третий раз, и я переключаюсь на личные проекты. Итого три полных использования лимитов за сутки.

Юмор в том, что скользящее окно (а не я) теперь определяет ритм моего дня.
  • 🔥 8
  • 👍 1
Post #30 829
ИИ-революция? Работодатели не в курсе

Правильно говорил один известный философ о том, что безделье - игрушка дьявола. Поэтому я решил не впадать в шашлычный угар на выходных, а немного поковыряться в данных юридического рынка труда.

Источник - HH.ru, окно сбора данных - 29 апреля по 1 мая 2026, инструментарий - мои любимые LLM. Мини-отчет ниже, здесь только выжимка:
⬖ Проведен анализ 4 036 вакансий;
⬖ Из них юридическими оказалось 2 230 вакансий (в качеству поиска появляются вопросики);
⬖ ИИ упоминается в 79 — это 3,5%.

Там где ИИ упоминается полный винегрет: это может быть как требование к соискателю, как преимущество работодателя (у нас развернуты локалки, пыщ-пыщ), так и скупое упоминание в тексте через запятую с остальными терминами (IP, IT, AI).

Выводы: до ИИ трансформации юридической отрасли еще очень далеко.

Ответственно заявляю: я не настоящий сварщик исследователь, методы исследования вызывают вопросы, но я ответственно заверяю, что Headhunter не пострадал, а мое любопытство удовлетворено.
  • 🔥 9
  • 😁 3
Post #29 409
Не растягивайте диалоги с LLM

В этом посте поговорим про промпт-инжиниринг. В мае 2025 года Microsoft Research и Salesforce опубликовали статью «LLMs Get Lost in Multi-Turn Conversation» - времени прошло немало, протестированные LLM уже не в моде, однако выводы очень интересные. Собственно суть:

Исследователи взяли пучок LLM ( в т.ч. и топы вроде GPT-4.1, GPT o3, Claude 3.7 Sonnet, Gemini 2.5 Pro и Flash, DeepSeek-R1 и т.д.) и прогнали через них 200 000+ симулированных диалогов, с одним и тем же набором задач: код, SQL, математика, резюмирование. Но информация подавалась двумя разными способами: целиком в одном сообщении (single-turn) и по кускам в несколько заходов (собственно тот самый "multi-turn conversation" из названия исследования).

Результат: подход "всё сразу" показывает в среднем на 39% лучшую производительность чем "по частям", причем у всех: у моделей маленьких и больших, размышляющих и не очень.

Что происходит:
⬖ При уточнении задачи в последующих сообщениях, модель пытается "встроить" их в существующие ответы, создавая франкенштейна из прошлых предположений и новых правок.
⬖ Свернуть не туда достаточно один раз, дальше модель скатывается по скользкой дорожке (цитирую: when LLMs take a wrong turn, they get lost and do not recover).


Что точно не помогает (исходя из исследования):
⬖ Размышления (тут кстати любопытный момент - Gemini 2.5 Pro не была упомянута авторами как думающая, мама миа, считай нашел косяк в именитой статье) не помогают, а скорее затрудняют дело (больше мыслей - больше предположений и метаний).
⬖ Снижение температуры до нуля.
⬖ Промпт-прием вроде "повтори всё сказанное в последнем сообщении" дает прирост +15-20%, но до уровня single-turn не дотягивает.


Выводы:
Золотое правило "чем короче - тем лучше" заиграло новыми красками за пределами деградации контекста (неэффективная обработка информации в рамках контекстного окна - context rot).
Другое золотое правило "без ТЗ - результат ХЗ" было повторно апробировано.

Что делать:
Не знаете чего хотите - собираете контекст в одном чате, а потом начинаете новый чат с четкой задачей.

#prompting
  • 👍 7
  • 🔥 5
Post #28 451
[Тут должен быть заголовок, но законы России сделали это невозможным]

Есть один знаменитый университет, который в России знаменит настолько, что входит в перечень нежелательных организаций. Так вот этот университет давненько следит за развитием искусственного интеллекта с тех самых пор когда это еще не было мейнстримом и выпускает научные материалы на эту тематику. Но так как в нашей стране подобные материалы распространять нельзя, я лишь перескажу основные выводы:

Развитие ИИ и не думает замедлятся. Темпы развития не снижаются, а 2025 год побил предыдущие.

Знания ИИ неравномерны. Модели стали еще умнее, в науке приблизились к человеку, решают олимпиадные задачки, но путаются в детских загадках и слабы в логике. Это не ново, Ханс Моравек рассказывал об этом с в 80х. 2025 обозначился прорывом в кодинге, но мы вайбкодеры об этом и так знаем.

Беспрецедентная скорость распространения. ИИ за три года накрыл 53% населения Земли - быстрее, чем в свое время ПК и Интернет, но уровень использования прямо коррелируется с бедностью.
Полярные взгляды на технологию. AI-специалисты говорят о высоком влиянии технологии на мир (каждый кулик своё болото хвалит), но широкая публика считает иначе.

Сильнейшее влияние на образование. 80% американских старшеклассников и студентов используют нейросети для учебы, в то время как учителя не понимают, что с этим делать. Тут как всегда - молодежь быстро подхватывает технологии, пока мамонты пытаются адаптироваться.


#новости #цензура
  • 🔥 4
Post #24 401
Личная метеослужба

Вчерашнее воскресенье выдалось особенным - я красил яйца, смотрел на небо и думал: «Прости, Юра, Христос воскресе». А все выходные до этого пилил мини-проект в честь Дня космонавтики. Показываю четыре картинки - это не просто красивое, а живые данные, которые можно тянуть по API прямо сейчас.

⬖ № 1 - карта аллергенной пыльцы в Европе. Визуализация математической модели SILAM от Финского метеорологического института. Одна из самых точных в мире моделей прогнозирования распространения пыльцы берёзы и ольхи.

⬖ № 2 - песчаные бури над Ливией и Египтом - снимок спектрометра TROPOMI на спутнике Sentinel-5P, который ежедневно сканирует всю атмосферу Земли для контроля загрязнений воздуха.

⬖ № 3 - тепловые аномалии в Череповце - NASA FIRMS, спутниковой системы, предназначенной для поиска пожаров. Красные точки - это тепловые аномалии, синие - известные техногенные источники тепла. Тепловая карта металлургии региона.

⬖ № 4 - последствия таяния снега в Казани. Данные краудсорсинговой сети Sensor Community показывают резкий рост концентрации мелких частиц (PM2.5 и PM10) в марте, во время таяния снега. Зима покажет, кто где срал - вся грязь и реагенты, копившиеся в сугробах, попадают в атмосферу.


Так уж получилось, что в силу личных биологических причин я живо интересуюсь качеством воздуха. И вот собрал собственный портал по качеству воздуха с единой картой, куда интегрированы: прогноз пыльцы, спутниковые данные и наземные сенсоры. Это мой самый большой вайб-кодинговый проект: около 20к строк кода плюс база данных.

#vibecoding
  • 🔥 10
Older posts →

About this channel

How can I read @law_exe without a Telegram account?
TGViewer shows the public web preview Telegram publishes for law.exe: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does law.exe have?
law.exe (@law_exe) has 202 subscribers on Telegram, refreshed roughly every 30 minutes.
Does law.exe know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →