TGViewer
Channel Public Channel
Kotelok

Kotelok

@kotelok_longread

Паблик для анонсов длинных текстов
Subscribers
319
Photos
140
Videos
0
Links
95

Showing posts older than #159 · Back to latest

Older Posts 10 shown
Post #158 342
Как считал?
- Взял публичный датасет,
- выбрал только фильмы на английском языке,
- разбил официальное описание фильма на слова,
- убрал служебные слова (предлоги, артикли и т.д.)
- посчитал число фильмов, в которых включается
- вывел топ

Обращаю внимание на то, что равноправие почти победило, частота упоминания мужчин и женщин почти одинаковая, дружба встречается чаще любви, а юность - старости.
  • 👍 5
Post #153 433
Конкурс красоты (продолжение)
Итак, конкурс, кто построит более красивый график.

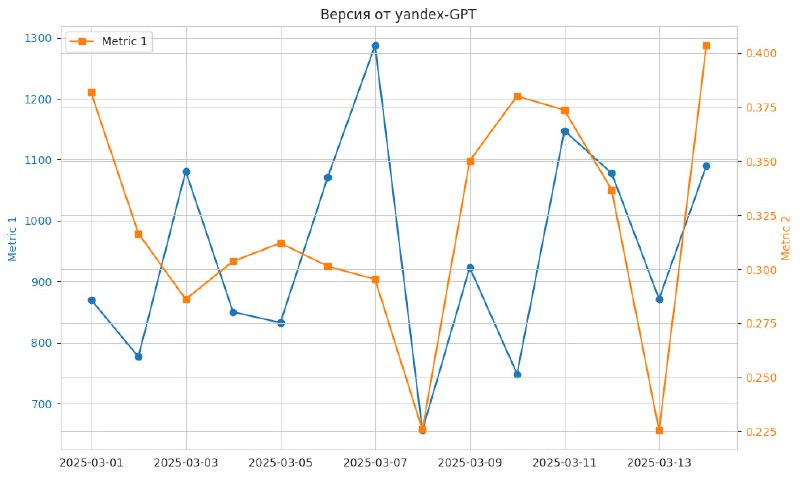
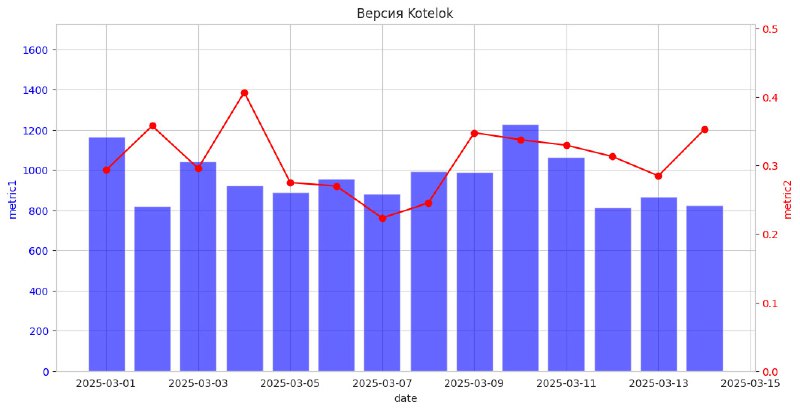
Конкурсанты: DeepSeek, YandexGPT, ChatGPT.
Моё решение тоже положу в качестве бенчмарка.

Запрос для них (для всех одинаковый символ в символ):
*Отлично. Теперь смотри, у меня есть pandas data frame df, в которой есть временной рад длинной 14 дней для двух метрик. Одна метрика metric1 имеет значение порядка 1000. Другая, metric2 имеет значение около 0,3. Приведи пример максимально красивой, честной и наглядной визуализации, с помощью которой на одном графике можно продемонстрировать текущую картину временного ряда*


Два разных ряда в одной визуализации строить не очень удобно, но тем ценнее помощью виртуального друга.

В коде LLM-ок менял только заголовок.

В данных не ищите закономерности - это генератор случайных чисел.

Как вам?
  • 👍 2
Post #152 291
Конкурс красоты
Кажется, в этом канале мы оскорбительно мало обсуждаем LLM (large language model). Они же нейросети, они же искусственный интеллект.

Эти машинки не только могут вам посоветовать подарок другу на день рождения, но и пишут код. С длинными проектами есть свои особенности, не будем сейчас на них останавливаться.

А вот короткие задачки, говорят, наши друзья делают "на ура". И есть мнение, что особенно хорошо они решают задачи визуализации данных. А мы же любим хорошие графики! Плохие - тоже любим, как повод посмеяться. И как опыт.

Давайте попросим 3 разные LLM построить график по чуть-чуть небанальный задаче и посмотрим, кто самый красивый?

Что думаете?
  • ❤‍🔥 5
Post #151 654
Бот для ЧГК
Когда-то давно я рассказывал об алгоритме, который помогает понять, какие именно вопросы в турнире по спортивному "Что? Где? Когда?" команда "уронила", а взятием каких, наоборот, может гордиться.

В опросе вы выразили желание побаловаться этим алгоритмом самостоятельно.
Наконец-то у меня дошли руки. Появился бот.

Сейчас он умеет немного. Вы можете ввести свою команду и турнир, который вас интересует. Если результаты уже появились на турнирном сайте, бот выведет вам номера вопросов, которые являются вашей "зоной роста" и номера вопросов, взятием которых вы можете гордиться.

Результаты асинхронов долго срыты, а в базу выкладывают вообще непонятно когда, так что быстро провести "разбор полётов" не выйдет. И лучше, если у вас в команде есть хотя бы один человек, который фиксирует текст вопросов, ответ команды и сможет, хотя бы, примерно их воспроизвести.

Надеюсь, вам будет полезно. Пожелания, чтобы вы хотели, чтобы бот делал ещё, принимаются в комментариях.
  • 🔥 17
Post #150 476
Собрал посты про предсказательную силу доппоказателей в один большой текст с набором графиков.

Читайте там, где вам удобно:
На Хабре
или
На моём сайте

На Хабре совсем не вредно поставить плюс, если у вас есть такая возможность.
  • 👍 3
  • 🔥 1
Post #149 450
Я всё время забываю давать ссылки на исходный код.
Вроде это просто, но как-то пропускаю.

В случае с дополнительными показателями в ЧГК это точно уместно.
Вот тут код, который позволит вам собрать данные с турнирного сайта. Для получения доступа к API никакой ключ не нужен, просто запускаешь и оно работает.

А вот тут код всего исследования. Если у вас есть возможность запустить где-то код на питоне, вы можете менять параметре в первой ячейке, перезапускать всю тетрадку и смотреть, как меняются результаты.

Попробуйте, это весело.
  • 🔥 2
Post #144 430
Интеллектуальный фотофиниш (продолжение)
Давайте посмотрим, что там у нас по разным сегментам.
Логика графиков будет та же. По вертикали будет точность, каждая метрика своим цветом. По горизонтали - те или иные сегменты.

Точность прогноза на синхронах ниже, чем на очниках и строгих синхронах. Это неожиданно.

На нерейтинговых турнирах точность тоже выше? У меня нет идей почему.

На больших турнирах точность повыше, чем на других. Это нормально, закон больших чисел. Интересно, почему предсказательная сила стартового рейтинга хуже на турнирах среднего размера?

Прогноз на простых пакетах (trueDL < 3.2) оказался точнее (а рейтинговые сюрпризы, наоборот, чаще).

По сезонам результат тоже устойчив, это хорошо.

А вот с удлинением дистанции точность растёт не так быстро, как хотелось бы. Обидно. Факторы усталости шумят?

Боксплоты по каждой метрике будут лежать в комментариях.

Что мы можем сказать в итоге?
Турниры разные, результаты на каждом конкретном могут быть непредсказуемыми, но на дистанции прогнозная сила нашего фотофиниша высокая и устойчивая.

Конечно, в ситуации конкретного турнира и двух команд, которые пришли к финишу с одинаковым результатом, может произойти что угодно. Доказать проигравшей команде, что какое-то число в табличке имеет вес, сложно. Но не это ли повод сыграть следующий турнир?
Post #143 300
Интеллектуальный фотофиниш (продолжение)
Давайте теперь посмотрим, как наши дополнительные показатели ведут себя на дистанции с 2022 года (3 полных сезона + текущий).

Это 1624 турнира. Не самый большой массив данных на нашей планете, но нам хватит.

Итак, как же наши прогнозы ведут себя в разбивке по сегменту стартовой крутости?

Закономерности остались прежние. Прогнозы "виртуальной перестрелки" по рейтингу взятых вопросов и сумме мест в турах
- значимо лучше случайной тасовки
- значимо лучше прогноза по стартовому рейтингу
- уступают по точности прогнозу "по числу взятых"
- показывают максимально волатильные результаты в сегменте 10% самых сильных команд

Между собой прогнозы очень похожи.
Для сегмента 10% лучших команд чуть лучше прогноз "по рейтингу взятых", для остальных - по сумме мест в турах.

Мы уже получили ответ на вопрос, который нас волновал.
Дополнительные показатели можно и нужно использовать для распределения медалей и выводящих мест тогда, когда перестрелка невозможна. Они точно лучше для предсказания результата "здесь и сейчас" не только бросания монетки, но и других известных нам способов.

Если нет иных аргументов, то для заявленных задач рейтинг сложности вопросов чуть-чуть лучше, чем сумма мест в турах.

Но, конечно, хочется, посмотреть эти данные в каких-то крупных разрезах. Я прав?
Post #137 303
Интеллектуальный фотофиниш (продолжение)
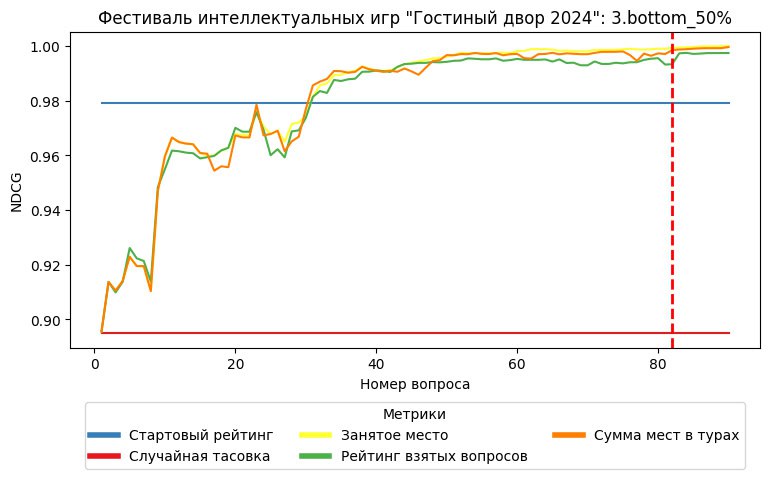
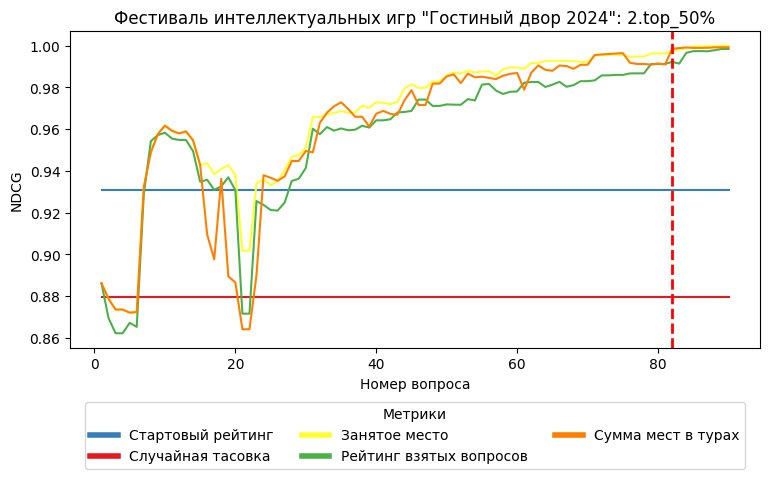
Давайте для начала на посмотрим на масштабе турнира, как эти метрики выглядят, как они меняются по мере прохождения дистанции.

В качестве примера возьмём один массовый синхронный турнир (ОЧР-1) на привычные 36 вопросов и один довольно большой очник с дистанцией подлиннее (Гостиный двор, Калуга). Не забываем про то, что лучшие, средние и худшие команды будем смотреть отдельно.

На двух турнирах в каждом сегменте все наши предсказания лучше случайной выборки. Уже победа.

С увеличением дистанции точность "игровых" дополнительных показателей растёт, это логично. Иногда происходят провалы, это тоже нормально, игра есть игра.

Прогноз "по взятым" оказывается самым точным. Хм, число взятых вопросов в прошлом лучше всего предсказывает число взятых вопросов в будущем? Конечно, мы это ожидали.

А вот факт того, что прогноз "по рейтингу вопросов" и "по сумме мест в турах" окажется не просто хорошим, а лучше прогноза по стартовому рейтингу - это приятные новости.

А теперь неприятный факт. Везде ситуация хорошая и устойчивая. И только в сегменте лучших 10% результаты достаточно волатильны. Маленькие выборки? С одной стороны, да, 7 и 30 команд - не густо. С другой стороны, именно этим командам вопросы перестрелки актуальнее всего.

Но это же просто два турнира. Может, удачные, может, нет. Выводы нужно делать по более широкой выборке.

В комментариях принимаю заказы по построению графиков конкретных турниров. Только, чур, тех, которые закончились до 1 марта 2025.
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →