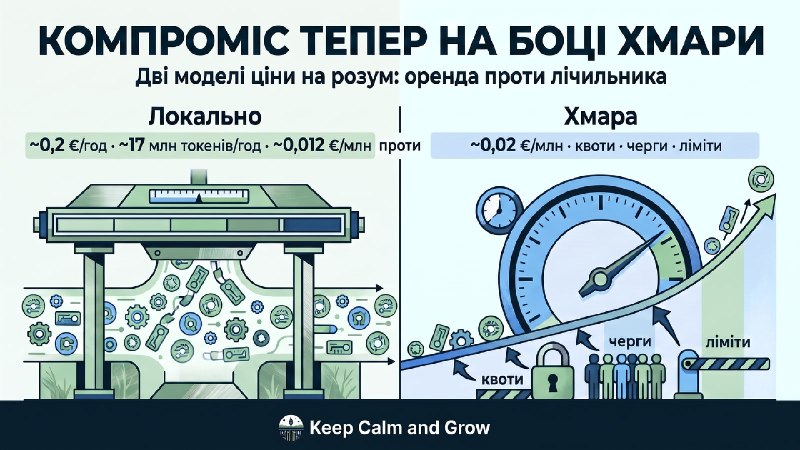
💻 Компроміс тепер на боці хмари
Перевірив цифри і сам собі не повірив: мій ПК ганяє LLM приблизно на 40% дешевше за хмарну підписку - і це вже не компроміс із якістю.
Цього тижня я запустив Qwen3.8-Flash-Next у квантизації IQ3_S на рушії Strata. Шість днів реальної роботи: кодинг, інфраструктура, агенти - близько 460 мільйонів вхідних токенів і 8,6 мільйона згенерованих. Контекст 256K, декод ~110 токенів/с. Artificial Analysis оцінює модель десь на рівні Opus 4.7 - і вперше подібна оцінка збігається з тим, що я бачу на власних задачах.
Два з половиною роки правила гри були зрозумілі: локально = тупіше, повільніше, дешевше хіба що на папері. Цього тижня правила змінились. Компроміс тихо опинився на боці хмари: квоти, черги й ліміти - чим розумніша модель, тим швидше з'їдається квота.
Арифметика проста: поки модель працює, мій сетап жере ~0,5 кВт - це ~0,2 €/год за моїми німецькими тарифами. За годину такої роботи він видає ~17 мільйонів змішаних токенів (вхід + вихід), тобто ~0,012 € за мільйон. Та сама підписка - ~0,02 €/млн токенів для моделей рівня Sol. Машині байдуже, скільки токенів ти ганяєш - хмарі ні. Так, залізка специфічна: RTX 4090, 32-ядерний i9, 128 ГБ RAM... Але за відгуками, найновіші топові Mac можуть видавати майже той самий перформенс але за менше електроенергії.
Питання вже не "чи потягне твоя машина". Питання: чи варта твоя підписка тих швидкостей і лімітів, за які ти платиш? Прем'єра вже не ексклюзивна - а квиток на неї дорожчий. Пропоную офіційно оголошувати початок ери локального інфурунсу, передбаченої декілька років тому.
---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #191
27