TGViewer
Channel Public Channel
Keep calm and grow

Keep calm and grow

@keepcalmandgrow

KCAG - блог для зростання в IT. 📝 Історії, 🧠 ментальне здоров'я, 💻 тех. лайфхаки, 🚀 лідерство/менеджмент. Знання, які хотів би мати 10 років тому.

📩 Зв'язок: @radomyr_kcag
Subscribers
88
Photos
146
Videos
12
Links
148
Recent Posts 16 shown
Post #189 37
💻 Година без ролі розробника

Код за тебе пише AI. А як часто ти користуєшся власним продуктом не для перевірки фічі, а щоб зробити щось потрібне?

Це і є dogfooding: виконувати реальні користувацькі задачі у продукті, який створюєш. Практика давня, хоча назву чую лише нещодавно. З AI вона стає ще важливішою: код і чималу частину рев’ю можна делегувати агентам, а командні правила та контекст описати у skills і runbooks. Але прогалини в розумінні потреб користувача самі так не зникнуть.

Робота інженера зміщується: налаштувати harness - середовище роботи агентів, їхні навички й ролі - та дати їм юзер сторі / юзер кейси. Звідки брати для них матеріал? Зокрема, з власного досвіду користування продуктом.

Забронюй годину в Google Calendar щотижня. Обери одну реальну задачу й пройди її від початку до результату. Без адмінки, готових API-запитів і знайомих обхідних шляхів. Якщо без них ніяк - це вже спостереження, яке варто зберегти.

Увімкни мікрофон і транскрибування на час сесії. Говори вголос: «Де тут мій результат?», «Чому знову треба вводити те саме?», «А воно збереглося?». Фіксуй реакцію одразу, поки мозок не звик до незручності й не викинув її з пам’яті. Не треба переривати кожну дію, щоб акуратно оформити тікет.

Після сесії дай транскрипт AI: нехай згрупує спостереження й допоможе сформулювати юзер сторі та критерії приймання. Наприклад: після збереження людина має бачити підтвердження, а не вгадувати, чи все спрацювало. Де причина незрозуміла - сформуй питання для глибшого ресерчу UX і кодової бази, а не поспішай замовляти фікс.

Це не замінює розмов із користувачами: ти знаєш продукт краще за них. Але дає конкретні ситуації для перевірки й контекст для агентів. У календарі є час на рев’ю коду. А на досвід людини, якій із цим кодом жити?

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #188 49
🚀 Два тижні. Але що це означає?

«На це є два тижні». Начебто домовилися. Тільки для когось це прогноз, для когось межа витрат, а для когось дата релізу. На календарі все сходиться. У головах - не дуже.

Останні сім років у моїй роботі був підхід: визначити, скільки часу варто вкласти в задачу, і шукати рішення в цих межах. Лише нещодавно з’ясувалося, що це усталений підхід із назвою appetite. Тепер цікаво подивитися на нього поруч з іншими відправними точками для планування.

Estimate, або оцінка: скільки часу чи зусиль потребуватиме задумане? Починаємо з потрібного результату, розбираємо роботу й оцінюємо її. Це допомагає порівняти варіанти та узгодити залежності між командами. Але оцінка спирається на те, що відомо зараз. Сама по собі вона не стає обіцянкою.

Appetite, або бюджет часу: скільки ми готові вкласти в розв’язання проблеми? Фіксуємо бюджет часу для конкретної команди й шукаємо корисне рішення в цих межах. Умовно, замість гнучкого конструктора звітів може вистачити одного готового звіту. Якщо навіть мінімальне рішення не вміщується, треба переглянути задум або бюджет, а не вимагати магії від команди.

Зовнішній дедлайн: до якої дати результат має бути готовий? Наприклад, до події, яку не перенести під наш план. Тоді вирішуємо, що обов’язково потрібно до цієї дати, що можна відкласти і чи взагалі план здійсненний. Бажана дата ще не доводить, що все встигнемо.

Ці підходи можна поєднувати. Для мене цікавіше інше: з чого починати саме цей проєкт? З потрібного обсягу, готовності інвестувати чи дати? І про що можемо домовлятися далі? При цьому можливість скоротити функціональність не означає дозвіл здати її з багами.

А у твоїй команді всі однаково розуміють, що означають «два тижні»?

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
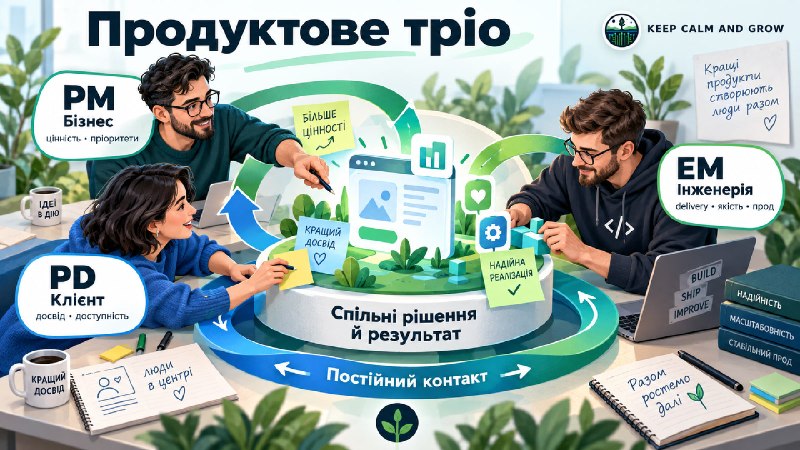
Post #187 50
🚀 Троє в чаті - ще не продуктове тріо

PM (product manager) спілкується з клієнтами, оцінює фічі й вирішує, що робити. Дизайнер малює. Інженер перевіряє, чи це технічно реально, і шукає, як реалізувати. Довго моє розуміння продуктового тріо було приблизно таким: мінімальний склад, здатний розвивати продукт і тримати баланс у складних умовах. У геймдеві близька аналогія - GD + Artist + Tech Lead.

Тільки дизайнеру тут тісно у Figma. Хто вирішує, що важливу фічу чи весь проєкт час закривати? А відповідність GDPR - головний біль PM, EM (engineering manager) чи когось поза командою? «Придумати, намалювати, реалізувати» не дає на це відповідей.

Тепер бачу точнішу модель. Раніше майже все «яким має бути продукт» у моїй картині належало PM. Але дизайн та інженерія теж формують задум, а не лише допомагають його втілити. У варіанті тріо з PM, PD (product designer) та EM це виглядає так:

PM представляє бізнес. Як фіча допоможе бізнесу клієнта і як заробимо ми? Чи варта вона витрат? Що необхідне, а що може почекати? Коли її час прибрати?

PD представляє клієнта. Як виконати завдання без зайвих кліків і плутанини? Яким має бути досвід, зокрема швидкість і доступність? Як це виглядатиме й узгоджуватиметься з рештою продукту?

EM представляє інженерію. Чи можемо це побудувати, ким і коли? Як перевіримо якість, готовність до запуску й роботу в проді? Які технології потрібні, з ким узгодити інтеграції, які напрацювання інших команд використати?

У кожної ролі свій фокус і співмірна відповідальність за продукт. Але це не закриті території: у моделі тріо рішення й результат спільні. Потрібен постійний контакт: питання на кшталт GDPR не зникає після «це не моє». І тріо не замінює потрібних фахівців поза командою.

На наступному обговоренні фічі придивись: ви втрьох формуєте задум чи двоє лише отримують завдання?

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #186 63
Цього тижня я вийшов на нову роботу: Engineering Manager у Pennylane 😌

Уже понад п’ять років найцікавіше в роботі для мене - розвивати інженерні команди й допомагати їм деліверити. А ще мені подобається розбиратися в бухгалтерії та податках: усі 15 років своєї кар’єри я веду облік і займаюся податками самостійно. Так було і в Україні, і в Німеччині. Тож у Pennylane ці два інтереси поєдналися в одній роботі, що максимально надихає зануритись у світ нового для мене домену і продовжувати зрозстання у ньому.

Поки освоююся, часу на довгі дописи небагато. Схоже, тепер писатиму сюди по суботах і можливо тематика постів трошки зміститься в сторону нового домену/скейлу, то ж stay tuned, як то кажуть 🙂

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
  • 🔥 8
Post #185 65
📝 Навіщо нам мова? Підказка з п’яти списків

У юності мене гризло питання: навіщо людству мова і чому вона влаштована саме так? «Щоб спілкуватися» - очевидно. Але про що нам потрібно говорити настільки часто, що без цього не обходиться звичайна розмова?

Кілька днів тому цікавість привела мене до списків із 1000 найуживаніших слів англійської, мандаринської китайської, гінді, іспанської та сучасної стандартної арабської. Арифметична сума оцінок L1+L2 (нейтіви + хто вивчив мову) - 4,18 мільярда мовців, але з повторами через багатомовність.

План був амбітний: порівняти списки й побачити, як мислять носії різних мов. План помер молодим 😅 Списки слів зібрані по-різному, леми й словоформи рахуються за різними правилами, а стандартну арабську переважно опановують через навчання.

Та поки гіпотеза розвалювалася, з’явилася цікавіша картина. Якщо не порівнювати місця буквально, а дивитися на функції слів, у цих п’яти списках повторюються схожі завдання спілкування: позначити себе й іншу людину, запитати, підтвердити або заперечити, сказати «хочу» чи «можу», описати рух, час і місце, подякувати, говорити про близьких.

Це не доводить, що всі люди мислять однаково. Але підказує, яке навантаження мова витримує щодня: узгодити, хто ми одне для одного, що відбувається і що робити далі.

А ще це щеплення проти красивих висновків із даних. Якщо в одній мові слово «Бог» стоїть вище, це нічого не доводить про релігійність її носіїв. Різницю могли створити вигуки, синоніми або склад корпусу. Спочатку методологія - потім психологія.

Можна подивитися на мову як на наш базовий API. І його найзатребуваніші методи звучать так: «Хто ти? Чого хочеш? Що відбувається? Чи можемо ми домовитися?»

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
  • 🏆 3
Post #184 70
💻 SOTA стала тимчасовим ексклюзивом

Схоже, SOTA-моделі перейняли бізнес-модель ігор.

Спочатку day-one реліз доступний лише у хмарі. За найкращу якість платиш преміум просто зараз. А згодом виходить «порт» на локальне залізо - дешевший, приватний і без зовнішніх квот.

Я не збирався перевіряти цю тезу. Просто запустив Qwen3.8-27B у 4-бітній квантизації. 128K контексту повністю вмістився у 24 ГБ VRAM моєї RTX 4090, швидкість - близько 40 токенів за секунду. На моїх задачах із кодом якість нагадує топові хмарні моделі середини-кінця 2025 року. Це не лабораторний бенчмарк, а моя робоча оцінка.

Тобто у моєму випадку «порт» торішнього SOTA-рівня приїхав приблизно за рік.

І навіть не сам. Ollama вже підтримує локально thinking effort, кешування вхідного контексту та speculative decoding - фічі, на яких у моїй голові ще висів бейджик «тільки у хмарі». Граничні витрати на електрику для 1 млн вхідних / кешованих / вихідних токенів вийшли близько €0,039 / €0,0006 / €1,4. Без амортизації: відеокарта й так стоїть у моїй робочій машині.

Хмару ще рано ховати. Сьогоднішні SOTA-моделі першими дають новий рівень якості, і для складних задач ця фора може окупатися. Але їхнє домінування вже не схоже на довічну монополію. Це вікно тимчасової ексклюзивності.

Тому вибір моделі тепер починається не з рейтингу. Він починається з питання: цій задачі справді потрібен day-one рівень? Якщо додаткова якість зменшує ризик, вартість помилки або втрачений час - так. В інших випадках локального «порту» торішнього рівня вже може вистачити.

Можливо, SOTA - це не вершина. Це релізне вікно.

І найдорожчий квиток завжди на прем’єру.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #183 75
💻 ШІ - швейцарський сир. Полюй на дірки

Нещодавно мені трапився TED-виступ Метью Прінса. Зачепила метафора швейцарського сиру.

У Прінса сукупне знання моделей - це швейцарський сир: знань багато, але залишаються дірки. Переказ відомого додає мало цінності. А свіже локальне знання може заповнити прогалину.

ШІ підбере ресторан за рейтингами. Але тільки місцеві знають, де не варто брати креветки, а де завтра гратиме улюблений гурт.

Прінс говорить про контент. Для інженерів підказка: не чіплятися за знайомі задачі, а шукати прогалини між загальною відповіддю та реальністю.

Де документація радить одне, а прод поводиться інакше? Чому метрика росте, а користувачам гірше? Який компроміс працює лише у твоїй системі чи продукті? Тут починається твоя частина роботи.

Власний погляд - це спостереження + досвід + гіпотеза, яку можна перевірити. Ти даєш контекст, визначаєш ризики й критерій успіху. ШІ допомагає знайти варіанти, написати код або зібрати прототип. А відповідь усе одно дає реальність.

Раз на тиждень фіксуй місце, де універсальна порада не спрацювала. Додай доказ, сформулюй гіпотезу, обери найменший безпечний тест і умову, за якої визнаєш помилку. Підключи ШІ до виконання, а висновок додай до контексту команди.

Так і змінюється мислення: твій погляд знаходить прогалину, ШІ допомагає швидше перевірити гіпотезу. Перевірене знання стає частиною контексту команди. А ти шукаєш наступну дірку.

Пережити зміни від ШІ допоможе ця звичка: знаходити й перевіряти те, чого модель не знає про твою реальність.

Якої важливої деталі про твою систему ШІ не знає?

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #182 74
💻 MCP-сервер - вже не wrapper для REST API

Коли MCP тільки з’явився, сервери часто будували як адаптери: загорнути REST-ендпойнти в tools - готово.

Тепер агенти через MCP можуть повторити виклик, використати застарілі дані чи запустити не ту операцію. Тому MCP-сервер - це інженерна межа між агентом і системою.

Ось чотири практики проєктування MCP-серверів із мого досвіду роботи над Anki MCP і Workstream Cockpit.

1. Ізолювати сервери, які працюють постійно. Для кількох локальних допоміжних інструментів вистачить stdio. А якщо MCP-сервер має працювати постійно, я особисто надаю перевагу Docker і Streamable HTTP. Контейнер відокремлює внутрішній стан MCP-сервера від середовища, яке запускає агента.

2. Не реалізовувати протокол самотужки. В основі Anki MCP - FastMCP з офіційного Python SDK. Для TypeScript є офіційний SDK, для Java - Spring AI MCP starters. Менше власного транспортного коду - більше уваги до логіки інструментів.

3. Проєктувати tools під сценарій, а не відтворювати CRUD-модель. Агенту корисніша одна завершена операція: перевірити, чи дані не застаріли, а залежності валідні, застосувати зміни та проконтролювати результат. У Workstream Cockpit expectedVersion захищає від запису поверх уже змінених даних. Що менше кроків оркеструє модель, то менше місць для помилки.

4. Розділяти читання, запис і небезпечні операції. У режимі лише для читання інструментів запису й видалення не має бути навіть у tools/list; права все одно перевіряються на кожному виклику. Для зміни з невисоким ризиком мінімальний запобіжник - confirmed: true. Для критичних змін краще працює схема: preview → короткоживучий токен, прив’язаний до конкретної операції → mutation. У мене модель з такою схемою перепитувала, якщо вибір був неочевидним.

Секрети надходять із конфігурації, захищеного сховища або через OAuth - і ніколи не передаються через tools.

Якщо MCP лише повторює REST API, інтерфейсу для агента ще немає. Це просто Swagger, який навчився говорити JSON-RPC.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
  • 🤨 2
  • ❤ 1
Post #181 77
💻 Як не перетворити флешкартки на ще один конспект

Прочитати й зрозуміти ще не означає згадати в потрібний момент. З документацією все було ясно, а перед виходом у продакшен у голові раптом 404 Not Found.

Флешкартки закривають саме цю прогалину: замість чергового перечитування ти бачиш запитання й відтворюєш відповідь із пам’яті. Anki та інші системи інтервальних повторень планують наступні покази залежно від оцінок попередніх відповідей.

Але все залежить від самої картки. Погана картка тренує не пам’ять, а телепатію: що саме тут питають, наскільки повною має бути відповідь і чи зараховувати оце «ну, майже»?

Тому під час створення картки я перевіряю чотири речі.

1. Де це знання має спрацювати? Не «що я хочу записати?», а «що треба згадати в реальній ситуації?». Замість «Поясни since і for» краще: «The migration has been running ___ Monday». Є конкретний контекст і одна потрібна дія: підставити since.

2. Чи можна забути частини незалежно? Якщо так - це різні картки. Замість «Що роблять no-store і no-cache?» зроби дві: «Що робить no-store?» і «Що робить no-cache?». Інакше одну частину пам’ятаєш, іншу ні, а картку все одно треба оцінити цілком.

3. Яку навичку тренує запитання? Упізнати термін, відтворити визначення й ухвалити рішення - не те саме. «Що таке rollback?» перевіряє знання поняття. «Новий реліз спричинив зростання помилок, безпечний відкат готовий, швидкого виправлення немає. Що робити спочатку?» - уже перевіряє вміння обрати дію.

4. Чи можна чесно оцінити відповідь? Заздалегідь визнач коротку відповідь, якої достатньо, щоб зарахувати картку. Наприклад, для «Що таке SLO?» це може бути: «Цільове значення SLI за визначений період». Варіанти формулювання, приклад і пояснення залиш у підказці після перевірки - їх не треба відтворювати дослівно.

Середній час повторення картки 5-10 секунд - гарний орієнтир якісної картки.

Кожна нова картка - це не лише знання, а й майбутні повторення. Тому добра колода - не та, де збережено все. Це найменший набір карток, які допомагають згадати потрібне в потрібний момент і варті подальшої уваги.

А якщо захочеться створювати й підтримувати такі картки разом з AI-асистентом, я виклав готовий headless MCP-сервер для Anki. Він працює без Anki Desktop, запускається в Docker і синхронізується з AnkiWeb або власним сервером.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
  • ✍ 3
Post #176 80
💻 Спочатку сенс, потім пікселі: автоматизовані постери на межі користі й краси

Продовжуємо серію мануалів. Минулого разу йшлося про паралельну роботу агентів над кодом через Hermes Agent. Тепер маємо іншу систему на базі OpenClaw: автоматична генерація постерів.

Навіщо потрібні постери?

Хороший постер перетворює складну тему на візуальну модель. Головну думку видно за кілька секунд, а деталі відкриваються під час уважнішого перегляду. Його зручно зберігати.

Але запит «зроби красиву інфографіку» часто дає красивий хаос. Потрібен конвеєр від фактів до зображення.

Як він працює

1. Бриф. Він стає еталоном для всього циклу: мета, аудиторія, джерела, формат, точні написи, обов'язкові зв'язки й те, чого не можна вигадувати.

2. Visual executor. OpenClaw запускає ізольованого агента для одного постера. Він відповідає за структуру, генерацію, перевірку й повторні спроби.

3. Семантичний маніфест. У ньому записано, що зберегти дослівно, що можна переосмислити візуально, які твердження заборонені та яку залежність показати.

4. Візуальна граматика й HTML-макет. Агент вибирає шлях, цикл, контраст або карту системи. Потім детерміновано збирає макет із фактами, ієрархією та маршрутом погляду. Це креслення сенсу, не фінальний дизайн.

5. Перевірка макета. Агент рендерить HTML у PNG і перевіряє факти, зв'язки, читабельність та рух погляду. Лише після цього макет передається генератору.

6. Генерація. Макет стає семантичним і композиційним орієнтиром. Генератор може змінити верстку, образи, палітру й типографіку, але не зміст.

7. Перевірка й ревізія. Готовий постер звіряється з маніфестом: текст, факти, артефакти, візуальна ієрархія. Якщо красиво, але незрозуміло, агент редагує або генерує знову, потім повторює перевірку.

8. Рішення людини. Система проходить майже весь цикл самостійно. Людина визначає, чи постер корисний, красивий і готовий до публікації.

До поста додаю п'ять різних постерів, автоматично створених цим workflow. Якщо потрібні деталі або розбір етапу, питайте в коментарях чи пишіть у приват.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #175 76
💻 Як я паралельно запускаю чотирьох агентів-інженерів

Сьогодні трохи розкажу про свій воркфлоу agentic-розробки з Hermes agent.

Мені близька філософія Hermes: «ШІ достатньо розумний - просто не заважай йому працювати». Тому для свого side-project Workstream Cockpit я вибудував воркфлоу з безпечними ізольованими енвами, де кілька агентів можуть працювати паралельно. Але про все по порядку.

1. Починаю з feature request

У спільному трекері лежить backlog із короткими ідеями. Продуктовий агент знає контекст, користується проєктом через MCP та бачить спільний backlog.

Прошу перетворити кілька задач на feature requests: що змінити, як має поводитися фіча та як зрозуміти, що вона готова. Для паралельного запуску беру незалежні задачі.

2. Кожна сесія працює окремо

Окремий профіль Hermes памʼятає, де шукати код, як запускати й писати тести та які edge cases уже траплялися.

GitHub-токен із мінімальними правами налаштований у профілі й доступний лише для цього репозиторію. Прямий push у master заблокований. hermes -w створює окремий worktree та Git-гілку, а команди виконує в Docker-контейнері. Сесії працюють у різних гілках, тому помилку легше локалізувати.

3. Чотири панелі - чотири задачі

Відкриваю tmux, ділю екран на чотири панелі й у кожну вставляю свій feature request. Гардрейли для імплементації: додати тести, прогнати кілька тисяч backend- і frontend-тестів, за потреби оновити документацію та створити PR.

Перед завершенням кожен агент-інженер запускає агента-ревʼюера без контексту реалізації. Той читає diff, а автор PR виправляє зауваження.

4. Моє ревʼю працює як карусель

PR часто прилітають одночасно. Беру перший, читаю diff, шукаю треш, зайву складність і пропущені сценарії. Складну фічу збираю локально й роблю smoke test. Передаю правки та переходжу до наступного PR.

Після мерджу інші сесії підтягують master. Якщо виникає конфлікт, агент отримує завдання розвʼязати його. Так стрибаю між панелями, поки не змерджу всі PR.

У підсумку маю конвеєр: feature request → ізольована розробка → незалежне ревʼю → моє ревʼю → мердж.

Що б ти тут спростив, автоматизував або зробив безпечніше?

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #174 75
💻 Не тільки KTLO: 5 типів роботи "проміж іншим"

Про KTLO (“keep the lights on”) був попередній пост. Підтримка продакшена, оновлення, інциденти, борги - це теж робота, яку можна покласти в план.

Але є ще шар, який команди роблять щодня і часто не називають. Не фічі, не баги, не “просто мітинги”. Робота між рядками.

Не модель світу - шпаргалка для планування.

1. Дослідження (Discovery) - коли незрозуміло, що насправді відбувається. Інтервʼю, аудит, spike. Тут важливо сформулювати питання, обмежити пошук у часі й вийти з рішенням або наступним тестом. Discovery - це не “повчимося ще трохи”.

2. Рішення (Decision) - коли проєкт “заблокований”, але рішення так і не зʼявилося. Треба різати scope, приймати ризик, казати “це не робимо”. Тут потрібні варіанти, критерії, trade-offs і короткий запис, чому саме так.

3. Координація (Coordination) - коли люди, залежності й очікування можуть розʼїхатись. Follow-up, handoff, синхронізація, пошук контексту. Нудно, але рятує нерви: хто відповідає, наступний крок, дедлайн, залежність і коли ескалювати.

4. Осмислення (Sensemaking) - коли з хаосу треба витягнути практичний урок. Постмортем, схема, дока, назва для патерну. Корисно лише тоді, коли після цього змінюється майбутня дія, а не просто всі відчули себе розумними.

5. Ремонт (Repair) - коли просіли якість, довіра, темп або запас сил. Тут мало “пофіксити баг”. Треба назвати, що постраждало, кому потрібна впевненість, і яку домовленість чи перевірку додати, щоб не повторити те саме.

На наступному плануванні спитай: це фіча, баг, KTLO - чи один із цих типів прихованої роботи?

Робота без назви не зникає. Вона просто маскується під шум - а потім тихо ламає план.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #173 78
Є такі машини, на які зазвичай дивишся без жодної філософії. Ну бензовоз і бензовоз: велика штука, яка возить якусь нереальну кількість пального. Інколи бачиш його на дорозі, інколи - на заправці, коли він зливає вміст у резервуари АЗС. Ось, наприклад, абсолютно рандомний маленький 20 000-літровий бензовоз. Перший, який попався під руку, коли я ковиряв інтернет. Деталі за посиланням, якщо раптом захочеться роздивитись ближче.

А потім мозок випадково робить дурну математику - і все, картинка вже не розвидниться. Наші сімейні авто за останні 10 років сумарно проїхали приблизно 190 тис. км. Якщо дуже грубо взяти середню витрату 9 л/100 км, виходить десь 17 000 літрів пального. Тобто наші машини за цей час вижерли приблизно 85% такого бензовозу. І тепер я дивлюсь на ці машини трохи інакше 😅

P.S. Пост не по графіку і без великого висновку. Але, можливо, тепер і ти на бензовози будеш дивитись трохи по-іншому.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
  • 👍 1
  • 🔥 1
Post #172 82
💻 KTLO - робота, яку не видно в плані

У кожної команди є робота, яка не виглядає як “нова фіча”, але без неї все повільно розсипається.

Підтримати старий сервіс. Почистити чергу багів. Оновити залежності. Розібратися, чому алерт шумить третій тиждень. Відповісти сапорту. Підняти впалий джоб. Пояснити, чому “дрібний баг” ламає половину сценарію.

У цієї роботи є нормальна назва - KTLO, Keep The Lights On. Дослівно - тримати світло увімкненим. По-інженерному - робити все, що не додає блискучу нову кнопку, але підтримує продукт, команду і її комітменти живими.

KTLO - це не тільки “підтримка продакшена”. Це ціна вже зроблених обіцянок.

Коли фіча вже в користувачів - її треба підтримувати. Коли сервіс вже є частиною інфраструктури - його треба оновлювати. Коли інтеграція вже працює - вона колись зламається. Коли є алерти - хтось має розуміти, які з них важливі, а які просто щодня їдять увагу.

Проблема починається не тоді, коли KTLO багато. Проблема починається, коли його не видно в плануванні, але всі поводяться так, ніби воно має магічно зробитися між задачами.

Тоді біль проявляється дуже буденно: спринт знову не вліз, сеньйори весь час зайняті, оцінки не працюють, команда наче багато робить, але план не рухається.

Часто відповідь нудніша, ніж хочеться: частина команди підтримує вже запущене, але ця робота не має окремого місця в плані.

KTLO не треба романтизувати. Це не героїзм і не привід пишатися хаосом. Але його треба бачити.

Бо якщо робота потрібна, щоб продукт жив, вона не “між іншим”. Вона просто ще не отримала нормальне місце в плані.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
  • 👾 1
Post #171 80
💻 Чому для job sourcing знадобилася своя тулза, а не ще один скрол LinkedIn

А що, якщо проблема не в тому, що вакансій мало? Під час пошуку роботи легко повірити, що треба просто більше скролити LinkedIn, частіше оновлювати Indeed/DOU/Djinni/etc. і чекати, поки алгоритм нарешті покаже щось нормальне. Але в якийсь момент стає зрозуміло: це вже не пошук вакансій, а job sourcing. Треба збирати джерела, відфільтровувати шум, памʼятати рішення й розуміти, чому одні ролі проходять далі, а інші летять у “не підходить”.

Масові платформи тут не погані. Вони просто оптимізовані під іншу гру. Їм треба швидко відповідати мільйонам людей, нормально ранжувати результати, показувати promoted jobs і не дозволяти кожному запускати по великій базі свій маленький SQL-хорор. А мені іноді треба було навпаки: кривий, повільний, дуже особистий фільтр і 10-20 секунд очікування. Для глобального продукту це жах. Для мого процесу - норм.

Другий біль виявився ще важливішим: state пошуку не належить тобі. Якщо нотатки, відфільтровані вакансії, причини “не підходить” і вся історія живуть всередині чужої платформи, нормальну ретроспективу зробити майже неможливо. Для світчерів це особливо боляче: треба швидко вчитись, перевіряти гіпотези про ринок, бачити повторювані патерни й розуміти, чому до одних ролей хочеться повернутись, а інші треба відсікти ще на вході.

Так зʼявився JobScan. Кілька місяців він був моїм щоденним інструментом. Починалось усе як простий парсер по таймеру, а виросло у self-hosted інструмент для соурсингу вакансій: дошки вакансій, локальний кеш, пошук, легкий CRM-пайплайн для ролей, збережені рішення і підтримка 35+ ATS-sources. Не вилизаний SaaS. Не “майбутнє рекрутингу”. Просто інструмент під конкретний процес, а не під середнього користувача на планеті.

Масові інструменти виграють масштабом, але іноді програють точністю. А локальний інструмент може бути некрасивим, повільним і дивним - зате він тримає форму саме твого процесу. Якщо хочеться власну систему для job sourcing, repo тут: https://github.com/raslab/jobscan

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Post #170 79
🧠 Одна цінність, кілька різних ігор

Найцікавіше в цінностях не сам список.
“Гроші важливі”, “кар’єра важлива”, “сім’я важлива”, “здоров’я важливе” - це ще майже нічого не пояснює. Важливо інше: з якого стану людина дивиться на цю цінність.

Візьмемо гроші. Нудний приклад, зате працює.

Для виживання гроші - це страховка. Подушка, запасний вихід, можливість не залежати від токсичного менеджера, ринку чи чужого настрою. Тут питання не “скільки хочеться?”, а “чи мене можна загнати в кут?”.

Для ідентичності гроші - це доказ. Що вже не треба просити дозволу. Що є сила, свобода, статус, здатність захистити свої межі. Гроші тут не тільки про купити. Вони про “я тепер не та людина, яку можна легко посунути”.

Для досягнення гроші - це рахунок у грі. Маркер масштабу, підтвердження, що система працює. Не “хто я?”, а “що вдалося побудувати?”.
І вже тут часто починаються конфлікти. Двоє людей кажуть “гроші важливі”, але одна говорить про безпеку, інша - про перемогу. Формально слова ті самі. Всередині - різні операційні системи.

Для належності гроші - це можливість підтримати своїх: сім’ю, команду, спільноту.

Для довгої гри - здоров’я, дім, репутація, діти, майбутні опції. Менше дофаміну, більше відповідальності за роки вперед.

Для сліду після себе - ресурс навчати, менторити, будувати речі, які переживуть твій поточний sprint.

Для сенсу й гри - спосіб купити час на цікавість, красу, віру, мистецтво або радість без очевидного KPI.

І це тільки одна цінність. Те саме можна зробити з кар’єрою, здоров’ям, сім’єю, свободою, навчанням, навіть з “хочу спокою”. Тому питання не лише “які в тебе цінності?”. Краще питання: з якого місця всередині тебе ця цінність зараз говорить? Бо якщо людина захищає безпеку, їй марно продавати славу. Якщо шукає ідентичність, сухий план може не спрацювати. Якщо вже грає в довгу гру, “а давай просто ризикнемо” звучить не як свобода, а як баг у проді.

---
🌱 Keep calm and grow | 💬 Обговорити 1-на-1
Older posts →

About this channel

How can I read @keepcalmandgrow without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Keep calm and grow: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Keep calm and grow have?
Keep calm and grow (@keepcalmandgrow) has 88 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Keep calm and grow know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →