TGViewer
Channel Public Channel
Канал Олега Етеревского

Канал Олега Етеревского

@eterevsky_log

Группа для комментрирования: t.me/eterevsky_log_comments
Subscribers
450
Photos
183
Videos
27
Links
181
Recent Posts 19 shown
Post #659 234
Я как-то пропустил момент, когда достаточно умные LLM модели стало можно легко запускать прямо на своём компьютере. Они даже могут что-то напрограммировать, хотя и медленнее чем в облаке.

Проще на маке, потому что память у процессора и GPU общая.

1. Устанавливаем ollama.
2. ollama run qwen3.8:27b

И всё, модель скачивается и работает. (Требуется в районе 16-20 гигабайт памяти.) Можно подключить её в VSCode.
  • ❤ 3
Post #658 451
Небольшая жалоба вдогонку к предыдущему посту. На немецком я учу слова в обе стороны: c немецкого на английский и наоборот. В немецком языке есть бесконечное количество слов которые значат что-то типа "процесс, процедура, прогресс", и все они очень похожи:

Ablauf
Verfahren
Verlauf
Vorgang
Vorgehen

Вспомнить одно конкретное из этих слов по его переводу на английский почти невозможно.
  • 🔥 5
  • 🤮 1
Post #657 383
В январе я решил, что 2026-й год будет для меня годом когда я наконец прилично выучу немецкий язык. После 11-и лет жизни в Швейцарии стыдно разговаривать с людьми на ломаном немецком уровня B1.

Я поставил две цели: (минимум) сдать B2, и (максимум) читать условного Томаса Манна. B2 я сдал уже в июне, а вот над Манном придётся ещё поработать.

Строго говоря, я уже читал целые книги на немецком: "Превращение" Кафки и "Хроники кенгуру" (немецкая сатира про чувака, у которого появился сосед кенгуру-коммунист). Но в обоих случаях я тратил огромное количество времени и усилий чтобы хоть как-то следить за повествованием. Когда я пробовал читать или слушать книги без словаря, но быстро терял даже поверхностное понимание происходящего.

В этом году я решил поменять подход и начать с того, чтобы выучить слова. Да, я никогда до этого не сидел зубря иностранные слова. Английский выучился как-то сам собой просто из-за количества книг, фильмов и сериалов, которые я на нём читал и смотрел. С немецким так почему-то не вышло.

К счастью, на дворе 2026-й год и изучение слов можно по крайней мере частично автоматизировать.

Первая составляющая для этого — это приложение Anki.

Работает это так: вы загружаете в него словарь, который хотите выучить. Ставите целью каждый день повторить какое-то количество слов. Anki выбирает слова, которые вы хуже всего помните, и понемногу добавляет новые слова. Для каждого слова вы вспоминаете его перевод, и потом смотрите ответ. В зависимости от того, вспомнили ли вы его правильно, и насколько сложно это было, нажимаете одну из кнопок: Again, Hard, Good, Easy. "Again" слова повторяются в эту же сессию, остальные переносятся на более поздние дни. Чем увереннее вы в слове, тем больше пауза прежде чем вам покажут его опять.

На карточках можно писать не только отдельные слова, но и другие вещи: артикли, чтобы запомнить рода и падежи, предлоги, целые выражения — всё что нужно выучить.

Я начал с того, что стал добавлять слова из уроков и жизни. Но потом вспомнил что на дворе 2026-й год и у нас есть AI. Я взял книгу, которую я читаю и попросил Клода выписать из следующей главы все слова уровня B1 и выше, которые ещё не добавлены в мои карточки. Несколько минут — и у меня есть список из 100-150 слов чтобы учить следующую пару недель.

То же самое можно сделать с субтитрами. Chrome-расширение Subadab позволяет сохранять субтитры с Netflix'а. Клод их читает и выписывает слова. После того как слова выучены, можно сесть и прочитать главу или посмотреть серию не отрываясь на словарь.

Я повторяю по 200 слов в день. Это занимает около 35 минут и позволят добавлять по 10-20 новых слов. Уровень B2 — это в районе 4000 слов. Чтение книг: 5-10 тысяч в зависимости от.

К апрелю я заметил, что новый режим изучения работает для меня очень хорошо. Скорость прогресса оказалась значительно выше чем в любой период за предыдущие 10 лет. Я начал относительно свободно понимать каждодневные тексты типа новостей на 20 Minuten.

В этот момент я решил поставить эксперимент и посмотреть, смогу ли я точно так же учить язык, которым я никогда раньше не занимался. Например японский.

Моё знание японского на тот момент сводилось к: нетвёрдому знанию слоговых азбук; примерно сотне слов, которые я выучил из аниме; 2-3 базовым грамматическим частицам. Я решил, что возьму самую простую мангу, которую смогу найти, и выучу минимальный набор слов и грамматики, необходимый чтобы прочитать её от начала до конца не заглядывая в словарь и понимая всё на 100%.

В качестве такой манги я взял "Сью и Тай-тян" (スーと鯛ちゃん) — комикс про котов, в котором в доме с пожилой кошкой Сью появляется котёнок Тай-тян. Первый том манги включает 16 глав (+одна бонусная) на 125 страницах. Изучая японский только с Anki (100 карточек в день — в два раза меньше чем для немецкого) мне потребовалось 4 месяца чтобы полностью его прочитать. Что я выучил за это время:

- 232 знаков из двух слоговых азбук (включая комбинации) — многие из них я уже знал
- 170 кандзи
- около 550 слов

Помимо этого в словаре было 320 карточек для разных грамматических конструкций. В японском много грамматики которая модифицирует смысл текста или отношение говорящего, и это оказалось едва ли не большей сложностью чем изучение кандзи. Я попробовал несколько подходов и в итоге остановился на том, чтобы добавлять по 3-5 карточек на каждую конструкцию, используя одни и те же базовые слова. Скажем, если я учу конструкцию "я хочу", то карточки получаются "я хочу спать", "я хочу играть", "я хочу писать", а если я учу "похоже он ...", то карточки "похоже он спит", "похоже он играет", "похоже он пишет".

Отдельно стоит сказать о том, как я доставал эти слова. В отличие от обычной книги, из манги не получается просто скопировать текст. Современные AI-модели неплохо понимают картинки, но с текстом в комиксах у них бывают проблемы:

1. В манге написано なんて言うかな? Но без な в конце смысл тот же. Напишу-ка я просто なんて言うか.
2. В манге написано あずかって слоговой азбукой? Мне что, 6 лет? Напишу по-взрослому 預かって.
3. Да, да, я знаю что панели и колонки текста идут справа-налево. Но иногда об этом забываю и пишу как получится, слева-направо.

После нескольких экспериментов оказалось, что единственная модель, которая может без ошибок транскрибировать текст это Gemini Flash. В итоге Клод получил от меня API key, чтобы вызывать Gemini и использует его для транскрипции.

Если кому-то интересно повторить мой опыт, я могу в комментариях выложить словарь который я составил и скан манги.
  • 🔥 10
  • ❤ 4
Post #656 398
Я абсолютно уверен, что сейчас в мире живёт не только 10, но и 100 человек, с музыкальными способностями Моцарта. Не только потому, что население Земли в 10 раз больше, чем во времена Моцарта, но и потому что наш мир во много раз богаче, и люди с музыкальным талантом могут себе позволить заниматься музыкой.

Вопрос: почему же мы не видим этих десятков Моцартов? Ответ: потому что порог для гениальности и величия относителен. То что раньше воспринималось пределом человеческого мастерства, со временем становится само собой разумеющимся. Век назад марафон за 3 часа был олимпийским достижением. Сейчас это время сильного любителя, а рекорд опустился ниже 2-х часов.

Возвращаясь к музыке, я уверен, что скажем Джейкоб Коллье превосходит Моцарта во всех существенных музыкальных способностях: в исполнительском мастерстве, в композиции и т.д. Но станет ли Коллье также известен как Моцарт? Вероятно нет, потому что известность главным образом зависит не от мастерства, а от того, насколько музыка соответствует требованиям публики.
  • ❤ 6
  • 👍 4
Post #655 528
House of Leaves — первая бумажная книга, которую я купил за долгое время, потому что она не работает в других форматах.

Это роман про книгу про фильм про дом с лабиринтом, с основной сюжетной линией полностью рассказанной в сносках.

Глава про то как некоторые герои блуждают по лабиринту, сама представляет собой лабиринт из текстов, сносок, примечаний и правок.
  • 🔥 11
  • 🤯 2
Post #654 620
В комментариях угадали 3 из 4-х. Правильные ответы:
- Andreas
- Sebastian
- Marcel
- Alois
  • ❤ 4
Post #653 636
Мы живём в швейцарской деревне. У простых швейцарцев тут не принято пользоваться полными именами, так что все всех знают под короткими именами (типа «Саша» вместо «Александр»)

Внимание вопрос. Восстановите полные имена 4-х из наших соседей (в порядке возрастания сложности):
- Andy (Анди)
- Seby (Зеби)
- Mäsi (Мэзи)
- Wiesi (Визи)
Post #652 607
Прочитал отличный лимерик:

Said a boy to his teacher one day,
“Wright has not written rite right, I say.”
And the teacher replied,
As the error she eyed,
“Right! Wright: Write rite right, right away!”
  • 😁 7
  • 🔥 2
  • ❤ 1
Post #651 655
Лайфхак. Если вы много летаете, то наверное заметили, что в последние годы в Европе в аэропортах не любят заранее писать номер гейта.

Решение: открыть FlightAware или другой аналогичный трекер и посмотреть на гейты того же рейса в предыдущие дни. Как правило, это даст вам представление о том в какую часть терминала идти.
  • 👍 5
  • 🥰 2
  • 🔥 1
  • 🤔 1
Post #650 777
Где-то раз в пять лет я начинаю более активно чем обычно заниматься музыкой. Года два играю, учу песни, потом следующие несколько лет не подхожу к пианино. Предыдущий такой период у меня закончился с Ковидом, когда из-за него прекратились мои уроки по пению. В прошлом декабре я наконец повернул рубильник в положение Вкл. и начал опять заниматься.

Хожу на уроки с новой преподавательницей и чувствую что чему-то научился. Вот видео песни из Les Misérables, которую я записал ещё в апреле: https://youtu.be/-5Edo6aQBmU
YouTube Stars (from Les Misérables) Enjoy the videos and music you love, upload original content, and share it all with friends, family, and the world on YouTube.
  • 🔥 10
  • 👍 5
  • 👏 2
Post #649 991
Я тут недавно открыл для себя Честертона. С огромным удовольствием прочитал The Man Who Was Thursday — одновременно детектив, фарс и философский роман.

Закончив с Четвергом, я принялся за книги про отца Брауна. По формату это похоже на Шерлок Холмса и Пуаро: детективные рассказы с развязкой в конце. Тут пока у меня нет однозначного впечатления, но некоторые вещи меня поражают.

В одном из рассказов (спойлер) невероятная завязка: любовная линия, герой, который сначала выступает в бродячем цирке, а потом изобретает и начинает продавать роботов (в книге 1911-го года). И потом развязка: убийца — почтальон. Точка. По-моему, это рекорд контраста между завораживающим сюжетом и банальностью развязки.
  • 😁 6
  • 👍 3
  • 🤩 2
  • 🤔 1
Post #648 1K
Мне нравится читать hard sci-fi: фантастику, которая не делает допущений за пределами известной нам физики. Если мы путешествуем от звезды к звезде, то космический корабль не может превышать скорость света. Но это лишь полбеды. Более жёсткое ограничение на скорость накладывает закон сохранения импульса: чтобы разогнать ракету в одну сторону, нужно потратить массу, разогнав её в противоположную сторону.

Какую скорость мы можем достигнуть используя самые эффективные известные нам методы?

Если исключить масштабное производство антиматерии, то самый эффективный двигатель который я смог придумать основывается на термоядерной реакции: мы берём водород и превращаем его в гелий, попутно конвертируя 0.7% его массы в энергию. (Теоретически можно продолжать реакцию вплоть то железа, но это даёт всего 0.2% дополнительной энергии.) Полученную энергию мы полностью конвертируем в кинетическую, разгоняя гелий для реактивной тяги.

Если я не ошибаюсь, такой двигатель имеет максимальную возможную тягу на единицу массы топлива, если не прибегать к аннигиляции и не использовать внешние источники энергии или импульса.

Предположим масса нашего корабля распределена следующим образом:
* 1/2 массы — водород для разгона
* 1/4 массы — водород для торможения
* 1/4 массы — всё остальное, включая сам корабль, двигатель и полезную нагрузку

Внимание вопрос: до какой скорости мы сможем разогнаться в таких условиях?

Ответ: в идеальных условиях такой двигатель позволит разогнать ваш космический корабль примерно до 25,000 km/s или 0.08c. Путешествие в одну сторону до Альфа Центавра на таком корабле займёт 55 лет.

Из плюсов: водород — это самый распространённый элемент в природе, так что вы сможете заправиться им в любой солнечной системе.
  • 🔥 15
  • 🤯 2
  • 😢 1
Post #647 815
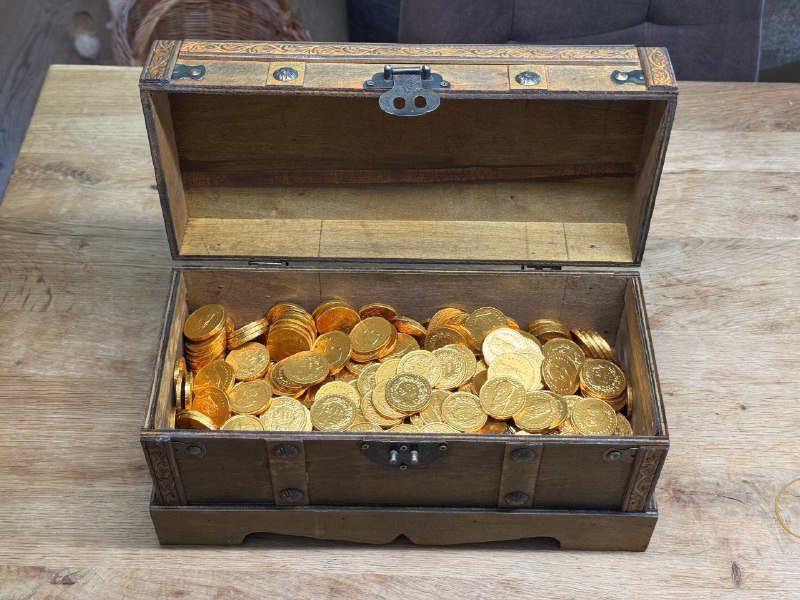
А вот кстати подарок, который мы готовили на вчерашнюю свадьбу, и который не успел до конца приехать к дню X. Да, это шоколадные монеты.
  • ❤ 6
  • 🔥 2
  • 👎 1
  • 🤩 1
Post #645 750
В мае мы были на Fantasy Basel и я сделал для него мини-косплей Силко из Arcane. Сегодня нас позвали на свадьбу и я заметил, что косплей Силко минус глаз и гамаши — это отличный fancy прикид, который можно подходит для такого мероприятия.
  • ❤ 14
  • 🔥 7
  • 🤮 1
Post #644 935
Я решил немного переключиться с постов про историю в Slow History и написал пост в мой основной Substack под заголовком "What I Believe" ("Во что я верю"): https://eterevsky.substack.com/p/what-i-believe.

Идея в том чтобы идентифицировать в какие мои убеждения я верю абсолютно, не допуская возможности что они могут оказаться неверными (по модулю предположения что я нахожусь в здравом уме). Я нашёл четыре таких утверждения:

1. Математика, по крайней мере конструктивная математика, верна.
2. Окружаемый нас мир объясним, и более простые объяснения обычно верны.
3. Мои мысли и чувства существуют.
4. Страдания — это плохо.

В статье я написал подробно что я имею в виду под каждым из этих пунктов.

Этим списком не ограничиваются все мои убеждения, но мне кажется что большинство из практических ответов вытекают из этих 4-х утверждений/фреймворков.
Substack What I Believe A Twitter user writes: "I've never heard a single atheist explain to me What exactly they believe."
  • ❤ 13
Post #643 869
В ходе написания одного из постов для моего блога (https://slowhistory.substack.com/) я сделал интересное, не скажу открытие, но наблюдение.

Речь идёт о событиях лета 1456-го года. Вся Европа с замиранием сердца следит за тем как огромная турецкая армия идёт в наступление на Белград. На фоне этих событий папа Римский выпускает буллу Bulla Turcorum, которая предписывает всем католическим церквям звонить в колокол в полдень чтобы напомнить всем помолиться за избавление от неверных. Приходит июль, христианская армия побеждает, но традиция остаётся. Теперь колокол в полдень звонит в память о чудесном избавлении.

Половина источников в интернете и за его пределами немного путает даты, и пропускает первый период, говоря что звонить сразу предписывается в память. Но в остальном все сходятся: Bulla Turcorum, колокола, полдень.

За исключением одного источника: факсимиле самой буллы, напечатанного Гутенбергом в 1456-м году. С ним можно ознакомиться вот тут: https://dpul.princeton.edu/scheide/catalog/0v8380652. В тексте буллы написано "inter nonas et vespas", "между девятым часом и вечерней", то есть между примерно 15:00 и 18:00.

В этой находке интересны два аспекта:

1. Все статьи это либо пропускают, либо считают несущественным. К примеру, Википедия пишет "During the siege of Belgrade (1456), Callixtus initiated the custom that bells be rung at midday to remind the faithful to pray for the crusaders. The tradition of the Angelus noon bell still exists in most Catholic churches to this day."

2. В 2025-м году хрен с горы пишущий любительский блог по истории, не знающий латынь и не умеющий читать готический шрифт с загадочными сокращениями, может в два счёта найти такую деталь. Ну вы наверное поняли как. Я пробовал все топовые AI-и и уверенно читать манускрипты и инкунабулы может только Gemini. ChatGPT с огромным трудом может прочитать за 10 минут одну строчку, остальные вообще отказываются.

P.S. В процессе написания этого поста, я решил в четвёртый раз проверить что я ничего не упускаю, сверил слово-за-словом транскрипцию с факсимиле и нашёл что Gemini пропустил целую строчку посреди ключевого фрагмента. После того как я поставил его перед этим фактом, оказалось, что слова есть, но смысл фрагмента они не меняют, и он решил опустить их в транскрипции. "In my effort to provide a flowing translation, I oversimplified that highly abbreviated and complex section of the text." Вот так
Substack Slow History | Oleg Eterevsky | Substack Daily history: one month at a time. Click to read Slow History, by Oleg Eterevsky, a Substack publication. Launched a year ago.
  • 🔥 9
  • 😱 4
  • 😁 1
Post #642 927
В блоге про историю (см. предыдущие посты) первый майлстоун — я закончил 1453-й год. Хотя я и ставил себе целью закончить хотя бы один полный год, но мне всё равно немного странно. Я ожидал бросить этот проект после 2-3 постов.

Вероятно главная причина по которой я продолжаю это делать, это то что мне самому интересно, что будет дальше. Если бы кто-то другой писал подобный блог или серию книг в таком формате, я бы просто сел и прочитал их. Но никаких подобных проектов мне не известно, так что приходится писать самому.

Я стараюсь писать с запасом, так что у меня на данный момент написано ещё 6 записей до конца первой половины 1454-го года. Такой буфер также позволяет двигать секции между уже написанными, но ещё не опубликованными постами и исправлять в них ошибки.

На данный момент мой процесс выглядит следующим образом:

1. Я читаю Википедию и прошу Gemini, ChatGPT и Claude research составить мне обзор событий за целый год. Суммируя все эти ответы я пишу примерный план на год, разбитый на 12 постов.

2. Начиная заниматься конкретным месяцем, я прошу Gemini Pro Deep Research изучить всё что есть про события этого месяца, обращая особое внимание на события запланированные на этот пост. Gemini читает в среднем 200 веб страниц из которых большая часть абсолютно бесполезны, и пишет от 20 до 40 страниц текста, больше половины из которых повторяет тексты про другие месяцы. Даже названия этих репортов повторяют друг друга. Почти все говорят про "world in flux".

Репортам написанным Gemini можно доверять примерно на 80%. Часто проблема даже не в том, что он галлюцинирует (хотя и это бывает), а в том что в интернете просто нет достаточного количества информации про интересующие меня события. Решение тут — найти цельные книги и скормить их ему. К примеру, я нашёл PDF какой-то польской книги про Тринадцатилетнюю войну, даже без OCR, и Gemini отлично её съел и переварил.

Другой life hack — явно попросить его искать информацию не только на английском, но и на китайском/японском/итальянском/польском/турецком — на языках тех стран, для которых данное событие было наиболее релевантно.

3. Я читаю репорт Gemini, пропуская повторяющиеся части. Иногда я запускаю дополнительный research в Gemini или в Claude про отдельные вопросы или события. По моим ощущениям Gemini слишком многословен, но Claude больше врёт.

4. Получив представление о том, о чём следует рассказать в какой-то месяц, я делаю одно из двух: либо а) я пишу весь текст поста из головы, либо б) я пишу план поста, присоединяю репорт Gemini и дополнительные материалы и прошу Claude написать пост по моему плану на основании этих материалов, после чего иду по тексту Клода, сокращая и переписывая отдельные куски.

5. Полученный черновик поста я вставляю в новую сессию Gemini и прошу его сделать подробный fact-check, а также сказать мне что можно добавить. Gemini пишет ещё один 20-страничный репорт, на сей раз более сфокусированный на том что я рассказываю. По существу он может найти 1-2 ошибки в датах или деталях которые я неправильно понял, и иногда добавляет 1-2 интересные детали про которые я забыл или не знал.

6. Финальный драфт я вставляю обратно в Claude чтобы отредактировать ошибки и стиль. Это — самая приятная часть процесса. Мне обычно довольно трудно писать тексты из головы именно потому что они обычно получаются немного корявыми. Много времени уходит на то чтобы найти правильные слова, связки и т.д. В Клоде я просто выделяю пару слов, говорю ему что они к примеру звучат слишком заумно и он тут же всё исправляет.

Итого, один пост занимает 2-3 часа. Это конечно очень много. Есть надежда что со временем, по мере улучшения AI'ев, некоторые из этих шагов можно было бы сократить. К примеру, было бы очень удобно если бы Gemini в том же чате где он делает research мог написать по-человечески написанный текст на 2 страницы. К сожалению, по-человечески умеет писать только Claude, а делать research с большим количеством информации — только Gemini.
  • 🔥 7
  • 👍 5
  • ❤ 4
Post #641 816
В порядке эксперимента я решил попробовать начать блог, о котором я писал в прошлом посте. Встречайте: Slow History, https://slowhistory.substack.com/

Пока что я написал маленькое вступление с описанием идеи: https://slowhistory.substack.com/p/coming-soon, введение на момент начала 1453-го года: https://slowhistory.substack.com/p/1453-setting-the-stage и два первых месячных поста, которые выйдут завтра и послезавтра.

Подготовка каждого поста занимает в районе пары часов, значительно дольше, чем я ожидал, несмотря на активное использование AI-ев. В конечном итоге получилось, что львиную долю текста пишу я сам, а AI используется в основном для начального research'а и фактчекинга. Впрочем, я не оставляю тщетных попыток заставить AI писать так как написал бы я сам.
Substack Slow History | Oleg Eterevsky | Substack Daily history: one month at a time. Click to read Slow History, by Oleg Eterevsky, a Substack publication. Launched a year ago.
  • 👍 9
  • ❤ 2
Older posts →

About this channel

How can I read @eterevsky_log without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Канал Олега Етеревского: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Канал Олега Етеревского have?
Канал Олега Етеревского (@eterevsky_log) has 450 subscribers on Telegram, refreshed roughly every 30 minutes.
Does Канал Олега Етеревского know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →