TGViewer
Channel Public Channel
404 Driver Not Found

404 Driver Not Found

@drivernotfound

Канал об ML в автономном транспорте от специалистов из Яндекса: разбираем научные статьи, делимся интересными находками, обсуждаем горячие вопросы индустрии.

Вопросы и предложения > @yandex_ml_brand
Subscribers
1.53K
Photos
88
Videos
2
Links
58
Recent Posts 11 shown
Post #111 366
Mask2Map: Vectorized HD Map Construction Using Bird's Eye View Segmentation Masks

Что будет, если объединить лучшие практики из Deformable-DeTR, DN-DeTR, Mask2Former, MapTR и MapTR v2? Узнаем из статьи о Mask2Map — методе построения векторных HD-карт по данным автомобильных сенсоров.

Главная идея довольно проста: получить хорошее представление дорожной разметки в виде BEV-масок, а затем использовать эти маски как геометрическую подсказку для векторного декодера.

Mask2Map состоит из двух основных частей:

🔴 IMPNet строит instance-level сегментацию по BEV-фичам сенсоров и формирует маски вместе с соответствующими query.

🔴 MMPNet превращает эту информацию в векторные элементы карты: предсказывает их класс, геометрию и порядок точек.

Пайплайн начинается с построения BEV-представления. Фичи от сенсоров переводят в BEV и обрабатывают на нескольких масштабах. Дальше Mask2Former-подобная часть выполняет инстанс-сегментацию: получает собственную маску и эмбеддинг объекта для каждого элемента карты.

После этого плотную маску нужно превратить в компактное геометрическое представление. Для этого её бинаризуют, прореживают скользящим окном, оставляя репрезентативные точки, и в конце применяют Farthest Point Sampling (FPS). В результате вместо большого числа пикселей остаётся небольшой набор пространственных координат (x, y).

Параллельно модули PQG и GFE формируют query и добавляют в них семантическую и геометрическую информацию из BEV. Идея в том, чтобы дать декодеру более осмысленную стартовую точку, чем полностью свободные обучаемые эмбеддинги.

Дальше всё это попадает в Mask-Guided Map Decoder. Полученные из масок точки используются как геометрические подсказки и опорные точки для деформируемого кросс-аттеншна, после чего декодер восстанавливает итоговую векторную геометрию элементов HD-карты.

Если совсем упростить, архитектуру можно представить так: сенсоры → BEV → instance masks → опорные точки → vector map. То есть левая часть Mask2Map во многом напоминает Mask2Former, а правая — MapTR/Deformable DETR, связанные BEV-масками, которые дают векторному декодеру сильный spatial prior.

Вместо того чтобы заставлять DETR-подобный декодер полностью с нуля искать геометрию дорожных элементов, авторы сначала решают более простую задачу сегментации, а затем используют её результат для инициализации и направления векторного предсказания.

Отдельно во время обучения используется знакомая по DN-DETR идея расшумления queries: GT-объекты искусственно зашумляются, после чего модель учится восстанавливать исходную геометрию. Это помогает стабилизировать обучение и облегчает сопоставление query с объектами карты.

По результатам авторов Mask2Map на момент публикации заметно превосходил предыдущие методы на nuScenes и Argoverse2: прирост составлял до 10,1% mAP и 4,1% mAP. Познакомиться с кодом можно на GitHub проекта.

Разбор подготовил ❣️ Денис Глазов
404 driver not found
  • 🔥 9
  • ❤ 5
  • 👍 4
  • 🤯 2
  • 🎉 1
Post #110 709
Qwen-Drive-1.0: An Initial Step towards a Vision-Language Foundation Model for Autonomous Driving

Современные подходы к автономному вождению часто разделяют восприятие, предсказание и планирование на отдельные модули. Но сейчас всё больше моделей переходят на end-to-end-предсказание с дообучением VLM под задачи вождения.

В частности, 31 августа команда Alibaba выпустила Qwen‑Drive‑1.0 — собственную модель в этой области. Это интересный релиз, потому что команда Qwen — один из безусловных лидеров в мире опенсорсных VLM, но это её первый заход в модели для вождения.

Авторы стартуют с Qwen3.5-4B и дообучают её, исходят из ключевых дизайн-принципов:

🔴 Для длинного хвоста ситуаций нужно минимально менять исходную VLM так, чтобы она при этом продолжала справляться с общими темами.
🔴 Для хорошего понимания сцены важны подзадачи 3D-реконструкции и разнообразный visual QA.

Чтобы достичь этого, предобученную VLM усилили двумя элементами:

🔴 BEV-голова для персепшна извлекает явную 3D-информацию: детекция объектов, предсказание occupancy, сегментация карты.
🔴 Planning Expert генерирует будущую траекторию эго-автомобиля на основе представлений VLM, используя flow matching.

Qwen‑Drive‑1.0 обучают в четыре стадии: первые две — для персепшна, следующие — для планнера.

1. Претрейн перспешна. Замораживают основную модель, обучают только новую BEV-голову на задачах 3D-детекции, occupancy, сегментации.
2. Совместное обучение персепшна и VQA. Размораживают визуальный энкодер и VLM. Обучают модель одновременно на данных для 3D-персепшна и «вопросах-ответах» по сцене вождения. Секретный ингредиент — микс данных: 64,3% составляют задачи вождения, 26% — общие задачи VAQ, 9,7% — 3D-персепшн. Это позволяет приобрести навыки вождения, не забывая общие знания.
3. Претрейн Planning Expert. Замораживают основную модель, обучают эксперта генерировать траектории.
4. Обучение с подкреплением (RL). Финально дотюнивают Planning Expert.

Собственные сырые данные почти не собирали, но смогли адаптировать широкий набор из примерно 30 публичных датасетов (включая nuScenes, Waymo WOD-E2E, NAVSIM). Многое пришлось унифицировать: например в таксономии классов объединили все типы автомобилей. Геометрию пришлось сгладить, чтобы получить одинаковую растеризацию карты и идентичные траектории на 50 точек. Для VQA-вождения многие запросы переформулировали большими умными VLM.

В итоге свои гипотезы авторы частично подтвердили: общие знания почти не проседают, бенчмарки очень близки к исходным. Понимание дорожной ситуации значительно улучшилось.

При этом Qwen-Drive-1.0 справляется с вождением так же хорошо, как специализированные end-to-end-модели. Новая модель получила PDMS 90,7 на NavSim. Это хороший результат, хотя и не SOTA: end-to-end SimWAM выбила 91,5, а модель со скорингом CLOVER — 94,5.

Интересно, что персепшн используют только для обучения, в инференсе планнера его нет. В аблэйшне авторы пробуют совсем исключить персепшн-стадию — планнер при этом работает не сильно хуже.

Модель выглядит симпатичной, авторы не бенч-максят, а честно валидируют общий подход.

Разбор подготовил ❣️ Кирилл Федянин
404 driver not found
  • 🔥 10
  • 🤩 7
  • ❤ 5
  • 👍 1
  • 😱 1
Post #100 648
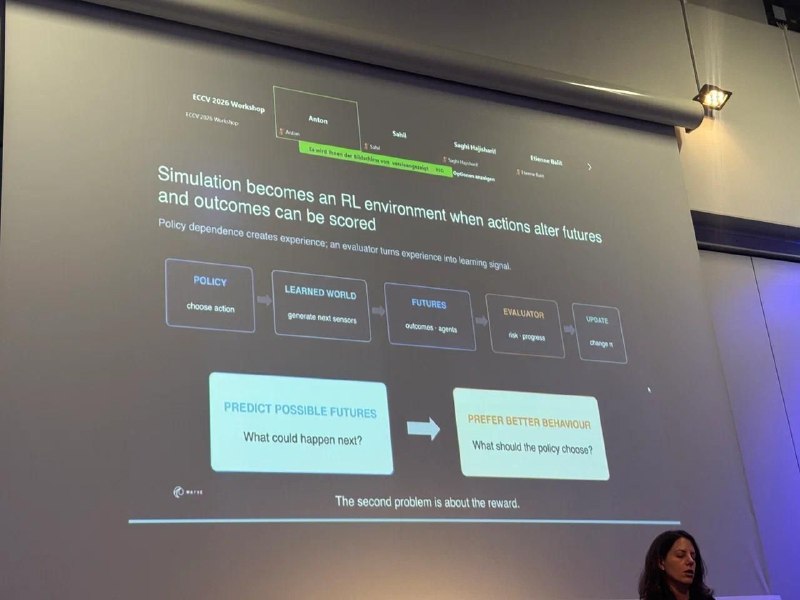
Автономный транспорт на ECCV 2026: несколько слов о долгосрочном развитии

На воркшопе Emerging Behaviors for Achieving Robust Autonomy обсуждали надёжность автономного транспорта. В нескольких докладах, как из индустрии, так и из академии, чётко прослеживались одни и те же тезисы по развитию планировщиков для автономных автомобилей:

🔴 Развитие ML-планировщиков движется в сторону end-to-end-моделей.
🔴 Уже сейчас индустрия активно использует RL для обучения ML-планировщиков: пока в варианте RL post-training в симуляции. Ресёрч идëт в сторону RL-обучения с нуля, в том числе и для end-to-end-сетей.
🔴 И в индустрии, и в академии интенсивно пытаются использовать Self-play RL. Это был один из важных ингредиентов успеха AlphaGo, которая тренировалась играть сама с собой в го и в итоге впервые обыграла человека в эту игру.
🔴 Чтобы RL для end-to-end планировщика заработал, нужен быстрый симулятор с достаточно высоким качеством имитации сенсоров: без sim-to-real gap. Это пока остается исследовательской задачей. Даже NVIDIA, которая довольно далеко продвинулась в задаче симуляции сенсоров для роботов, пишет о том, что sim-to-real gap все ещё частая проблема.
🔴 Надёжный планировщик не сделать только на основе записанных логов. Симулятор должен уметь генерировать сложные случаи для обучения и тестирования. Для этого нужна эффективная world model, созданием которой занимаются и в академии, и в индустрии.

Академические боли тоже остаются прежними. В докладе PRIX: Learning to Plan from Raw Pixels for End-to-End Autonomous Driving авторы добились SOTA на нескольких бенчмарках для планировщика в автономном транспорте. Но на последнем слайде честно написали, что не могут предсказать, как модель будет вести себя в реальности, на живом роботе или автомобиле с ограниченными вычислительными возможностями. Это общая проблема академических исследований: своего флота автомобилей у них нет, а открытые бенчмарки требуют дополнительной валидации.

Наблюдениями поделился ❣️ Виктор Юрченко
404 driver not found
  • ❤ 9
  • ❤‍🔥 6
  • 👍 5
  • 🔥 2
  • 🤩 1
Post #99 943
π0.5: a VLA with Open-World Generalization

π0 — система, которая помогает делать large-scale pre-training для робототехники, где нет web-scale-датасетов. Как она устроена, рассказывали в одном из предыдущих постов. А сегодня разберём статью о новой версии системы — π0.5.

В статье речь идёт о роботах-манипуляторах, но сама идея общая задача → semantic subtask → low-level actions выглядит применимой и к другим embodied-системам — например, автономному транспорту.

Чтобы превратить π0 в π0.5, авторы придумали несколько важных вещей. Во-первых, токенайзер FAST:

🔴 переводят траектории в частотное представление с помощью discrete cosine transform (DCT),
🔴 обнуляют незначимые коэффициенты,
🔴 оставшиеся коэффициенты разворачивают в одномерную последовательность и объединяют в BPE-токены.

На этапе претрейна next-token-prediction с CE учится гораздо быстрее диффузии и легко смешивается с другими задачами для претрейна VLM (ещё вернёмся к этому). На post-train добавляется диффузионный action-эксперт, с помощью которого итоговая модель предсказывает непрерывные траектории.

Во-вторых, модель учат предсказывать не только действия, но и подзадачи. Например, «взять подушку» для задачи «убраться в спальне». Для этого используют как размеченные траектории роботов, так и обычные vision-language-данные из интернета — картинки с текстовой разметкой (их на порядки больше, чем траекторий).

Таким образом, в претрейне используют очень разнородные материалы: траектории разных роботов, задачи на предсказание высокоуровневых действий и VLM-данные из интернета. Авторы называют этот подход heterogeneous co-training и связывают с ним способность модели обобщаться на новые окружения и задачи.

Этап 1. Тело VLM претрейнят на смеси данных. Для размеченных траекторий модель сначала предсказывает текстовые токены подзадачи, а на их основе — FAST-токены траектории.

Этап 2. На пост-трейне добавляется action-эксперт. Вся модель файнтьюнится под мобильных роботов-манипуляторов с помощью CE для FAST-токенов и flow-matching loss для непрерывной траектории. При этом эксперт видит весь префикс, включая подзадачу, но не FAST-токены.

Для быстрого инференса FAST-токены уже не генерируются. Модель сначала определяет высокоуровневую подзадачу, затем эксперт предсказывает непрерывную траекторию на её основе.

Эксперименты показали, что такой подход к обучению помогает улучшить генерализацию: робосистема начинает лучше справляться с долгосрочными многошаговыми задачами. Для автономных роботов это, например, самостоятельная уборка целой комнаты в незнакомом доме.

Разбор подготовил ❣️ Сергей Репьевский
404 driver not found
  • ❤ 11
  • 🔥 3
  • 🤩 3
  • 😁 2
  • ❤‍🔥 1
  • 🥰 1
Post #98 994
BEVDiffuser: Plug-and-Play Diffusion Model for BEV Denoising with Ground-Truth Guidance

Денойзинг-диффузионки итеративно превращают нормальный шум в изображения. Но есть проблема: результат такой генерации непредсказуем. Чтобы победить это, процесс расшумления можно представить в виде нейросети, обучив её на узкоспециализированном датасете и добавив кондишнинги — например, на расположение объектов внутри сцены (layout).

Оба этих подхода требуют обучения дополнительных моделей. Сегодня разберём статью о том, как применить layout-conditioning во время обучения диффузионки для денойзинга BEV feature, не меняя архитектуру энкодера.

Основные этапы — на схеме. После энкодера featuremap не передают в Task Heads, а расшумляют. На этом всё могло бы закончиться получением идеально расшумлённого представления, если бы не одно «но»: шум оригинальный, безошибочно восстановленных BEV map’ов нет. То есть, вместо денойзинга featuremap’ы диффузионка может сгенерировать фейковую сцену, потому что куда расшмуляться — непонятно.

Авторы предлагают считать изначальный шум достаточной оценкой того, как выглядит система без шума и оптимизироваться исходя из этого, параллельно с задачей расшумления.

Энкодер замораживают. Денойзинг-диффузионку используют как супервайзера BEV-энкодера без вмешательства в его архитектуру.

Результаты впечатляют: на момент выпуска BEVDiffuser показывал SoTA-результаты на датасете nuScenes: +12,3% в mAP и +10,1% in NDS для детекции 3D-объектов по сравнению с другими популярными моделями.

Разбор подготовила ❣️ Дарья Сапожникова
404 driver not found
  • 🔥 9
  • ❤ 4
  • 👏 3
Post #97 1.11K
Learning Rollout from Sampling: An R1-Style Tokenized Traffic Simulation Model

Сегодняшняя статья о том, как адаптировать RL-алгоритм GRPO к задачам автономного транспорта. Авторы проанализировали распределение энтропии для разных сцен и по результатам сформулировали следующее:

1. У сложных сцен (Waymo Hard) более высокая энтропия токенов, поэтому имеет смысл увеличить exploration.

2. В простых сценах (Waymo Easy), наоборот, излишнее семплирование вносит ненужный шум.

Лучше использовать адаптивное семплирование. Авторы предлагают вариант, где параметр K в TopK зависит от энтропии: K_t = k_min + (k_max — k_min) / (1 + e^(-H_t))

Авторы утверждают, что при таком разделении по сложности после RL уменьшается энтропия и улучшаются метрики в hard-кейсах. От себя добавлю, что не хватает ablation, какое распределение энтропии получается после обычного RL.

Отдельного внимания заслуживают выбор параметров и способ обучения:

🔴 При group-нормализации нет деления на STD, только вычитают среднее — из-за небольшого количества траекторий дисперсия может быть шумной.
🔴 Делают KL-дивергенцию на претрейн-политику (ref-политика).
🔴 В качестве ревордов используют произведение ADE_like_reward и Collision_reward.
🔴 Замораживают энкодер агентов и карты за исключением последнего слоя

Таким образом, авторы предлагают подход для эффективного баланса между exploration и exploitation. Предложенный сетап RL выглядит интересно, и некоторые идеи вполне могут работать на практике.

Разбор подготовил ❣️ Павел Лукьянов
404 driver not found
  • 👍 9
  • ❤ 6
  • 🔥 6
Post #96 1.12K
LISO: Lidar-only Self-Supervised 3D Object Detection

Разметка 3D-боксов очень дорогая, долгая и плохо масштабируется. А сырых LiDAR-логов, наоборот, очень много. Сегодня разберём статью о том, как использовать лидарные данные о движении объектов для разметки.

Сначала авторы готовят начальную разметку. Пайплайн такой:

1. По соседним LiDAR-кадрам считают ego motion — движение эго-агента.
2. Вычисляют scene flow — движение каждой точки между кадрами.
3. Вычитают ego motion из scene flow, чтобы получить residual motion — относительное движение.
4. Точки с ненулевым residual motion считают движущимися объектами.
5. Кластеризуют точки с ненулевым residual motion и собирают их в 3D-боксы.
6. Следят, как перемещаются боксы с течением времени, и чистят шум — так получается начальная разметка.

Следующий этап — итеративный self-training. Модель-детектор обучают на полученной разметке и прогоняют по начальной разметке, чтобы получить новые боксы. Потом снова строят треки, фильтруют шум, улучшают разметку и обновляют псевдо-GT. Обучение повторяется до тех пор, пока и псевдо-разметка и сама модель не улучшатся до требуемых пределов.

Хотя начальная разметка содержит только движущиеся объекты, детектор обучается на single-frame point cloud — поэтому постепенно начинает находить и способные двигаться объекты. Например, припаркованные машины. То есть движение используется только как bootstrap-сигнал, а дальше модель дообучается по геометрии сцены.

На момент публикации LISO стабильно обгонял другие self-supervised-подходы на WOD, KITTI, AV2 и nuScenes, хотя до fully-supervised-моделей ему ещё было куда расти.

Разбор подготовил ❣️ Фарух Яушев
404 driver not found
  • ❤ 12
  • 🔥 5
  • 🤩 4
  • ❤‍🔥 1
Post #95 1.21K
Long-Range 3D Perception — датасет и методы детекции отдалённых объектов

Сегодня вас ждёт подборка статей на тему детекции отдалённых объектов. Это важная задача, поскольку на скорости 100 км/ч автомобиль проезжает ~28 м/с, поэтому для безопасного торможения и перестроения нужно видеть препятствия на расстоянии 150–200 метров, а классические бенчмарки такую дальность обрезают. NuScenes размечен до 50–80 м, KITTI — до 70 м.

Дальние объекты — это отдельная боль: у лидара на 150 метрах на объект остаются единицы точек, на камере он занимает десятки пикселей, и в датасетах таких объектов на порядки меньше ближних, из-за чего модели переобучаются на ближнюю зону. Поэтому начнём с датасета — здесь лучше всего подходит Argoverse 2. Он содержит 1000 размеченных картиночных сцен с семью камерами, объекты размечены на удалении до 200 метров. Каждая сцена длится 30 секунд, частота — 20 fps. Датасет размечен по 30 категориям, причём почти все категории имеют более 10 000 боксов. Лидар работает на 10 Гц.

Основные методы для детекции отдалённых объектов:

LiDAR-only
FSD, FSDv2 — полностью sparse lidar-only модели. Основная идея: собрать точки в группы (соответствующие объектам) и процессить эти группы отдельно. Внутри каждой группы точки предсказывают центры объектов, которые далее используются для предсказания бокса. В v2 кластеризация в группы заменена на работу с виртуальными вокселями (локальное объединение точек). Основные результаты представлены на Argoverse 2 до 200 метров. FSDv2 показывает результаты, близкие к SoTA c latency < 100ms.

Camera-only (Far3D)
Far3Det — чтобы построить модель для отдалённых объектов, авторы решили «почистить» датасет NuScenes от сцен с неполной разметкой, оставив только те, в которых размечены все объекты вплоть до 80 метров. Также предложили вариант адаптивного NMS (AdaNMS) для изменения IoU threshold в зависимости от расстояния.

Far3D — SoTA на NuScenes в сетапе camera-only на момент публикации. Результаты на Argoverse 2 похуже, чем у FSDv2, но это sparse camera-only модель. На основе StreamPETR построена модель, в которой используются адаптивные query. Для их генерации на этапе LSS лучи кидаются на основе 2D-детекций.

Fusion
Towards Long-Range 3D Object Detection for Autonomous Vehicles — статья с двумя улучшениями для детекции отдалённых объектов. Во-первых, это использование двух отдельных сетей для ближних (до 110 м) и отдалённых (от 100 м) объектов с фьюзом детектов на пересечении. Во-вторых, авторы используют Multimodal Virtual Point для генерации псевдолидарных точек на основе 2D Instance Segmentation. Результаты посчитаны для Argoverse 2: каждый из фиксов улучшает FSDv2;

SparseFusion — по сути является sparse-версией BEVFusion. Для обеспечения разреженности все свёрточные операции заменены на sparse. На этапе LSS берутся только top K расстояний из распределения вдоль лучей. Сами лучи кидаются только внутри боксов 2D-детекций. Результаты сравниваются на Argoverse 2. По метрикам SparseFusion немного переигрывает BEVFusion, при этом по latency метод более чем в три раза быстрее. Но на срезе 100–200 метров результаты у BEVFusion чуть лучше.

Что в итоге выбрать?
• LiDAR-only — FSDv2: результаты близкие к SoTA на Argoverse 2 при latency < 100 мс, самый практичный вариант для продакшена.
• Camera-only — Far3D: SoTA на nuScenes, но на Argoverse 2 заметно уступает лидарным методам — камер пока недостаточно для надёжной детекции на 200 м.
• Fusion — SparseFusion: в 3+ раза быстрее BEVFusion при сопоставимом качестве, но на срезе 100–200 м dense-подход всё ещё чуть точнее — на дальности разреженность даёт о себе знать.

Общий тренд хорошо виден: работают sparse-архитектуры вкупе с адаптивными приёмами (AdaNMS, адаптивные query, отдельные головы для разных дальностей). А среди датасетов Argoverse 2 с разметкой до 200 м фактически стал стандартом для long-range задач.

Разбор подготовил ❣️ Иван Лунев
404 driver not found
  • ❤‍🔥 9
  • ❤ 6
  • 🔥 6
  • 👍 2
Post #94 1.07K
FutrTrack: A Camera-LiDAR Fusion Transformer for 3D Multiple Object Tracking

Сегодня разберём работу о модульном фреймворке для трёхмерного трекинга множества объектов. Подход основан на совместном использовании трёх типов информации:

📌BEV-фичей, извлечённых из данных камер и LiDAR;
📌detection queries, полученных при уточнении 3D-детекций;
📌track queries, перенесённых с предыдущего кадра.

BEV-фичи вычисляют с помощью стандартного пайплайна BEVFusion.

Detection queries получают из отдельного блока smoother. Это энкодер-декодерная архитектура, обученная на вспомогательной задаче временного уточнения исходных 3D-детекций. Энкодер собирает для каждой детекции контекст по нескольким кадрам. Декодер уточняет положение, размеры и класс объекта.

При этом в основной трекер передаются не сами итоговые детекции, а извлечённые из промежуточного слоя object-query-представления, сформированные в процессе решения задачи уточнения. Они и становятся detection queries текущего кадра.

Track queries — промежуточные query-представления, сформированные основным трекинговым декодером на предыдущем кадре. Для подтверждённых активных треков модель сохраняет связанные с ними скрытые представления и передаёт их на следующий кадр. Таким образом, между кадрами переносятся не сами предсказанные боксы, а признаки, аккумулирующие информацию о положении, классе и идентичности каждого отслеживаемого объекта.

После независимого кодирования все три типа информации объединяются с помощью трансформера с multi-head attention. Track queries предыдущего кадра выступают в роли queries, detection queries текущего кадра — keys, а BEV-фичи — values. Благодаря этому модель сопоставляет активные треки с новыми детекциями и извлекает из BEV-представления необходимый пространственный и семантический контекст.

Декодер предсказывает обновлённые координаты, размеры, классы, идентификаторы и значения уверенности объектов. Промежуточные query-представления подтверждённых треков рекуррентно передаются на следующий кадр, поэтому непрерывность трекинга поддерживается без отдельной модели движения или фильтра.

Система заточена на модульность: можно менять способ получения BEV‑фич, а также подключать разные детекторы, обучая их независимо или совместно.

Авторы показывают, что FutrTrack превосходит предыдущие трансформерные методы по основным метрикам 3D-трекинга. При этом он всё ещё уступает SOTA-трекерам, основанным на гибридных пайплайнах, в которых обучаемые нейросетевые компоненты сочетаются с явно заданными моделями движения или ассоциации объектов.

Таким образом, полностью data-driven подход на основе трансформеров пока не демонстрирует устойчивого преимущества над системами, использующими геометрические и вероятностные ограничения. Особенно важными такие ограничения остаются в ситуациях с неполными или неоднозначными наблюдениями. Например, при длительных перекрытиях, пропусках детекций или в плотном трафике.

Разбор подготовил ❣️ Олег Данилин
404 driver not found
  • ❤ 13
  • ❤‍🔥 5
  • 👍 4
  • 🔥 1
Post #93 1.15K
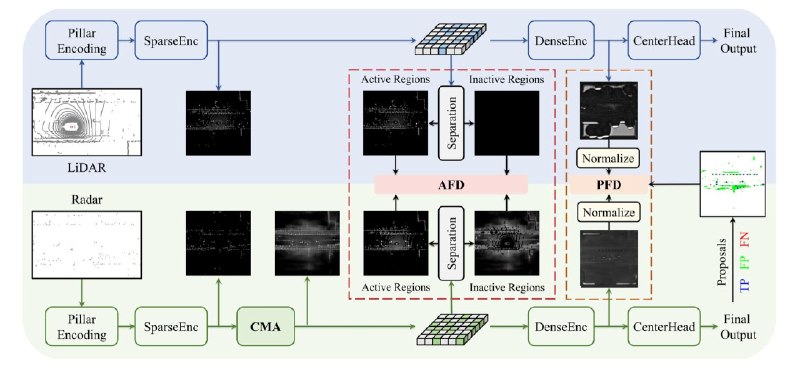
RadarDistill: Boosting Radar-based Object Detection Performance via Knowledge Distillation from LiDAR Features

Lidar-only детекторы работают заметно лучше, чем radar-only. Причиной тому — разница в качестве данных. Лидар фиксирует более точные и многочисленные точки, в то время как радар склонен выдавать false-positive и false-negative результаты из-за переотражений и других физических тонкостей. Улучшить работу radar-only детекторов можно благодаря дистилляции.

Сегодня разберём статью о том, как получить мощный radar-only детектор с помощью lidar-only детектора. Авторы предложили несколько способов продвинутой дистилляции, учитывающих разную природу лидарных и радарных данных.

Наивная дистилляция путём матчинга фичей лидарного энкодера в фичи радарного работает плохо. Это происходит из-за особенностей радарных и лидарных данных: разной плотности точек, зашумлённости, рассинхронизации сенсоров.

Авторы предлагают три способа улучшения дистилляции:

1. Cross-Modality Alignment. Использование небольшой FPN-like сетки поверх радарной фичамапы, чтобы сделать радарные фичи такими же плотными, как лидарные.

2. Activation-based Feature Distillation. Перевзвешивание лосса в областях фичамапы с ранней стадии энкодера, где есть амплитудные лидарные фичи, помогает акцентировать внимание нейросети на релевантных областях BEV-а.

3. Proposal-based Feature Distillation. Перевзвешивание лосса в областях фичамапы с поздней стадии энкодера позволяет сфокусировать внимание нейросети на областях с GT.

Полная архитектура RadarDistill — на схеме выше. Обратите внимание, что лидары используются только на этапе обучения и не требуются для инференса.

Использование всех трёх улучшений одновременно позволяет увеличить mAP в 2 раза и NDS в 1,25 раз на nuScenes относительно radar-only from scratch.

Разбор подготовил ❣️ Владимир Филипенко
404 driver not found
  • 🔥 8
  • ❤ 6
  • ❤‍🔥 4
  • 👍 2
Post #92 1.27K
Вас посетил маленький, но очень громкий робот-рекламщик

Время сделать перерыв. Например, перечитать один из наших обзоров ICML 2026:

➡️ Генерация реального города Seoul World Model, memory bias в RL, совместное обучение VLA и WM: что обсуждают на ICML 2026 [1/2]

➡️ Генерация реального города Seoul World Model, memory bias в RL, совместное обучение VLA и WM: что обсуждают на ICML 2026 [2/2]

➡️ Три статьи об автономном транспорте с ICML 2026

➡️ Безопасность, ускорение end-to-end, prediction в частотной области: чем запомнился ещё один день ICML 2026

#YaICML2026

Поймал в объектив робота-рекламщика и лучшие моменты ICML 2026 ❣️ Иван Дубровин
404 driver not found
  • ❤ 12
  • 🥰 5
  • 🔥 4
  • 🤩 2
Older posts →

About this channel

How can I read @drivernotfound without a Telegram account?
TGViewer shows the public web preview Telegram publishes for 404 Driver Not Found: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does 404 Driver Not Found have?
404 Driver Not Found (@drivernotfound) has 1.53K subscribers on Telegram, refreshed roughly every 30 minutes.
Does 404 Driver Not Found know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →