TGViewer
Channel Public Channel
开发者工具箱|编程·开发工具·资源

开发者工具箱|编程·开发工具·资源

@devtoolboxhub

面向开发者的实用工具、库与效率技巧,写代码更快更爽。投稿 @BDHT1
#开发者 #编程工具 #效率 #程序员
Subscribers
780
Photos
1.4K
Videos
0
Links
761

Showing posts older than #1726 · Back to latest

Older Posts 11 shown
Post #1724 13
Chrome MV3 扩展精准捕获 DOM 元素

在传统截图工具中,截图总是先抓取视口再裁剪,导致捕获的不是目标元素本身。Snaptura 通过四大技术解决这一痛点:

1. 按设备像素捕获
captureVisibleTab() 返回的位图已包含 devicePixelRatio,直接按 CSS 维度裁剪会产生模糊或尺寸错误。Snaptura 在裁剪前将矩形乘以 DPR,并记录 DPR,保证导出图像 1:1 清晰。

2. 智能悬停选择
通过向上遍历节点并按可见面积与语义权重评分,选择最符合用户意图的祖先元素(如卡片、按钮),并在页面层级绘制不影响原页面的高亮。

3. 全页捕获与粘性元素处理
在滚动拼接时先检测 position: sticky/fixed 元素,按滚动位置隐藏或固定正确版本,使用 scrollTo({top, behavior:'instant'})requestAnimationFrame 确保无缝拼接。

4. 像素前的 DOM 级隐私遮蔽
通过在 DOM 中插入占位元素并隐藏原节点,捕获前完成遮蔽,避免敏感文本被渲染到 PNG 或撤销栈中。

此外,Snaptura 采用 MV3 的 Service Worker 与 OffscreenDocument 组合,保持后台轻量,支持 GIF 与视频编码。免费版无水印,Pro 版提供高级功能。


GitHub: GitHub

#开发者 #工具 #ChromeExtension #MV3 #DOMCapture #隐私保护 #全页截图 #滚动拼接
@DevToolboxHub
Post #1719 11
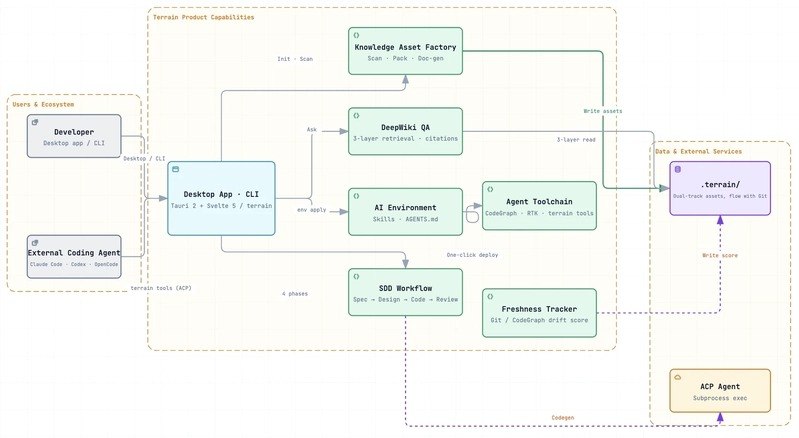
让架构文档随代码自动成长

Terrain 是一款基于 Git 的知识工厂,能自动生成 C4 体系的五层架构文档和 Mermaid 图,保持文档与代码始终同步。
- 增量更新:只扫描自上次 HEAD 变更的文件,秒级刷新,避免全量重建。
- 新鲜度评分:每份文档都有评分,低于 50 时自动降低权重,防止错误建议。
- 双轨输出:人类可读的 .terrain/human/ 目录与 AI 可消费的 .terrain/agent/ 目录共存,支持 C4 视图与结构化概览。
- 四阶段 SDD:从需求到代码审查,每一步都生成可审阅的 Markdown,便于技术负责人追踪与复盘。

适合技术负责人、架构师、团队经理和代码审查员,帮助新人快速上手,减少维护成本。

GitHub

#开发者 #工具 #Terrain #C4 #增量更新 #SDD #GitHub #Mermaid #架构文档 #技术负责人 #架构师 #团队管理 #代码审查员 @频道号
@DevToolboxHub
Post #1718 10
CodeBehind 4.7:安全简化表单数据访问

CodeBehind 4.7 去除了核心中对表单数据的注入结构,开发者不再能直接使用 context.Request.Form。若请求不含表单内容,直接访问会抛错。新版本提供 HasFormContentTypeIfForm 扩展方法,先检查是否有表单内容后再读取,避免错误并减少不必要的处理。示例:

```
if (context.Request.IfForm()["Button"].Has())
Button_Click(context);
```

此改进让 GET 请求等无表单内容的请求不再触发表单相关处理,提升性能并让代码更安全、简洁。适用于所有基于 PageLoad 的控制器逻辑。

#开发者 #工具 #CodeBehind #CSharp #WebDev #Performance
@DevToolboxHub
Post #1717 10
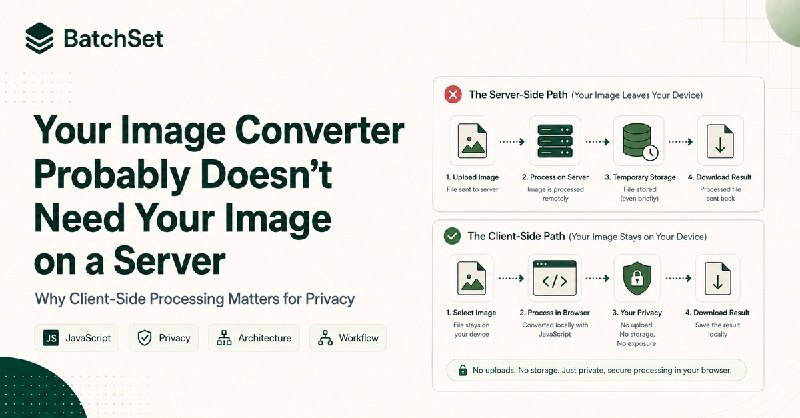
浏览器端图像转换:省去服务器上传

现代浏览器已能本地解码、处理并导出常见图像格式,许多在线工具可完全不上传原图。这样做带来四大优势:
1. 隐私更好:文件不离开设备,减少存储、日志、第三方处理等风险。
2. 上传延迟低:本地处理省去上传‑排队‑下载的等待,尤其对批量文件更友好。
3. 后端成本下降:CPU、存储、带宽压力大幅减轻,适合免费工具。
4. 离线可用:若工具不依赖后端 API,网络差时仍能工作。

实现思路常用 API:FileReadercreateImageBitmap()<canvas>OffscreenCanvasWeb Workers。核心流程是读取文件 → 生成位图 → 在 canvas 上绘制 → toBlob() 导出。
在批量处理时需控制并发,避免一次性解码大量高分辨率图导致浏览器崩溃。可使用队列或有限并发数的 Promise.allSettled

如果文件尺寸过大、需要 AI 模型或跨团队共享,仍建议后端处理。关键是先问:服务器真的需要这张图吗?
- 若答案是“可以在浏览器完成”,则可获得隐私、速度和成本双赢。
- 若答案是“必须后端”,则继续使用传统上传‑处理‑下载流程。

你可以尝试 Image ConverterBulk Image Converter,它们已在 BatchSet 项目中实现了上述架构。


#开发者 #工具 #ClientSideProcessing #ImageConversion #WebDev #Privacy #Performance #BatchSet
@DevToolboxHub
Post #1715 11
Gemini 3.8 Flash:高效推理与编码的最新旗舰

Gemini 3.8 Flash 9月2日上线,保持 $0.75/1M 输入、$3.75/1M 输出的促销价,促销期至 2026‑12‑31。与 3.7 Flash 同价,但模型在复杂任务上会多做推理步骤、迭代调用工具,准确率提升但输出量增大。
核心规格:
- 模型 ID:gemini‑3.8‑flash
- 上下文窗口:1,000,000 tokens
- 输出上限:64,000 tokens
- 输入支持:文本、图像、视频、音频、PDF
- 知识截止:2026‑03(部分领域 2025‑01)
- 工具使用:函数调用、搜索、计算机使用

性能亮点

- 在金融、法律、长视频理解和图表推理等领域,3.8 Flash 超越 Claude Opus 5,得分分别为 61.4%、10.0%、87.8% 等。
- 在终端自动化、计算机使用等长周期任务上,表现落后于 Opus 5。
- 由于更多推理步骤,单次请求的输出 token 可能显著增加,需在预算中预留。

价格与使用
- 促销期:$0.75/1M 输入、$3.75/1M 输出;2027‑01‑01 起双倍。
- 可通过 Google AI Studio、Gemini API、Android Studio、Stitch、Google Antigravity 等渠道调用。
- 仅限 API 付费使用,Google AI Pro/Ultra 订阅者可在 Gemini App 体验。

Gemini 3.8 Flash Cyber
- 仅限 Fairwind Program 参与者(政府、关键基础设施运营商、软件维护者)。
- 重点用于自主漏洞发现,公开测试中 70%+ 的真实漏洞发现率。

使用建议
- 对于高频量化、分类或短摘要任务,建议使用低 effort 级别以降低成本。
- 对同一系统提示或文档多次调用时,开启缓存可显著节省费用。
- 任何 2026‑03 之后的知识需通过搜索工具补充,避免幻觉。

Gemini 3.8 Flash 继续巩固 Flash 系列在高吞吐量场景的地位,同时通过 Cyber 变体开启安全专属产品线。

资源链接
GitHub


#开发者 #工具 #Gemini38Flash #GoogleAI #LLM
@DevToolboxHub
Post #1713 14
AWS 资源隐藏成本:七大常见浪费点

AWS 资源管理便利,却易让账单悄悄攀升。
- 低利用率 EC2:实例曾经需要高 CPU/内存,如今持续低负载。
- 未挂载 EBS:实例终止后,磁盘仍占费。
- 旧 EBS 快照:无保留策略,快照堆积。
- S3 无生命周期:长期存放不常访问的数据,未迁移至低价存储。
- 闲置弹性 IP:实例销毁后,IP 仍占用。
- NAT 网关 & 数据传输:跨 AZ/跨区流量导致额外费用。
- 无限保留 CloudWatch 日志:日志长期存储无意义。

在做任何删改前,先确认资源依赖、用途与所有者。AWS 的 Cost Explorer、Compute Optimizer 等工具可帮助快速定位。

需要完整的 AWS 成本优化清单?
47 条可执行检查,覆盖 EC2、S3、RDS、Lambda 等。
仅 $9,获取链接:


#开发者 #工具 #AWS #成本优化 #云计算 #DevOps #S3 #EC2 #CloudWatch
@DevToolboxHub
Post #1712 14
如何在 JavaScript 中跨主流 LLM 计数 Token

在使用 LLM API 时,Token 计数往往被忽视,导致成本失控。本文提供统一的计数方法,支持 OpenAI、Anthropic、Google、DeepSeek、Llama 等模型,并给出成本计算示例。

OpenAI
OpenAI 已开源 BPE tokenizer,可直接在客户端获取精确 Token 数。
```bash
npm install gpt-tokenizer
```
```js
import { encode } from 'gpt-tokenizer/encoding/cl100k_base';
const tokens = encode('Your system prompt goes here.').length;
console.log(tokens); // 6
```
- gpt-3.5-turbogpt-4gpt-4-turbogpt-4.1 使用 cl100k_base
- gpt-4ogpt-4o-minio1o3 使用 o200k_base
请根据调用的模型选择对应编码,否则计数会偏差。

Anthropic / Google / DeepSeek
这些供应商未公开 JavaScript tokenizer。可选两种方案:
1. 调用计数端点(如 Anthropic 的 /messages/count_tokens),返回精确值,但会产生网络延迟。
2. 字符估算,使用已知字符/Token 比例。
```js
const CHARS_PER_TOKEN = { anthropic: 3.8, google: 4.0, deepseek: 3.5, llama: 3.8 };
function estimateTokens(text, provider) {
const cpt = CHARS_PER_TOKEN[provider] || 3.8;
return Math.max(1, Math.round(text.length / cpt));
}
```
估算值应标记为“估算”,避免误导。

统一计数函数
```js
import { encode as encodeCl100k } from 'gpt-tokenizer/encoding/cl100k_base';
import { encode as encodeO200k } from 'gpt-tokenizer/encoding/o200k_base';

function providerOf(model) { /* 根据模型名返回 provider */ }
function openaiEncoding(model) { /* 返回 'o200k' 或 'cl100k' */ }

export function countTokens(text, model) {
const provider = providerOf(model);
if (provider === 'openai') {
const enc = openaiEncoding(model) === 'o200k' ? encodeO200k : encodeCl100k;
return { count: enc(text).length, mode: 'exact' };
}
const cpt = { anthropic: 3.8, google: 4.0, deepseek: 3.5, llama: 3.8 }[provider] || 3.8;
return { count: Math.max(1, Math.round(text.length / cpt)), mode: 'estimate' };
}
```

Token → 费用
```js
const PRICE = {
'gpt-4o': { in: 2.50, out: 10.00 },
'gpt-4o-mini': { in: 0.15, out: 0.60 },
'claude-3-5-sonnet-latest': { in: 3.00, out: 15.00 },
'gemini-1.5-pro': { in: 1.25, out: 5.00 },
'deepseek-chat': { in: 0.14, out: 0.28 },
};
function costOf(inTokens, outTokens, model) {
const p = PRICE[model];
if (!p) return null;
return (inTokens / 1_000_000) * p.in + (outTokens / 1_000_000) * p.out;
}
```
示例:costOf(1000, 500, 'claude-3-5-sonnet-latest') 约 0.0089 美元。

工具推荐
- 在线计数器:tokensbill.com/tools/token-counter,支持多模型一次性查看月度成本,浏览器内完成,无数据外泄。
- 但建议将计数逻辑集成到自己的代码中,实时监控每次调用成本,避免隐藏高昂费用。

通过在代码中实现精确或估算计数,并结合公开价格表,即可在开发阶段及时发现成本异常,避免类似 $847/日的账单误差。


github.com/your-repo/token-counter

#开发者 #工具 #OpenAI #Anthropic #Google #DeepSeek #Llama #Token计数 #成本管理
@DevToolboxHub
Post #1711 12
HydraFusion:多模型路由实现成本与性能平衡

GitHub 在 Copilot 中推出 HydraFusion,利用多模型路由将编码子任务按复杂度分配给不同 LLM。
- 痛点:单一前沿模型对所有任务收费高昂,导致无论是简单改动还是大规模重构都付费相同。
- 核心能力
• 任务分类器根据 diff 大小、AST 深度、依赖图和用户意图判定任务复杂度。
• 模型注册表将低、中、高三档模型与成本、延迟关联。
• 路由器挑选满足质量阈值的最低成本模型;失败时自动回退到更强模型。
- 效果:在离线评估中,HydraFusion 与单一 Opus 5 模型保持 85% 的任务成功率,平均工作流成本下降 36%($0.50 → $0.32),但重试率略升至 15%。

资源链接
GitHub

hashtag
#开发者 #工具 #HydraFusion #GitHub #Copilot #LLM #多模型路由 #成本优化 #性能平衡
@DevToolboxHub
Post #1710 11
HuddleCluster:仿企鹅自组织的服务器负载均衡

HuddleCluster(v4.15.0)用生物启发的“热量衰减”机制替代传统二元阈值。服务器按“核心‑冷却‑外层”环路自组织:核心环处理高吞吐请求,节点出现延迟或错误时会平滑漂移到外层,减轻负载;恢复后自动回归核心。
其分布式控制平面基于 FastAPI + CLI,支持 Raft 选举、Kubernetes 原生发现、Helm 部署、mTLS 身份验证和 Prometheus 监控。
Python 核心零依赖,几行代码即可启动自组织集群,示例代码已在 GitHub 提供。
详细功能与使用可在交互式模拟网站查看,或直接访问仓库获取源码与安装包。


GitHub
pip install huddle-cluster

#开发者 #工具 #HuddleCluster #Python #FastAPI #Kubernetes #Prometheus
@DevToolboxHub
Post #1708 10
SFINAE 迭代验证:零成本 AI 生成 C++ 检测器

在实验中,使用 MonkeyCode 免费模型生成十个 SFINAE 检测器。通过将编译器错误直接回馈给模型,九个检测器在不到 20 分钟内完成修正,成本仅为零美元。该方法利用编译器的即时诊断,消除了运行时错误的风险。

- 工作流程
1. 生成:模型根据一句描述生成检测器代码。
2. 编译:使用 g++ -std=c++17 -fsyntax-only 编译并执行 static_assert
3. 反馈:将首个编译错误或断言失败信息作为下一个提示输入。
4. 迭代:重复步骤 1–3,直至通过。

- 实验结果
- 8/10 检测器首轮即通过编译。
- 7/10 语义正确。
- 仅 1 个检测器(is_forward_iterator_like)需要人工提示“原始指针是迭代器”,其余通过编译器反馈完成。

- 适用场景
- 小型、明确的模板元编程任务。
- 需要快速验证而非完整库发布。
- 适合在 CI 中快速迭代,避免运行时错误。

- 局限性
- 对公共库的边缘情况(如 volatile、引用限定成员函数)仍需人工校验。
- 需要编译器支持,且每轮迭代必须快速完成。

试试这个循环,最坏只会出现几条编译错误,最好能得到一个你不必亲手写的检测器。


#开发者 #工具 #C++ #SFINAE #MonkeyCode #LLM #编译器验证
@DevToolboxHub
Post #1699 9
Kong AI Gateway 2.0:统一 GKE、Cloud Run 与 Vertex AI 的 AI 流量治理

Kong AI Gateway 2.0 将 AI 原语(模型、提供者、代理、MCP 服务器)视为控制平面实体,解决传统 API 网关无法处理的非线性、代理循环流量。
- Token‑based 限流:按输入/输出 token 量计费,而非单纯请求次数。
- 语义保护:实时检查提示、路由模型并抽象凭证。
- 动态工具治理:在工具发现阶段过滤权限,防止未授权调用。

在 Google Cloud 上,Kong 通过 Kong Kubernetes Operator(KKO)在 GKE 上部署数据平面,并利用 Workload Identity 继承 IAM 角色;Cloud Run 服务被锁定在私有入口,所有请求先通过 Kong 进行鉴权与日志。
- Vertex AI 集成:通过 Workload Identity 直接获取 OAuth 令牌,支持标准与企业端点;可在网关层配置模型回退链(如 Gemini Ultra → Gemini Flash)。
- MCP 服务器聚合:将多工具命名空间合并为统一端点,代理发现时剔除无权限工具。
- 代理间治理:为跨微服务代理通信提供相互认证、执行图追踪与递归限流。

Kong AI Gateway 2.0 为多运行时(GKE、Cloud Run、Vertex AI)提供单一控制平面,统一身份、可观测性与成本治理,帮助企业构建安全、可扩展的 AI‑native 生态。


GitHub

#开发者 #工具 #KongAI #GoogleCloud #VertexAI #GKE #CloudRun
@DevToolboxHub
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →