TGViewer
Channel Public Channel
Datalytics

Datalytics

@datalytx

Канал для аналитиков данных про Python, карьерное развитие в анализе данных, всякое разное

Автор – @ax_makarov

Отдельный канал про ChatGPT и его практическое применение —  @ai_forge

Чат канала — @pydata_chat

Вакансии — @data_hr
Subscribers
8.82K
Photos
255
Videos
15
Links
713

Showing posts older than #1274 · Back to latest

Older Posts 20 shown
Post #1271 2.62K
Яндекс интегрировал VLM в Нейро, значительно улучшив возможности поиска и анализа изображений. На Хабре рассказали, как команда усовершенствовала существующие технологии и создала новый инструмент, делающий работу с визуальным контентом более эффективной.

VLM представляет собой следующий этап в развитии моделей компьютерного зрения. Она не только распознает объекты на картинках, но и отвечает на сложные вопросы о деталях изображений.

Архитектура VLM объединяет LLM, картиночный энкодер и адаптер. Новый пайплайн с VLM-рефразером и VLM-captioner расширил спектр решаемых задач.

В статье подробно описан процесс обучения VLM и проведено сравнение с предыдущим LLM-пайплайном. Разработчики отмечают, что уже сейчас VLM решает многие задачи «из коробки», а с небольшим дообучением достигает высочайшего качества.

Оценить возможности VLM можно в Поиске по картинкам и Умной камере Яндекса.
  • 🤯 6
Post #1270 2.27K
Алгоритмы поиска дубликатов

Ребята из HF Labs выложили отличную статью на Хабре о поиске дубликатов в клиентском MDM. Задача поиска дубликатов — суперкритична для обеспечения качества данных, дубли — потенциальный источник серьезных ошибок в аналитике

Авторы статьи рассказывают о том, как для эффективного поиска дубликатов важно правильно определить подход к обработке данных. Они выделяют несколько ключевых этапов:

1️⃣ Чистка и нормализация данных
2️⃣ Хеширование для быстрого поиска
3️⃣ Применение компараторов и правил
4️⃣ Обновление данных в режиме реального времени

Всё это со своей спецификой про банковскую сферу, но перекладываемо на любые задачи поиска дубликатов (в том числе нечетких)

Глубинное представление о качестве данных, с которыми мы работаем — это прям важный навык для аналитика. Я помню, что почти на любом месте, где я работал сталкивался с тем, что данные всегда содержали кучей дублей и мусора, по разным причинам. В итоге это всё важно отсеивать. Мы же не просто цифры в таблицах анализируем — мы пытаемся через эти данные понять реальность бизнеса, а если у нас Garbage In, то получаем и Garbage Out

https://habr.com/ru/companies/hflabs/articles/847012/
  • 👍 5
  • ❤ 2
Post #1263 2.79K
У Ромы Бунина вышло клёвое видео про дашборды и их жизненный цикл. У дашбордов целом жизнь короткая и Рома в видео рассказывает как продлить их существование, в том числе с помощью ИИ

Ключевой момент в том, что чем больше пользователей у дашборда, тем дольше он живет (капитанский вывод, но всё же это заставляет нас задумать о том как поддерживать постоянную используемость наших дашбордов)

Как продлить жизнь дашборда? Три слова: процессы, процессы и еще раз процессы! 🔄

Как в этом плане уже сейчас может помочь ИИ? Эта помощь в том, что через чат-ботов с LLM можно:
➡️Искать нужные дашборды
➡️Отвечать на вопросы по данным
➡️Писать документацию
➡️Описывать изменения в дашбордах (change-logs)
➡️Помогать с сертификацией (проверкой дэшей на кри)

Но не все так радужно. ИИ пока не может:
➡️Улучшать дизайн дашбордов
➡️Создавать дашборды с нуля по картинке

В общем, внедряйте процессы, считайте время жизни дашбордов и не бойтесь использовать ИИ для рутины. Кто знает, может скоро мы будем просто рисовать дашборды от руки, а ИИ будет их создавать? 🎨🤔

Кстати, у Ромы есть ещё видео в мини-сериале про дашборды, ссылки тут
  • 👍 5
  • 🔥 3
Post #1260 2.85K

Forwarded from Yandex DataLens

🚀Новый конструктор отчётов!

Теперь можно собирать многостраничные документы нужного формата (размер, ориентация) для pixel-perfect экспорта в pdf или печати. Удобно для регулярных встреч с командой или отправки клиентам.

Ключевое:
- Функциональность доступна только в Business тарифе.
- Отчёт – это ещё один тип объекта внутри воркбука.
- Отчёт состоит из страниц, на каждую из которых можно добавлять чарты, картинки, текст.
- Можно работать со слоями.
- Можно копировать виджеты с дашбордов. Это удобно, если нужно быстро собрать печатную версию дашборда.

Что в планах:
- Конвертация дашбордов в многостраничные отчёты.
- Поддержка селекторов (глобальных на весь документ, на группу, на отдельные страницы).
- Простая вставка изображений из буфера с загрузкой.
- Режим просмотра/презентации.

Подробности читайте в документации.
  • 🔥 5
Post #1258 2.57K
Прочитал отличный совет Тани Мисютиной у Горбунова про важность выделения минимальной частицы данных

Мне нравится та элегантность, которая лежит в основе подходов к архитектуре данных — каждый элемент находится на своем месте, образуя целостную и функциональную структуру. Есть в этом своего рода архитектурная красота

Таня в своём посте пишет о том, что для эффективного анализа данных важно правильно определить «частицу данных» — единицу смысла в конкретной задаче аналитика. Эта частица выступает связующим звеном между различными сущностями в описываемой реальности. Важный момент — даже если исходный датасет не содержит данные на уровне выбранной частицы, понимание этой единицы смысла помогает лучше понять как сделать визуализацию или создать дашборд

В целом, я бы сказал, что умение понимать подходы к описанию реальности — критически важный навык для аналитиков данных, продуктовых аналитиков, инженеров данных и data scientists

Почему так?

1) Формирование правильной онтологии (описания реальности) позволяет аналитику лучше понимать суть явлений, которые он анализирует. Это в свою очередь влияет на то какие вопросы задает аналитик по отношению к этой самой реальности, к стейкхолдерам, а также к датасету. Всё это влияет на качество гипотез, которые ставит аналитик, а также на интерпретацию данных и полученных выводов

2) Выходит из пункта 1, но больше связано с коммуникацией и постановкой задач. Если аналитик хорошо умеет «разложить» онтологию, то качество поставленной задачи к другим контрагентам (будь то data engineers, QA, разработчики, продакт-менеджеры) сильно вырастает

Если вы хотите глубже разобраться в том как вообще работать с сущностями и научиться лучше описывать реальность на языке данных — подписывайтесь на канал Тани @datalaboratory
  • 👍 5
  • ❤ 2
Post #1254 2.7K
Яндекс переработал и улучшил существующие функции для работы с текстом на базе YandexGPT в Яндекс Браузере, что привело к созданию отдельного инструмента. На Хабре рассказали, как можно дотюнить готовые фичи и сделать что-то новое, что сделает работу пользователей ещё более комфортной.

Инструмент включает возможность создания и редактирования текста. Обычно такие функции требовали сторонних приложений, но теперь они встроены прямо в браузер.

Для оценки работы модели Яндекс использовал диффалку на Go, которая находит наидлиннейшие общие подпоследовательности (LCS). Это позволило эффективно анализировать разницу между версиями текста и ускорить проверку изменений.

Переход на архитектуру Encoder-Decoder сократил время генерации текста вдвое, а curriculum learning позволил модели улучшать качество обработки текстов на 10% за счёт последовательного обучения на примерах разной сложности. Ещё одно важное нововведение — поддержка Маркдауна, что особенно полезно для тех, кто работает с разметкой текста.
  • ❤ 5
Post #1247 2.21K
Я провожу исследование, посвященное жизни людей, работающих в найме. Центральная тема — разделение личной и рабочей сфер в современном обществе.

Одна из гипотез моего исследования заключается в том, что это разделение ведёт к фрагментации личности и создаёт искусственные границы между тем, что считается «настоящей жизнью», и тем, что таковым не является.

В частности, аналитики данных часто разрабатывают инструменты и идеи, которые приносят прибыль владельцам компании, но не самим аналитикам. Это пример классического отчуждения от результатов собственного труда. Меня интересует, как можно выработать стратегии, помогающие преодолеть это чувство отчуждения.

Задачи в компаниях часто строго регламентированы, и аналитикам бывает трудно противостоять «бездумному» следованию инструкциям, даже когда они предлагают рациональные улучшения. Особенно это ощущается, когда давят сроки или давление исходит от коллег. Мне важно понять, как можно выстроить личные границы и целеполагание так, чтобы они работали как на тебя самого, так и на общее благо.

Для кого-то работа аналитиком — это способ самореализации: обучение других, создание новых методов, взаимодействие с заказчиками. Для других это лишь средство заработка, и они реализуют себя только в свободное время. В этом нет ничего плохого, но важно находить способы сохранять баланс, чтобы работа не вызывала отторжения.

Я хочу исследовать все эти вопросы, чтобы лучше понять, как выстраивать стратегии, позволяющие воспринимать работу как гармоничную часть жизни, а не как нечто чуждое и ограничивающее. Только так, на мой взгляд, можно создать по-настоящему развивающую среду.

Если вы хотите принять участие в исследовании и у вас есть время на часовой созвон, оставляйте свою заявку.
  • 🔥 9
Post #1243 2.44K

Forwarded from Рекомендательная [RecSys Channel]

Кластерная якорная регуляризация в рекомендательных системах
Обучение на логах юзеров может приводить к popularity bias. Мы рекомендуем айтемы, человек их смотрит, это попадает в логи и оттуда — в дальнейшее обучение. В итоге «богатый становится богаче». Известные способы борьбы с этим ухудшают перфоманс популярных айтемов, что тоже плохо. Ресёрчеры из DeepMind предлагают свой метод, Cluster Anchor Regularization, и применяют его для YouTube Shorts.

Иерархическая кластеризация
Индекс делится на кластеры, затем каждый из них кластеризуют снова — так мы получаем следующие уровни. Для каждого кластера учим эмбеддинг, чтобы приблизить к нему tail-айтемы того же кластера.

Кластеры генерируют энкодером с учётом метаданных и контента. 2-миллиардный индекс мапится в 256-размерные эмбеддинги. Они фиксированы, считаются один раз и нужны лишь для построения графа, который и будет кластеризоваться. Об архитектуре энкодера авторы не пишут.

Ноды графа — айтемы, а рёбра отражают косинусную близость между ними. Граф разбивается на кластеры так, что рёбра, выходящие из одного кластера и приходящие в другой, получают меньший вес. Каждой ноде сопоставляют вес, равный √ числа взаимодействий с айтемом. После 4 уровней кластеризации получается 48 000 кластеров. В каждом из них внутри одного уровня примерно одинаковое число взаимодействий.

Якорная регуляризация
Внутри кластеров есть source- и target-айтемы. В нашем случае source — популярные айтемы, а target — непопулярные. Каждому айтему сопоставляем его обучаемый эмбеддинг, а каждому кластеру — эмбеддинг такой же размерности. На первом этапе source-айтемы мапятся в свои кластеры, а представления кластеров обучают так, что градиент просачивается в них, не изменяя source-векторы.

На втором этапе то же самое происходит с target-айтемами, но обновляется уже не представление кластера, а векторы target’ов. Результаты обоих этапов добавляем в основной loss. Благодаря этому получается «эффект якоря»: популярные айтемы «тянут» за собой непопулярные.

@RecSysChannel
Разбор подготовил ❣ Сергей Макеев
  • 🔥 5
Post #1231 2.8K
Компания Anthropic опубликовала системные промпты для своей языковой модели Claude 3.5. Это значимое событие для всех, кто интересуется разработкой чат-ботов и prompt engineering.

Системный промпт - это набор инструкций, которые определяют базовое поведение и личность AI-ассистента. Обычно эта информация не раскрывается разработчиками и считается коммерческой тайной.

Однако Anthropic решили пойти на беспрецедентный шаг и поделиться промптами своей модели. Это дает нам возможность изучить принципы работы одного из самых продвинутых чат-ботов на рынке.

Знакомство с промптами Claude 3.5 может быть полезно для всех, кто занимается или планирует заниматься созданием собственных AI-ассистентов. Это возможность перенять опыт ведущих специалистов в области и усовершенствовать свои навыки prompt engineering.

Конечно, нужно понимать, что каждый проект уникален и требует индивидуального подхода. Но изучение промптов Claude 3.5 может дать ценные инсайты и вдохновение для собственных экспериментов и разработок.

Так что если вы хотите быть в курсе последних трендов в мире чат-ботов и AI-ассистентов, рекомендую ознакомиться с опубликованными промптами. Это может стать полезным ресурсом для вашего профессионального развития в этой перспективной области.

https://docs.anthropic.com/en/release-notes/system-prompts#july-12th-2024

#Anthropic #Claude #PromptEngineering #ChatbotDevelopment #AIAssistants
  • 🔥 8
Post #1230 2.73K
У Яндекс Погоды новая технология — OmniCast. Она умеет точно прогнозировать температуру в конкретном квартале города.

В связи с нововведением частота обновления прогноза выросла в 36 раз: теперь он обновляется не раз в 3 часа, а каждые пять минут. Как создавали такую нейросетевую модель — подробно расписали разработчики на Хабре. Но можно немного приоткрыть тайну: помимо профессиональных метеостанций сервис стал учитывать и любительские.

Кстати, Яндекс Погода призывает пользователей и организации, у которых есть метеостанции, подключаться к сервису с помощью API.
  • 🔥 10
  • 👍 2
Post #1229 2.44K
Суперкомпьютеры тоже ломаются. Вернее, проблема может возникнуть в одной из их составляющих.

В случае, которым поделились ML-специалисты Яндекса, необычная поломка произошла у вентиляторов, которые охлаждают видеокарты.

Спустя два года работы в дата-центре во Владимире вентиляторы стали выходить из строя и буквально разлетаться на куски один за другим. Получался своего рода эффект шрапнели.

Компанда начала разбираться в причинах неисправности и выяснила, что проблема была в качестве пластика. О том, как в итоге ее удалось устранить, рассказали в посте.
Telegram ML Underhood Вентиляторные шрапнели в суперкомпьютерах В дата-центрах Яндекса есть собственная система стоек, где на одной плате установлено сразу несколько видеокарт, к которым подключены сервера. На этой технологии работает, например, суперкомпьютер «Галушкин». Для…
  • ❤ 1
Post #1228 2.13K

Forwarded from Пристанище Дата Сайентиста (TelepostBot)

​​Модель ИИ для борьбы с онлайн-токсичностью

Решил поделиться результатами своей работы в стартапе.

А занимался я разработкой моделей для модерации контента, направленной на искоренение онлайн-токсичности и создание активных онлайн-сообществ.

Основной целью было разработка модели с высоким перфомансом и минимальным вычислительным затратам и чрезвычайно низкой задержкой.

У нас получилось достигнуть F1-оценку почти 0.96 и AUPRC выше 0.98, при среднем времени оценки контента менее 40 миллисекунд.

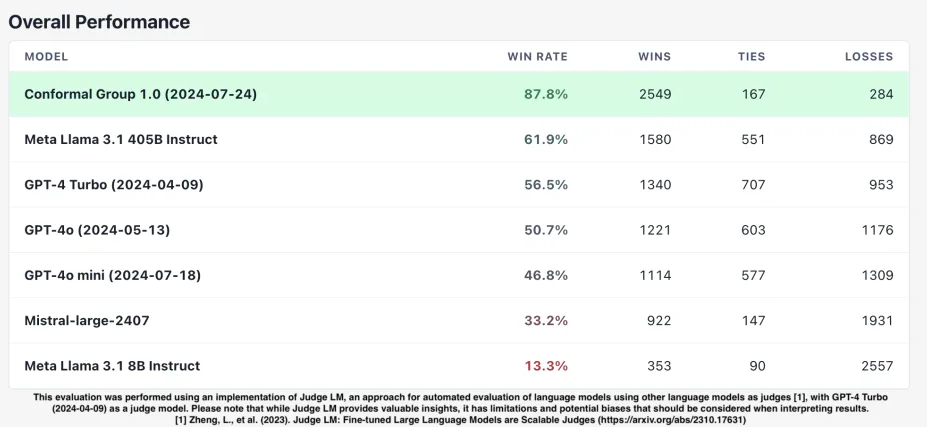
Модель также превзошла ведущие ИИ-модели во время независимой оценки, проведенной компанией OpenPipe, лидером в области доработки и оценки доработанных моделей. (можно увидеть на скрине)

Полный текст анонса

А у меня теперь новый карьерный этап, но об этом чуть позже
  • ❤ 2
  • 👎 2
  • 👍 1
Post #1227 2.32K

Forwarded from Душный NLP

Mixture-of-Agents — простой способ улучшения ответов LLM

Сегодня рассмотрим статью, которая описывает метод улучшения результатов LLM на разных бенчмарках без дообучения. Он называется Mixture-of-Agents (MoA).

Суть метода заключается в использовании нескольких LLM для генерации ответов. Авторы статьи создали многослойную структуру с несколькими агентами — собственно, моделями — на каждом слое. На вход подавали один вопрос. Каждый из агентов давал ответ. Затем полученные данные агрегировались и вместе с промптом передавались на следующий слой, где процесс запускался заново.

В итоге получался ответ, который превосходит по качеству все предыдущие. Интересно то, что модели показывают лучшие результаты, когда имеют доступ к выходным данным других LLM — даже если ответы последних не слишком качественные. Этот феномен авторы назвали «коллаборативностью LLM» (Сollaborativeness of LLMs).

Эксперименты показали, что использование разных LLM на разных слоях улучшает результаты. Агрегаторы тоже играют важную роль — если пропоузеры могут быть относительно простыми и легкими, то агрегаторы требуют значительных вычислительных ресурсов.

Бенчмарки подтвердили, что MoA — эффективный метод. Скажем, на AlpacaEval 2.0 и MT-Bench применение такой архитектуры дало прирост производительности до 8% по сравнению с GPT-4 Omni.

Впрочем, MoA есть куда расти. Например, в области уменьшения времени до первого токена. Из-за итеративной агрегации конечному пользователю приходится долго ждать ответа на вопрос. Авторы статьи намерены бороться с этим недостатком.

Рассказывайте в комментариях, что думаете о MoA?

Разбор подготовил ❣ Никита Шевченко

Душный NLP
  • 👍 1
Post #1217 2.86K

Forwarded from Блуждающий нерв

Пузырь генеративного ИИ начал лопаться, считает Маркус. Он упрекает обучателей крупнейших нейросеток в том, что у них нет внятной бизнес-модели, которая окупила бы гигантские затраты этого сектора. Вложены уже сотни млрд. $, а главный вопрос надежности/галлюцинаций так и не решен, что резко ограничивает применимость технологии.

Он и не будет решен, т.к. это неотъемлемое свойство GenAI, настаивает Маркус.

В целом он твердит об этом давно, но теперь предрекает крах уже в этом году: “Пользователи потеряли веру, клиенты потеряли веру, венчурные инвесторы потеряли веру”. Возможно, его сподвиг недавний отчет Goldman Sachs “Gen AI: too much spend, too little benefit?”, где проводится та же мысль, более мягкими словами (см. также разбор отчета).

Несмотря на ряд успехов GenAI, например, в генеративной (био)химии, можно видеть, как тускнеют ожидания и как меняется тон комментариев, не только у Маркуса. Все наигрались в генерацию картинок/текстов и хотят, наконец, использовать ИИ в реальных задачах. Но этот переход не дается — в силу самой природы GenAI. Ключевой изъян в том, что GenAI беззащитен перед т.н. “выбросами”. Если на входе паттерн, сильно отличный от паттернов в обучающей выборке, на ответ нельзя положиться. Такой ИИ не понимает и не мыслит, он создает новые данные по шаблону старых.

Масштабирование не избавит от проблем (см. “AI scaling myths”). Метрики, где ИИ превосходит людей в решении задач, не измеряют интеллект/мышление, а превосходство может быть хрупким. Синтетические данные — не панацея от дефицита данных для обучения, такой маневр быстро ведет к коллапсу, т.к. каждая следующая модель учится не на реальности, а на предсказании реальности предыдущей моделью, и даже малые ошибки итеративно усиливаются.

Я бы не использовал слово “пузырь”. GenAI очень интересный инструмент, со временем мы поймем, как сделать его не просто удивляющим, но и полезным. Но отрезвление ожиданий — хороший признак.
Substack Why the collapse of the Generative AI bubble may be imminent An update from the person who first called the bubble
  • 👍 12
Post #1213 3.93K
​Наткнулся тут на интересную статью 2009 года, где автор высказывает мнение о том, что изобретение VisiCalc (первого приложения электронных таблиц) необратимо изменило мир и то как принимаются решения

Основная мысль состоит в том, что электронные таблицы демократизировали процесс «что-если» (what-if) анализа. Во-первых, до электронных таблиц было меньше аналитиков. Во-вторых, раньше этим аналитикам было сложнее оперировать большим количеством переменных. Никто не просил от каких-нибудь финансистов разработать 20 вариантов расчетов с разными входными данными, потому что в головах менеджеров не было такой парадигмы как «хочу чтобы мне смоделировали все варианты». Не могу подтвердить или опровергнуть что это так. Думаю, что менеджеры всегда принимали решения на основе подсчетов, вопрос точности этих подсчетов, гранулярности данных, а также возможности принимать в расчет вариантивность и вероятностную природу многих переменных. Почитайте, например, про модель EOQ (Economic order quantity), которую еще при Форде использовали для расчета экономики предприятия. Проблема в том, что экономика усложнялась и примитивная EOQ уже не подходила

В общем, спредшиты настолько демократизировали процесс работы с данными, который ранее был доступен только статистикам и ученым, что каждый менеджер начал все считать и моделировать. И начал простить считать и моделировать своих подчиненных. И вот тут то и появилась парадигма «принеси мне метрики». Что в итоге привело к буму «количественного менеджмента», ну и дальше трансформировалось в data-driven и в наукообразное «рост бизнеса как набора гипотез»

Я не буду тут распинаться про то, что даже в нашу data-driven эпоху с ее верой в «объективность данных» очень многое зависит от человеческого фактора, в том числе от качества интерпретации и выводов, которые строятся на основе данных. Мне интереснее другое

В статье приводится пример с переносом завода – мол, факторный анализ позволил оценить что дешевле производить товар в другом регионе, а потеря качества не повлияет на конечную прибыль. Но как мне кажется, тут вопрос ответственности людей, которые принимают решения о переносе, а не технологии, благодаря которой стал возможен «оптимальный расчет»

И все тут лежит скорее в части логики современного общества, из-за которой мы все больше и больше нуждаемся в предиктивной аналитике. И есть у меня подозрение что именно благодаря этой логике мы видим бум AI и влажные фантазии вокруг того, что AI революционизирует бизнес. А по факту сделаем очередной Excel
  • ❤ 8
  • 👍 7
Post #1189 2.46K
Многие спрашивают на консультациях: зачем аналитику развивать продуктовое мышление?

Нанимающие менеджеры ищут аналитиков, способных уточнять задачи через продуктовое мышление. Поэтому, чтобы оставаться востребованным специалистом, аналитику нужен рост «вширь», и развитие продуктового мышления пойдет ему только в плюс

Такое мышление помогает анализировать деятельность с точки зрения пользы для продукта в целом.🔎 Аналитик здесь может увидеть и подсветить важные точки развития продукта через призму своих компетенций и «приближенности» к raw data

Аналитик помогает сгенерировать и приоритизировать гипотезы, оценить потенциал фич и измерить результаты экспериментов 🧮

Аналитик может помочь с определением вектора развития продукта и говорить на языке бизнес-импакта 📈. Когда аналитик говорит: «Эта фича может принести Х миллионов дохода», это резонирует с бизнесом намного больше, чем технические детали. А ещё аналитик может подсветить какие-то тонкие моменты для реализации фичи или проверки гипотезы, чтобы сделать ее успешной или более быстро валидируемой 💸

Со временем у такого специалиста формируется интуиция, что может «выстрелить», а что нет. Поэтому продуктовое мышление делает аналитика полноценным бизнес-партнером и ценным советником для продакт-менеджеров и CPO 🤝

Продуктовое мышление аналитика является инструментом оптимизации дорожной карты развития продукта и влияет на формирование стратегии 📊

Я считаю, что эти навыки делают аналитика более влиятельным в рамках компании и в дальнейшем помогут ему расти и в зоне ответственности, и в зарплате
  • 👍 7
  • 🔥 2
  • ❤ 1
Post #1186 2.4K
#статья: Как сделать А/B-тест в офлайне, на примере ускорения доставки в Самокате.

В офлайне существуют особенности и ограничения для продуктовой аналитики.
Как же провести А/B-тест в физическом мире? Продуктовый аналитик Илья Лоладзе в своей статье поделится, как с этим попыталась справиться его команда из samokat.tech.

Автор расскажет:

- С какими особенностями и ограничениями может столкнуться продуктовый аналитик в офлайне.
- Стоит ли рассчитывать на интуицию в поисках главной метрики в таком нетипичном эксперименте.
⁃ К каким издержкам нужно быть готовым, учитывая человеческий фактор / Какие подводные камни ожидают продуктовую аналитику в ходе работы офлайн.

Данная статья будет интересна всем продуктовым аналитикам, которые хотят узнать больше о работе с А/В тестами офлайн. А также тем, кто любит эксперименты, внося небольшие изменения в привычный процесс.

https://habr.com/ru/companies/samokat_tech/articles/821777/
  • 🔥 6
  • ❤ 1
Post #1183 2.34K

Forwarded from AI Forge – про ИИ в бизнесе (Алексей Макаров)

Тем временем Anthropic зарелизили Claude 3.5 Sonnet и цифры по математическому бенчмарку GSM8K переваливают за 95%

Надо признать, что GSM8K не только проверяет способность модели выдавать правильный ответ на задачку, но и ее способность правильно решать эту задачу

Вот кстати интересная статья про то как SurgeAI помогали OpenAI в создании бенчмарка GSM8K – https://www.surgehq.ai//blog/how-we-built-it-openais-gsm8k-dataset-of-8500-math-problems
  • 🔥 4
Post #1181 2.29K
Opportunity sizing — способ управлять развитием продукта через бизнес-ориентированное мышление

Если коротко и по-простому, opportunity sizing – это количественная оценка гипотезы/фичи/продукта с точки зрения влияния на бизнес (будь то выручка, EBITDA, объем продаж или объем потенциальных рынков сбыта). Вот пришел к вам продакт и говорит, что гипотеза пушка-бомба и надо дизайнить эксперимент, opportunity sizing позволяет оценить потенциальный финансовый эффект от этой гипотезы, затраты на проектирование эксперимента для тестирования гипотезы, а также определить место этой гипотезы среди других гипотез

Подход opportunity sizing позволяет лучше отприоритизировать усилия, оценить потенциал идей, перевести инсайты и идеи на язык бизнес-импакта, что точно увеличит вашу договороспособность со стейхлодерами

В общем, полезный инструмент в арсенале аналитика. Подробнее про opportunity sizing можно почитать в статьях:
🔗Shopify Data’s Guide To Opportunity Sizing
🔗Intro to Opportunity Sizing (by Giovanni Fernandez-Kincade)
  • 🔥 4
  • 👍 3
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →