TGViewer
Channel Public Channel
дата-журналистика и котики

дата-журналистика и котики

@data_reporter

Детективные истории на основе данных: компании-призраки, ошибки в статистике, ИИ на службе журналиста. Рассказываю, что под капотом — и как повторить.

Анастасия Целых, дата-журналистка RTVI, лауреат премии «Редколлегия»
Связь: @anntss
Subscribers
118
Photos
31
Videos
1
Links
46
Recent Posts 20 shown
Post #81 71
🦾 Как копаться в судебных решениях прямо через нейросеть

Ещё один инструмент для OSINT, про который мало кто знает. Free Law Project сделал коннектор CourtListener: он цепляется к Claude или ChatGPT и пускает в миллионы судебных дел США — решения, материалы, слушания, профили судей.

Скажем, надо копнуть свежие показания Илона Маска — кидаешь запрос, и модель вытаскивает материалы дела. Причём отдаёт первичку, а не пересказ, так что выдуманных дел, как это бывает у нейросетей, тут не будет.

Что делаем:

🐱 Заводим бесплатный аккаунт на courtlistener.com.
🐱 Включаем коннектор прямо в настройках нейронки.
🐱 Кидаем запрос вроде: «прочитай статью по ссылке, найди упомянутое дело и покажи подробности и связанные дела».
🐱 Из каждого дела вытаскиваем зацепки — имена, компании, связанные процессы. Это новые ниточки для дальнейшего поиска.

Ну и пара оговорок. База только по судам США — для наших не сработает. И при запросе к модели видно только то, что она решила показать: для OSINT это опасно, пропущенное дело = пропущенная зацепка. Так что лучше дублировать ручками.
CourtListener Create alerts, search for and browse the latest case law, PACER documents, judges, and oral arguments. Updated automatically with the latest court documents. An initiative of Free Law Project.
  • 👍 1
Post #80 71
🐱 ИИ помечает тексты невидимыми знаками. Как это работает

Google помечает тексты с 2024-го, теперь это делают и новые модели Claude. Даже если текст написали сами, а потом попросили вычитать или перевести — он тоже получит метку.

🐱 Где прячется «водяной знак»
Метка ИИ живёт буквально между строк. На каждом шаге модель берёт одно из нескольких одинаково подходящих слов — а секретный ключ незаметно подталкивает её к «своим». Смысл фразы не меняется, но помеченный текст статистически чаще попадает на нужные слова.

🐱 Проверить может тот, у кого ключ
Сторонний «детектор ИИ» такой знак не увидит — для проверки нужен ключ разработчика. А популярные детекторы часто гадают по стилю. Недавно, например, один такой записал отрывок из «Франкенштейна» в «100% продукт ИИ».

🐱 Что с этим делать
Парадоксально, но в выигрыше те, кто не скрывает использование ИИ. В этом году сразу восемь пулитцеровских лауреатов сами рассказали, как применяли ИИ: один переводил дневник, другой прогонял через модель миллион документов. Другой выход — кардинально ломать логику повествования, порядок строк и слов. Но есть ли тогда смысл в использовании ИИ?
declaude How AI text watermarking works A gentle visual guide to how a statistical mark hides inside generated text, and what erases it.
  • 👍 3
Post #79 97
11 миллиардов компаниям-призракам: расследование, которое началось с двух баз

Международная премия Sigma Awards назвала лучшие дата-расследования года. Один из победителей — «Призраки казны» мексиканской команды Quinto Elemento Lab. Разбираю метод, потому что он ровно про то, что меня драйвит в дата-журналистике.

🐱 Что они сделали
Взяли две открытые базы: госконтракты страны за 20 лет и официальный список фирм-однодневок от налоговой. И скрестили их между собой. На пересечении — компании-призраки, которые не имели ни ресурсов, ни сотрудников, но получали бюджетные деньги.

🐱 Что нашли
За четыре президентских срока фантомам ушло 11,5 млрд песо (около 660 млн долларов) — примерно 1,5 млн песо госсредств каждый день на протяжении 20 лет. Почти половина всей суммы — всего у десяти компаний.

🐱 Почему это красивый метод
По отдельности обе базы публичны и выглядят безобидно: вот контракты, вот список сомнительных фирм. Всё интересное — в пересечении. Сопоставить сотни тысяч записей вручную нереально, поэтому мексиканцы связали базы с помощью кода на языке R.

🐱 А что нам с этого
С российскими реестрами тоже так можно. Помните мой разбор рыбозавода из Ногинска, «заработавшего» четверть ВВП, или фантомной компании «Банкнота», которая обошла по прибыли «Газпром»? Тот же принцип: берёшь официальные данные, ищешь аномалию, идёшь проверять.

Мексиканцы сделали это в большем масштабе и на автоматизации — и это ровно тот навык, который мне сейчас супер интересен: скрещивать большие базы с помощью кода и нейронок. Подробнее про методику этого расследования можно прочитать здесь.
Quinto Elemento Lab Fantasmas del Erario: Cuatro sexenios de destinar recursos públicos a empresas inexistentes En los últimos 20 años, el gobierno mexicano entregó más de 11 mil millones de pesos a más de 800 empresas fantasma
  • ❤ 3
  • 🔥 3
  • 🍾 1
Post #78 125
Как рыбозавод из Ногинска «заработал» четверть ВВП России

Я периодически смотрю отраслевые рейтинги у Спарка и Rusprofile — просто чтобы держать руку на пульсе. На этой неделе наткнулась на компанию «Русское Море» с ростом выручки на 114 424%. Решила разобраться.

🐱 Что показывали цифры

По данным ФНС, в 2025 году подмосковный рыбозавод показал выручку 52 трлн рублей — это около четверти ВВП России. Больше чем у «Газпрома» и «Роснефти». Те же цифры подтянулись в СПАРК и Rusprofile.

🐱 Как я это проверяла

Сначала подумала что ошибка на стороне коммерческих баз — бывает. Но решила проверить первоисточник. У ФНС есть бесплатный портал бухотчётности с красивыми дашбордами — ГИР БО. Там те же триллионы.

Но вот что интересно: если скачать выгрузку данных с того же портала — там не триллионы, а миллиарды. Ошибка живёт именно в визуализации, а не в самих данных. То есть исходные цифры правильные, но где-то между базой и дашбордом что-то пошло не так с единицами измерения.

🐱 Почему это важно

Коммерческие системы проверки контрагентов берут данные из ГИР БО и не всегда перепроверяют аномалии. Компании используют эти системы для скоринга партнёров, выдачи кредитов, оценки рисков. Слепое доверие к цифрам из базы может дорого стоить.

🐱 Главный вывод

Аномальный рост в сотни тысяч процентов — это всегда сигнал. Не обязательно мошенничество, иногда просто ошибка. Но проверять надо в любом случае — и желательно до первоисточника, а не останавливаться на коммерческой базе.

Полный разбор — на RTVI.
RTVI Рыбозавод из Ногинска «заработал» четверть ВВП России: как так вышло? Из-за сбоя ФНС подмосковный производитель рыбы «Русское Море» случайно обошел по выручке «Газпром», показав в базах 52 трлн рублей. RTVI разобрался, как техническая ошибка в единицах измерения превратила компанию в фантомного триллионера и почему слепой скоринг…
  • ❤ 4
  • 🔥 4
  • 🦄 1
Post #77 195
Как Google убивает исследовательский поиск — и как с этим жить

Хенк ван Эсс — журналист которого я уже упоминала в посте про утечки ChatGPT — написал важный текст про то, как новый ИИ-поиск Google меняет работу исследователя. Коротко: не в нашу пользу.

🐱 Что изменилось

Раньше Google показывал индекс — сотни ссылок, сам решаешь что смотреть. Теперь ИИ читает веб за тебя и выдаёт вердикт. Источники всё ещё есть — в панели справа — но алгоритм уже решил сколько их нужно и какие важны. По данным Pew, 99% пользователей никогда не открывают эти источники чтобы проверить.

Плюс есть проблема с качеством пула: исследование для ACM Web Conference 2026 показало, что когда 67% контента в поиске сгенерировано ИИ, больше 80% того что система выдаёт — синтетика. При этом ответы выглядят вполне нормальными.

🐱 Почему это проблема именно для журналистов

Чаще всего самое полезное — то, что алгоритм задвигает вниз. ИИ-слой мешает искать и находить такие инсайты.

🐱 Главный лайфхак

Добавь &udm=14 в конец любого URL результатов Google — и получишь классические десять синих ссылок без ИИ-панелей, каруселей и Overview. Есть и более быстрый вариант — добавить -ai в конец запроса. Работает не всегда, но в моменте удобно.

🐱 Что это значит для работы с данными

Операторы — site:, filetype:, intitle:, after: — теперь важнее чем когда-либо. Они превращают Google обратно в поисковик, которым мы привыкли пользоваться
www.digitaldigging.org So you still think you can Google? You can refuse to be spoon-fed by Googles new AI search. Here's the toolkit.
  • 👍 2
  • ❤ 1
  • 🤔 1
  • 🍌 1
Post #76 152
Как Sky News поймал X на политической предвзятости — и что под капотом

Журналисты Sky News задались вопросом: правда ли, что алгоритм X при Маске продвигает правый контент? Проверить это сложно — платформа не раскрывает, как работает лента. Поэтому они придумали эксперимент.

🐱 Что сделали

Создали девять фейковых аккаунтов, имитирующих британских пользователей с разными политическими взглядами — левыми, правыми и нейтральными. Две недели собирали посты из ленты «Для вас» каждого аккаунта. Итог: датасет из 90 000 постов от 22 000 аккаунтов.

🐱 Как классифицировали политические взгляды

Вручную разметить 22 000 аккаунтов нереально. Поэтому обучили кастомную языковую модель — натренировали её на размеченной выборке и дали классифицировать остальное. Потом проверили точность вручную.

🐱 Что получилось

Нейтральные пользователи видели вдвое больше правого контента, чем левого. Причём это не зависело от того, на кого они подписывались — алгоритм давил правый контент независимо от интересов аккаунта.

🐱 Почему методология интересна

Обычно медиаисследования анализируют уже существующие данные. Sky News сделали иначе — поставили контролируемый эксперимент с нуля, как в науке. Это дороже и сложнее, зато позволяет убрать лишние переменные.

🐱 Но есть нюансы

Ф
ейковый аккаунт — не идеальная «чистая» переменная. Современные платформы собирают данные далеко за пределами самого X: браузерные куки, устройство, IP, поведение в других сервисах. Аккаунт, созданный с реального устройства, теоретически уже несёт чужой цифровой отпечаток — и это могло влиять на выдачу.

Две недели — короткий период, и он пришёлся на ноябрь 2025 года. В Британии это время активных политических дискуссий — результаты вполне могли быть другими в спокойный период. И наконец, девять аккаунтов — выборка скромная: достаточная для журналистского расследования, но не для научного вывода.

Подробнее о методологии — вот тут. Как думаете, реально ли сделать похожее с алгоритмами ВКонтакте?
Sky News How Sky News investigated X's algorithm for political bias In recent months, X has become a focus of political conversation in the UK, with social media experts and politicians saying Elon Musk's platform is sowing political division across the country.
  • 😱 4
  • ❤ 1
Post #75 134
Пройти наш путь еще раз можно по вот этой шпаргалке (нужен аккаунт на Github).

- Чтобы зайти в Codespaces — жмем на зелененькую Use this template
- Выбираем пункт Open in Codespace
- Когда облачная среда подгрузится пишем в терминале codex или codex login --device-auth
- Выбираем пункт "авторизоваться с помощью кода"
- Получаем тот самый код в своем ChatGPT (сработает, если есть платная версия)
- Вызываем Codex через терминал (команда codex)
- И дальше в терминале общаемся с нейронкой на русском, пишем промты и вот это вот всё.

Спасибо всем, кто пришел!
GitHub GitHub - antselykh/datajournalism-codex-workshop: Workshop template for data journalists using OpenAI Codex in GitHub Codespaces Workshop template for data journalists using OpenAI Codex in GitHub Codespaces - antselykh/datajournalism-codex-workshop
  • ❤‍🔥 3
  • 🫡 2
Post #74 115
Post #73 133
Друзья, привет!

У меня тут намечается стрим, на который я хочу вас позвать. Обещаю: будет полезно и без вот этого вот менторского «смотрите, как правильно».

Тема: Как находить инсайты в данных с помощью ИИ

Я сама помню то чувство, когда открываешь датасет, а он на тебя смотрит тысячью ячеек и говорит: «Ну, ищи теперь историю, журналист». И ты сидишь такой в ночи, и pandas вызывает не исследовательский азарт, а желание всё закрыть, попить чаю и пойти спать.

Так вот, 22 апреля в 20:00 я покажу, как подступиться к данным, если непонятно, что искать. Вживую на примере реального датасета.

Разберем:
— Как ИИ меняет нашу работу с цифрами и таблицами.
— Что спрашивать у нейронки, чтобы она подкинула идею для материала, а не воду лила.
— Как вытаскивать из данных аномалии и неожиданные углы, которые могут лечь в основу классной истории.

Ставьте напоминалку на 22 апреля, 20:00 мск. Ссылка на регистрацию лежит вот тут. Приходите, будет душевно. Обсудим и поймем, что данные — это не страшно.
  • ❤‍🔥 10
  • 🔥 7
  • 🫡 3
Post #72 146
Ещё один полезный инструмент для быстрого анализа данных прямо в браузере

Когда работаешь с данными — расследования, OSINT, дата-журналистика — часто сталкиваешься с ситуацией, когда нужно быстро посмотреть содержимое CSV или JSON, но открывать Excel или Google Sheets ради этого перебор.

Тут пригодится TableLens — расширение для Chrome (и браузеров на его движке), которое позволяет открывать и базово обрабатывать табличные данные без лишних телодвижений.

🐱 Что реально умеет?

• Открывает CSV и JSON-файлы как таблицу прямо в браузере.
• Позволяет фильтровать строки по значениям в столбцах.
• Сортировать данные по возрастанию/убыванию.
• Искать по ключевым словам.
• Всё это происходит локально — файлы не уходят на сторонние серверы.

🐱 Чего не умеет?

Это не замена Excel или Google Sheets. Сложные формулы, сводные таблицы, макросы — не про него.
Он не вытаскивает таблицы из любой веб-страницы автоматически (для этого нужны парсеры или ручная копипаста).
Расширение активируется, когда открываешь файл с данными или на странице есть явный CSV/JSON.

🐱 Кому может быть полезно?

• OSINT-исследователям, которые часто скачивают CSV и JSON из открытых источников.
• Журналистам, работающим с утечками или выгрузками из реестров.
• Аналитикам, которым нужно быстро проверить структуру данных перед дальнейшей обработкой.
• Всем, кто ценит время и не хочет ради одного файла запускать «тяжёлый» софт.

🛠 Ссылка на установку:
TableLens в Chrome Web Store
Google TableLens: Edit, Visualize & Export Web Tables - Chrome Web Store The Ultimate Web Scraper to Edit, Visualize & Export any Table to Excel, CSV, PDF & More
  • ❤ 5
  • ❤‍🔥 2
  • ⚡ 1
  • 🙏 1
Post #71 171
Зачем дата-журналистам Claude Code и OpenAI Codex? Спойлер: чтобы больше не рыдать над pandas

Дата-журналист Саймон Виллиссон показал киллер-фичу. Агенты на базе Claude Code и OpenAI Codex сами лазают по базам данных, ищут аномалии и строят графики. Достаточно просто попросить.

Представьте: загрузили таблицу с рождаемостью в российских регионах, попросили «найди аномалии» — и через минуту получили ответ и визуал. Ни строчки кода, ни паники.

Смотрим воркшоп и применяем на практике (там всё понятно, даже если вы не программист):
👉 Coding Agents for Data Analysis

Ну а если вопросы появились— всегда можно попросить агента объяснить, что вообще происходит и как работает созданная им система
Simon Willison’s Weblog Coding agents for data analysis Here's the handout I prepared for my NICAR 2026 workshop "Coding agents for data analysis" - a three hour session aimed at data journalists demonstrating ways that tools like Claude …
  • 🔥 4
  • 👍 1
  • 👨‍💻 1
Post #70 359
Что под капотом у дата-исследования Reuters о кондиционерах в американских тюрьмах

Тюрьмы в США часто строят в относительно жарких местах, изолированных от цивилизации. Агентство Reuters провело серию интервью, из которых узнало, что заключенные в таких исправительных учреждениях особенно боятся лета из-за экстремальной жары. Жары, которую приходится переносить без кондиционеров и свободного доступа к воде.

Так появилось исследование о том, как обстоят дела с кондиционированием в американских тюрьмах. Так что же сделали журналисты?

🐱 Они запросили у властей данные о наличии кондиционеров в камерах и ежедневные замеры температуры внутри камер. В феврале 2024 года отправили запросы в тюрьмы с просьбой поделиться данными о кондиционерах.

🐱 Ответы получили от 35 штатов, из них 29 прислали нужные данные. Некоторые штаты либо отказались, либо не вели такой учёт. Федеральное бюро тюрем, которое отвечает за все 122 федеральных тюрьмы, не ответило.

🐱 В декабре 2024 журналисты повторили запрос и попросили электронные записи о ежедневной температуре за год — с декабря 2023 по декабрь 2024.

🐱 Для анализа собранных данных в Reuters создали таблицу, присвоили каждой тюрьме уникальный ID и связали данные с картами тюрем. Для классификации систем охлаждения создали простую шкалу: есть кондиционер, нет кондиционера или нет данных.

🐱 Оказалось, почти в половине тюрем как минимум в части камер нет кондиционеров. Например, в Техасе 51 из 58 тюрем не оснащены системами охлаждения. В Мэриленде кондиционеров нет ни в одной тюрьме. Но у исследования есть ограничение: даже наличие кондиционера не гарантирует прохлады — иногда системы поломаны или требуют ремонта.

Мне показалось любопытным то, как журналисты Reuters обрабатывали данные о температуре. Только из штата Калифорния поступило почти 190 PDF с рукописными записями — более чем 28 000 страниц. В большинстве документов были ежедневные замеры температуры внутри камер.

Чтобы быстро обработать такой объём рукописного текста, исследователи использовали Gemini 2.5 Pro. Нейронка распознавала записи и превращала их в структурированные цифровые данные. Потом данные проверяли вручную, чтобы убедиться в их правильности. Выборка из 384 записей показала, что ИИ с 95% точностью считывал температуру (правда с небольшой погрешностью ±1 градус).

Так выяснилось, что в некоторых тюрьмах температура внутри камер поднималась до 104°F (40°C), что опасно для здоровья заключенных.

Подробнее о том, как именно проводилось исследование, можно прочитать в этой статье и на GitHub. А закончу риторическим вопросом: как думаете, есть ли такие данные о российских тюрьмах и насколько высока вероятность их получить?
Reuters Scorching cells How heat threatens lives in America’s prisons
  • 🍾 4
  • 👨‍💻 2
  • ❤ 1
Post #69 399
Google проиндексировал сотни приватных чатов ChatGPT — это находка для расследований и серьезный риск для приватности

Журналист-расследователь Хенк ван Эсс обнаружил в свободном доступе свыше 500 чат-сессий с ChatGPT, где корпоративные топы, госслужащие и просто пользователи обсуждают с ИИ личные и служебные темы — от финансовых отчётов и предстоящих сделок до конфликтов и даже криминальных схем.

Каждый пятый чат содержал по-настоящему чувствительную информацию. Например, один пользователь планировал кибератаки против ХАМАС с использованием вредоносного ПО, другой обсуждал схему ухода от долгов на $750 тыс. Встретились и необычные кейсы: сотрудник международного аналитического центра создавал сценарии кризиса правительства США, а кто-то тщетно пытался подделать разрешение на парковку, объясняя это нейронке «борьбой с рабством».

🐱Почему чаты попали в открытый доступ?

ChatGPT имеет функцию «поделиться», создающую постоянные публичные ссылки на chatgpt.com/share. Эти ссылки индексируют поисковики вроде Google, открывая доступ к чатам. Другие ИИ-платформы (Claude, Bing, Gemini) такую автоматическую индексацию не допускают (а вот у Meta она тоже есть, будьте аккуратны).

🐱Зачем это дата-журналистам?

Это еще один неожиданный источник информации. Здесь можно найти информацию о служебных конфликтах, инсайдерские данные и необычные темы для расследований.

🐱Как искать эти чаты?

Принцип тот же, что и в дорках — с помощью сложных поисковых запросов (рассказывала об этом тут).

Вот примеры запросов от Хенка ван Эсса:

Деловая разведка:

site:chatgpt.com/share ("my company" + (strategy OR revenue OR acquisition) OR "our competitor" OR "confidential" OR "NDA" OR "internal only" OR "upcoming merger" OR "quarterly earnings" OR "trade secret")

Преступные намерения:

site:chatgpt.com/share ("without getting caught" OR "avoid detection" OR "without permission" OR "get away with" OR "without anyone knowing")

Профессиональные нарушения:

site:chatgpt.com/share ("write my essay" OR "plagiarism" OR "my assignment due" OR "don't mention AI" OR "fake invoice" OR "insider trading")

Раскрытие личной информации:

site:chatgpt.com/share ("my salary" OR "my SSN" OR "diagnosed with" OR "my medication" OR "my therapist")

Ну и по нашей традиции для самых въедливых (таких как я) — вот источник инфы
  • 👍 4
  • ❤ 3
  • 🤯 2
Post #68 290
LinkedIn как инструмент OSINT: что можно выжать из соцсети для карьеристов

LinkedIn — один из самых мощных источников для корпоративного OSINT. Особенно после запуска публичной рекламной библиотеки (да, теперь можно искать рекламу по ключевым словам, странам и датам). Но и помимо рекламы там полно полезного.

Что можно найти:

Структура компаний

- Ad Library — новый источник для поиска B2B-кампаний, «тихого» найма и политического таргетинга на профи-аудиторию.
- Раздел «People» показывает, кто где работает, какие у них роли, где учились и живут.
- Раздел «Jobs» — кладезь для анализа технологий и процессов (по описаниям вакансий).
- Посты и обновления — часто анонсируют партнёрства, увольнения, релокации.

Данные о людях

- Даже если фамилия скрыта — можно «угадать» её по буквам через поиск.
- Некоторые данные есть в URL (например имя-фамилия в username), в PDF-профилях и даже в картинках с сертификатами.
- Рекомендации от коллег часто раскрывают полное имя, даже если сам профиль — частично анонимный.

Язык и регион

- Язык интерфейса профиля можно узнать через PDF-экспорт — это помогает точнее подстроить ресёрч.
- По географии сотрудников можно понять, куда компания расширяется или откуда уходит.
- Люди постят бейджи, офисы, сувениры с логотипами — всё это может помочь в верификации.
- Если профиль верифицирован через рабочую почту — значит, она активна.

Инструменты

- Google Dorks → ищем профили без логина в LinkedIn:
site:linkedin.com inurl : "/in/" "<название_компании>" -inurl: "<название_компании>"
- Wayback Machine → ищем удалённые профили или проверяем изменения по вебархиву.
- Outlook + LinkedIn интеграция → проверяем, привязан ли email к профилю.

Проверить публичные данные о рекламе можно здесь, почитать подробнее про остальные инструменты — здесь
  • 🔥 6
  • 👍 4
Post #67 351
🦾Google Scholar — секретное оружие для OSINT-расследований

Знаете, какой инструмент почти никто не использует, а зря? Google Scholar. Да, тот самый поисковик научных статей. Он не раз меня спасал, когда нужно было найти иностранные судебные кейсы, связанные с людьми, компаниями или организациями.

Например, завтра в США начнется суд против экс-дипломата Сергея Шестакова по делу о содействии Дерипаске в обходе санкций. Если пробить его имя через раздел Case Law в Google Scholar — находится целая пачка дел, где он фигурировал.

Даже если интересующий вас человек или компания не настолько известны, одна найденная запись может дать кучу новых зацепок: имена, компании, адреса, телефоны, связи.

Что делаем:

1. Заходим в Google Scholar → Case Law.
2. Вбиваем имя или компанию.
3. Смотрим не только сам кейс, но и раздел «How Cited» — там часто всплывают другие дела с теми же фигурантами.
4. Извлекаем всё полезное: новые имена, компании, контакты, детали. Это новые селекторы для дальнейшего поиска.

Удачного поиска!
  • ❤‍🔥 10
  • 👾 3
  • 🔥 1
Post #66 271

Forwarded from доказательный ⎵ пробел

Профессор ЦЕУ Габор Бекеш продолжает радовать нас открытыми курсами в области анализа данных (об одном из них мы писали ранее). Совсем недавно в свет вышел Курс «Анализ данных с использованием ИИ» (Doing Data Analysis with AI) , который предназначен для студентов с базовыми знаниями в области анализа данных, эконометрики и количественных методов. Курс учит применять ИИ для повышения продуктивности в анализе данных. Основное внимание уделяется использованию крупных языковых моделей (LLMs), таких как ChatGPT, Claude.ai и других. Есть много практических кейсов: например, здесь Бекеш подробно описывает как генерировать графики распределения доходов в привязке к уровню образования и гендеру, приводя примеры промтов и результатов выдачи ChatGPT и Claude.ai. Если еще не используете ИИ в дата-анализе и исследованиях, курс - хорош для погружения 🧠

@evidencespace
  • 👨‍💻 2
Post #65 259
Как ProPublica натравила нейронку на тысячи американских грантов. Промт

Помните, как Дональд Трамп урезал федеральные расходы на науку до минимума за 35 лет? Одним из идеологов той кампании стал техасский сенатор-республиканец Тед Круз.

Недавно Круз «проверил» траты администрации Байдена и насчитал 3400 грантов, которые пропагандируют неомарксизм и идеалогию дайвёрсити и инклюзивности. По его подсчётам, на это «безобразие» ушло более $2 млрд.

В ProPublica скачали опубликованную базу и прогнали её через нейросеть — просто чтобы понять, чем руководствовался сенатор. Курьёз: в список попал, например, проект о миграции мяты по континентам. Позже выяснилось, что грант «заподозрили» из-за слов diversify (о биоразнообразии) и female (в контексте женщины-учёной).

Что сделали журналисты?

1. Поручили ИИ «притвориться» расследователем: искать «опасные» слова в описаниях грантов и оставлять поле пустым, если нет уверенности. Так минимизировали галлюцинации.

2. Ручная проверка: редакторы прошли по вычищенной базе, подтвердили каждую деталь, обзвонили всех фигурантов и ведомства — классический факт-чек.

Вот что получилось в итоге, а вот и обещанный промт (переведено само собой нейронкой):
Контекст: Мы будем показывать вам гранты Национального научного фонда (NSF), которые предложено отменить, потому что, по мнению офиса сенатора-республиканца Теда Круза, они содержат темы «пробуждённой» (woke) идеологии; разнообразия, справедливости и инклюзии (DEI); либо неомарксистской идеологии. Мы хотим проанализировать описания этих грантов и выяснить, встречаются ли в них термины или темы, которые можно считать «woke» или относящимися к DEI. Ваша задача — определить, присутствуют ли такие темы в тексте, и сообщить мне о находках. Извлекайте информацию только из гранта NSF, если он действительно содержит требуемые данные.

--

Как журналист-расследователь, я ожидаю от вас следующую информацию

--

woke_description: Короткое описание (максимум один абзац) того, почему этот грант выделен как продвигающий «woke»-идеологию, разнообразие, справедливость и инклюзию (DEI) или продвинутую неомарксистскую «борьбу классов». Оставьте поле пустым, если это неясно.

why_flagged: Посмотрите на поля «STATUS», «SOCIAL JUSTICE CATEGORY», «RACE CATEGORY», «GENDER CATEGORY» и «ENVIRONMENTAL JUSTICE CATEGORY». Если какое-то из них заполнено, значит автор документа счёл, что грант продвигает идеологию DEI именно в этом аспекте. Проанализируйте поле «AWARD DESCRIPTIONS» и постарайтесь понять, почему автор мог отметить грант таким образом. Напишите подробно и понятно, по одному объяснению на каждый тип и грант.

citation_for_flag: Извлеките очень короткую цитату из поля «AWARD DESCRIPTIONS», подтверждающую данные из «why_flagged».
ProPublica How ProPublica Uses AI Responsibly in Its Investigations When our reporters prompted a large language model to help identify “woke” themes in a database of grants, AI helped them tell a vital accountability story about science funding and Ted Cruz.
  • ❤ 6
  • 🤩 2
  • 🔥 1
  • 🏆 1
Post #64 277
Как вытаскивать данные с самых упрямых сайтов: 4 продвинутых метода веб-скрейпинга

Дата-журналист Саймон Виллисон провёл на конференции NICAR 2025 крутой воркшоп про новейшие методы веб-скрейпинга.

Собрала самое главное:

1. Git-скрейпинг

Автоматически следим за изменениями на сайте и сохраняем историю в GitHub через GitHub Actions. Полезно для отслеживания цен, публикаций госданных и статистики.

2. JavaScript + shot-scraper

Запускаем JavaScript прямо в браузере или через командную строку (shot-scraper). Полезно при автоматизации сбора данных с сайтов, устойчивых к классическим методам парсинга. А еще для бесконечной прокрутки — как в Twitter.

3. Нейросети для извлечения структурированных данных

GPT-4o и Gemini отлично извлекают структурированную информацию из плохо размеченных сайтов — например, пдфки и даже изображения. Новая фишка — поддержка схем данных.

4. Видео-скрейпинг

Когда сайт ну совсем не даёт собирать данные, делаем захват экрана, загружаем видео в Google AI Studio и получаем таблицу. Работает даже с самыми защищёнными ресурсами.

Саймон также придумал как безопасно раздавать API-ключи участникам воркшопов через страницу с зашифрованным сообщением. Попробовать можно тут: tools.simonwillison.net/encrypt (пароль: "demo").

#дата_журналистика #скрейпинг #полезное
Simon Willison’s Weblog Simon Willison on git-scraping 34 posts tagged ‘git-scraping’. Git scraping is a technique where data is scraped from an external source into a Git repository in order to record changes to that data over time.
  • ❤ 3
  • ❤‍🔥 2
  • 👨‍💻 1
Post #63 266
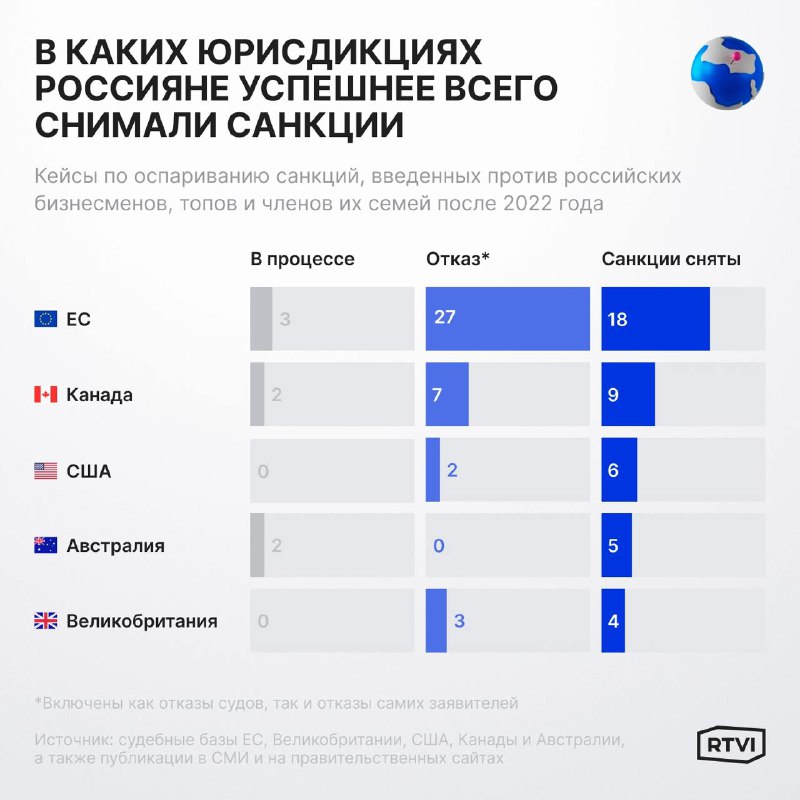
Где искать кейсы об оспаривании антироссийских санкций

Недавно я разбиралась, как российские миллиардеры оспаривают санкции ЕС, США и других стран — и заодно, как они пытаются исчезнуть из списков Forbes, которые часто становятся основанием для санкций.

Решила поделиться источниками по основным юрисдикциям:

- Европейский союз
- Великобритания
- Канада
- США

Правда есть тут нюансы. Иногда вместо имен в таких делах указывают инициалы, которые не совпадают с реальными. Например, бывшая супруга Фридмана в судебной базе ЕС фигурировала как QF. Но в самом судебном акте было указано:

В 1989 году она вышла замуж за Михаила Фридмана, с которым развелась в 2005 году.


В общем пользуйтесь! Ну а что получилось по итогу, можно посмотреть здесь:

- «Конфликт серьезно подорвал капиталы»: кто пропал из списков богатейших россиян за три года СВО

- Каждое второе решение — положительное: как российские миллиардеры и их семьи избавляются от западных санкций
  • 🔥 5
  • ❤ 3
  • 👍 2
  • 👏 2
Post #62 289

Forwarded from RTVI

⭕️⭕️ Приставы, полиция и обманутые клиенты разыскивают фальшивый «Сбер» с офисом в «Москва-Сити». RTVI рассказывает, откуда он взялся и как исчез

В ноябре 2024 года против неустановленных руководителей и сотрудников московской компании «Сбер Холдинг» возбудили уголовное дело о мошенничестве в особо крупном размере. Организация, не связанная с настоящим Сбером, использовала бренд, чтобы привлекать деньги россиян, обещая им высокую прибыль. Однако вместо выплат клиенты остались ни с чем.

Компания возникла несколько лет назад на базе зарегистрированного еще в 1999 году ООО, которое занималось торговлей алкоголем. Используя долголетнюю «выдержку» и схожие со настоящим Сбербанком бизнес-девизы, «Сбер Холдинг» активно продавал эту легенду доверчивым клиентам.

Как говорилось на сайте компании, за 20 лет работы она обслужила 19 тысяч клиентов и обеспечила им совокупный доход в 3,5 млрд рублей. Сегодня с уверенностью можно сказать, что все это ложь.

Директором компании сначала значилась осужденная в 2008 году за наркотики женщина, а затем — уроженец Брянской области, чей номер сегодня принадлежит женщине из Самары. Сотрудники компании использовали фальшивые имена и фотографии со стоков. Кроме того, в активе «Сбер Холдинга» имелся офшор, на сайте которого упоминалась организация «Конкорд» (чаще всего звучит в привязке с ЧВК «Вагнер» и Евгением Пригожиным).

Как выяснил RTVI, с 2022 года за руководителями «Сбер Холдинга» охотятся судебные приставы, пытаясь взыскать 1,5 млрд рублей. Но тщетно — установить местонахождение должника и его имущества невозможно

⭕ Подпишись на RTVI
  • 🔥 4
Older posts →

About this channel

How can I read @data_reporter without a Telegram account?
TGViewer shows the public web preview Telegram publishes for дата-журналистика и котики: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does дата-журналистика и котики have?
дата-журналистика и котики (@data_reporter) has 118 subscribers on Telegram, refreshed roughly every 30 minutes.
Does дата-журналистика и котики know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →