мелкое — крупно,
в глубоком разговоре
мудрость приходит
по вопросам сюда: @aigul_sea
Post #144
1.58K
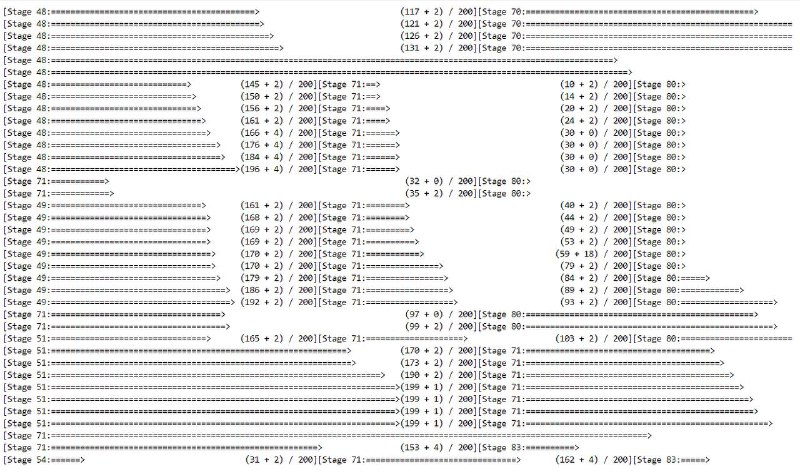
Логи расчетов
Просто оставлю здесь это искусство🎨
Просто оставлю здесь это искусство🎨
- ❤ 2
 ДА
@data_engineerette
Showing posts older than #145 · Back to latest

spark.sql("DESCRIBE FORMATTED web.visits partition (visit_date='2024-03-01')")
  .where("col_name = 'Location'")
  .select("data_type")
  .show()
DESCRIBE FORMATTED хранит инфу о полях и типах данных плюс метаинформацию (дату создания, партиции, форматы хранения, локацию) и возвращает примерно такую табличку:+-----------------------------+
|col_name |data_type |comment|
+-----------------------------+
|visit_date|string |Дата |
|# Storage | | |
|Location |hdfs://...| |
+-----------------------------+
val df = spark.read.parquet("ctrl+c наш location")


for dt in pd.date_range(start_dt1, end_dt):
  load1(start_dt1)

for dt in pd.date_range(start_dt2, end_dt):
  load2(start_dt2)
min_dt = min(start_dt1, start_dt2)

for dt in pd.date_range(min_dt, end_dt):
  if dt >= start_dt1:
    load1(dt)
  elif dt >= start_dt2:
    load2(dt)
def loop(start_dt, end_dt, func):
  for dt in pd.date_range(start_dt, end_dt):
    func(dt)


func_list = [(load1, start_dt1), (load2, start_dt2)]

for func, dt in func_list:
  loop(dt, end_dt, func)

df1.join(df2, ['id'], 'inner')
== Physical Plan ==
+- Project
   +- SortMergeJoin
      :- Sort
      :  +- Exchange hashpartitioning
      :     +- Filter isnotnull
      :        +- Scan ExistingRDD
      +- Sort ...
compare_udf = F.udf(lambda x, y: x == y, BooleanType())

df1.alias('df1') \
.join(
    df2.alias('df2'),
    compare_udf(
        F.col('df1.id'),
        F.col('df2.id')
    ),
    'inner'
)
== Physical Plan ==
*(3) Project
+- *(3) Filter pythonUDF0#56: boolean
   +- BatchEvalPython [<lambda>(id#0L, id#4L)], [pythonUDF0#56]
      +- CartesianProduct
         :- *(1) Scan ExistingRDD
         +- *(2) Scan ExistingRDD
SortMerge     -> Cartesian
ShuffledHash  -> Cartesian
BroadcastHash -> BroadcastNestedLoopCREATE INDEX us_date_idx ON my_table (concat_ws('/', month(dt), day(dt), year(dt)))like '%elem1%'
--день и год
--1/2 - это конец дня и начало года
like 'year%day'

--месяц и день
--1/2 - это конец месяца и начало дня
like '-%month-day%'
--1/29/202 - месяц и год могут быть недописаны
like 'year%-%month-day'


spark.sql(
  'select id from users'
) \
.createOrReplaceTempView('view_users')
df_users = spark.table('view_users')
"Агрегации - ... в известной степени приближение к методам машинного обучения и искусственного интеллекта".
"Во время моей работы со Spark я встречал два типа людей: тех, кто имел опыт работы с Apache Hadoop, и тех, у кого не было такого опыта".
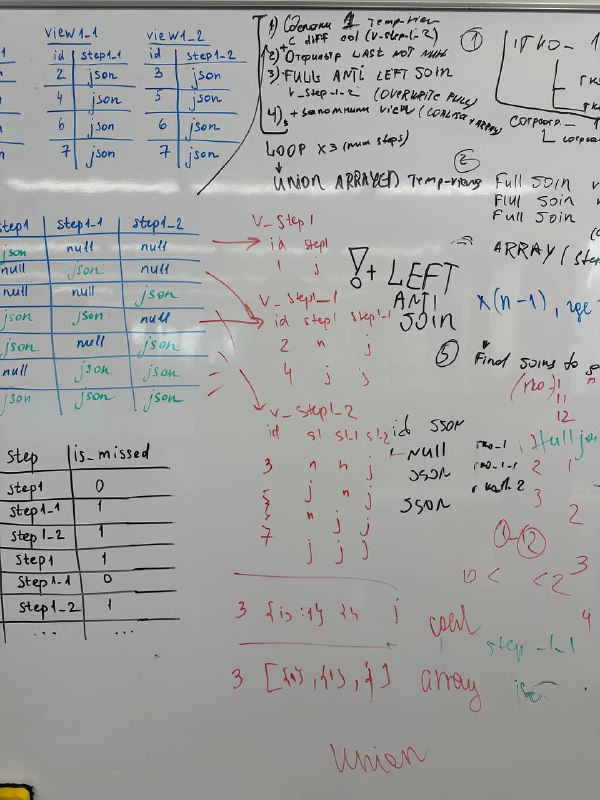
3 null null json
5 json null json
6 null json json
7 json json json1 json null null
2 null json null
4 json json null
2 null json
4 json json
1 json null null


--тут не войдет 31 число
WHERE datetime >= '2024-03-01' AND datetime < '2024-03-31'

--тут за 31.03 войдет только 00:00:00
WHERE datetime  between '2024-03-01' AND '2024-03-31'

--поэтому так правильнее
WHERE datetime > '2024-03-01' AND datetime < '2024-04-01'