TGViewer
Channel Public Channel
дата инженеретта

дата инженеретта

@data_engineerette

мелкое — крупно,
в глубоком разговоре
мудрость приходит

по вопросам сюда: @aigul_sea
Subscribers
3.43K
Photos
296
Videos
28
Links
127
Recent Posts 16 shown
Post #623 493
5 октября начнется 19-й поток программы Data Engineer от Newprolab

Программа для junior- и middle-дата-инженеров, аналитиков, backend-разработчиков, техлидов и тех, кто работает с data-командами и хочет лучше понимать современный стек DE

📌 Что внутри:
– 10 недель обучения
– 30 занятий: онлайн + записи
– 10 практических лабораторных работ
– облачный кластер и реальные данные
– чат участников и поддержка команды программы

📌 Что получите на выходе:
1. Научитесь решать типовые задачи DE на практике
2. Систематизируете знания и закроете пробелы в современном DE-стеке
3. Поработаете с реальными данными и инфраструктурой, а не только с учебными примерами
4. Соберете практический опыт, который можно обсуждать на собеседованиях и использовать в работе
5. Все записи и материалы останутся у вас после окончания программы

Преподаватели – практикующие специалисты из ведущих технологических компаний. На занятиях можно разбирать реальные кейсы, задавать вопросы и получать обратную связь

👉 Подробности и квиз – на сайте

Квиз покажет, насколько программа подходит именно под вашу роль и задачи, даст персональные рекомендации и промокод на скидку
___
По всем вопросам пишите Алексею @snitsa

Реклама. НОЧУ ДПО «НЬЮПРОЛАБ», ИНН 7729461098, erid: CQH36pWzJqVKq9rQZnhg1RNLGQNA1VAz2sBGdwk93diyT9
  • 👍 3
Post #622 1.2K
Каким должен быть хороший DE?

Меня однажды спросили на собесе:

🤩Какие 3 качества важны для де?

В том числе:
🤩абстрактные качества, которые помогают в работе
🤩собственные качества, сильные стороны
🤩качества кандидата при собеседовании к вам в команду

Тогда я сильно замялась, потому что никогда мне такого вопроса не задавали и он прям заставил задуматься)) По-моему, я сказала что-то вроде:
🤩широкий кругозор, чтобы можно было критически оценивать и предлагать технические решения
🤩желание разобраться в проблеме и найти причину, поковыряться в логах, выяснить, почему упало
🤩третье я капитально забыла🙂

А как бы вы ответили на этот вопрос?

@data_engineerette
  • 🔥 3
Post #620 1.37K
Mermaid-диаграммы

Наконец-то дошли руки поковыряться в mermaid-диаграммах, это что за имба вообще🔥🔥По сути это своего рода DaaS - Diagram as a Code, вы описываете диаграмму в нужном синтаксисе, потом она отрисовывается

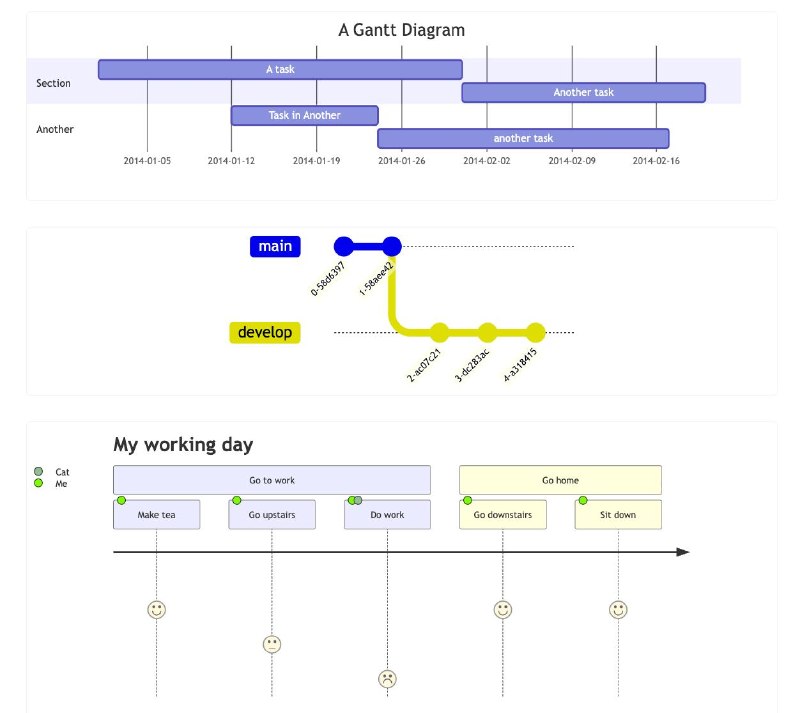
Я полистала, что mermaid умеет вообще рисовать - там из прикольного: очень красивая диаграмма Ганта, граф с гит-коммитами, диаграмма Cynefin для принятия решений. Ну и всякие UML-ки, ER там тоже есть

Диаграммы имеют особый синтаксис, например, для ER-модели связи обозначаются вот так:


|o - 0/1
|| - 1
}o - >= 0
}| - >= 1


Напоминает корейский алфавит🇰🇷 А если нарисовать связь между двумя сущностями, то вообще получаются какие-то смайлики:


}o..o{
||--o{
|o--o{


В общем, удобная и полезная штука - не нужно рисовать самому в draw.io или где-то еще, оно само красиво отрендерится💅

@data_engineerette
  • 🤔 1
Post #618 2.12K
Iceberg — это внезапный бум или планомерная подготовка?

Заметили, как с определенного момента стало много айсберга в DE? Хотя я сейчас зашла чекнуть вакансии на hh, и iceberg упоминается в 68 из 455 дата инженерских вакансий - что около 15%. Но у меня есть стойкое ощущение, что все про него говорят, всем он нужен и везде его используют

🐱 Последний раз я обращала на это внимание в марте. Тогда мне казалось, что компании только-только переходят на лейкхаус и начали строить его 1 или 2 года назад. Но на самом деле это было гораздо раньше

Недавно я узнала, что в Т-банке развитие в сторону лейкхауса началось еще тогда, когда меня не было в де🥺 Да и MWS не смогли бы выкатить свою лейкхаус-платформу в середине 2025 года, если бы не стартовали еще тогда

☕️ Мы в Сбере тоже обсуждали табличные форматы, но мне казалось это таким нишевым и далеким от индустрии, поэтому я особо не изучала всякие айсберги/худи/дельты и отличия одного от другого. А ведь в то же самое время все остальные уже готовились...

🌱🌱🌱🌱

Так что получается, мы узнаем о технологическом тренде, когда другие уже презентовали свои результаты раньше всех. И теперь мне интересно: что прямо сейчас кажется нишевой штукой, на которую мы не особо обращаем внимание, но через год оно будет везде?

@data_engineerette
  • ❤ 6
Post #617 2.39K
Как забытый ON CLUSTER поставил меня в тупик

Я создала таблицу ReplicatedReplacingMergeTree, потом переделала на обычный ReplicatedMergeTree. Дропнула таблицы, но тупо забыла ON CLUSTER, и вот что из этого вышло

🫤 Запускаю загрузку, она падает, я чищу табличку и гружу заново. Казалось бы, проблемы больше нет? Сверяюсь по каунтам - сильно отличается. Снова перезагружаю - вообще другие каунты стали. Что происходит? Смотрю инфу по репликам:


SELECT hostName(), pid, count()
FROM clusterAllReplicas('default', schema.table)
GROUP BY hostName(), pid
ORDER BY pid, hostName();


На двух хостах сходится, на третьем сильно меньше данных и вообще нет большого куска, при этом все цифры разъезжаются с источником…

Я делаю truncate - а с третьего хоста данные вообще не удаляются. Делаю truncate sync - снова ничего не происходит. SYSTEM SYNC REPLICA schema.table - то же самое

🤔 Иишка советует заглянуть в system.distributed_ddl_queue - но там все Finished. Потом смотрю zookeeper_path:


SELECT
hostName(),
zookeeper_path,
total_replicas,
active_replicas,
last_queue_update_exception
FROM clusterAllReplicas('default', system.replicas)
WHERE database = 'schema'
AND table = 'table';


Первые 2 хоста в одной репликационной группе:

/clickhouse/tables/9e0fe594-04f6-41ad-8137-385f08c2fbe5/shard1
total_replicas = 2

А третья живет отдельно:

/clickhouse/tables/faee8477-d2a6-47c9-8cc9-8a3f44972612/shard1
total_replicas = 1

Дальше смотрю DDL на разных хостах:


SELECT hostName(), create_table_query
FROM clusterAllReplicas('default', system.tables)
WHERE database = 'schema'
AND name = 'table';


Первые две - ReplicatedReplacingMergeTree
Третья - ReplicatedMergeTree

Поверх этих таблиц еще была Distributed, а она читает табличку на основе параметра load_balancing:


SELECT value
FROM system.settings
WHERE name = 'load_balancing';


В моем случае там был random, и он постоянно возвращал данные с третьей реплики (кроме random, есть еще несколько)

А почему данных на третьей реплике было меньше? Все еще помните про самый первый процесс, который упал? Так вот он записал кусок данных, но почистить их кх уже не смог. А при следующем запуске запись пошла в другую реплику

В общем, два забытых слова привели к тотальной смеси двух миров

@data_engineerette
  • 🤔 9
  • 👍 8
  • 💅 4
  • ❤ 2
Post #616 2.09K
В начале лета я рассказывала, как начала проходить курс по алгосам, сейчас делюсь с вами промежуточными впечатлениями🙂

👩‍💻 Первый месяц я активно садилась за задачи раз или два в неделю - этого было вполне достаточно. Сам смысл курса подается не как "пока самостоятельно не решите 100 задач на литкоде, из-за компа не выходите", а как "сначала смотрим объяснение и решение, потом идем кодить, если не запомнили - смотрим еще раз и повторяем"

В рамках одного 10-минутного видоса разбирается одна задача, иногда с несколькими вариантами решения, в конце анализируется сложность по времени и памяти. Что я заметила - когда мне голосом объясняют суть задачи, мне становится в разы понятнее. Поэтому мой типичный флоу занятий такой: я смотрю 1-2 минутки с объяснением условия, иду решать сама, потом досматриваю

С какого-то момента действительно появился азарт, хочется решить как можно больше задач до момента усталости) Пока я отметила для себя всего 2 задачки, которые вызвали трудности, и я оценила их по сложности на 5/10 по сравнению со всеми остальными

📊 Для трекинга прогресса нам рекомендовали завести гугл табличку с решенными задачами, затраченным временем и комментами. Я туда еще вписываю свои впечатления по задаче, новые синтаксические конструкции и инсайты после объяснений. Пока из интересного - идея с выделением виртуального места в массиве, иногда полезно идти с конца, также понравился мой собственный подход с просмотром только 1/4 матрицы

📞 Лайв созвоны случаются в конце спринта, где кураторы вместе с учениками разбирают задачи на самостоятельное прорешивание, отвечают на вопросы. Но вопросы можно задавать и в чатике, там все очень активные, периодически кураторы присылают разборы на задачи с собесов

В июле с отпусками я подзабросила курс🤩 В текущем спринте начали темы связных список и стека, но я надеюсь быстренько все догнать

@data_engineerette
Telegram дата инженеретта На пути к гуру алгосов 01.06 стартует новый поток курса от Глеба Михайлова, и я на него иду! Алгосы — это точно мое слабое место, и я прямо в превкушении почувствовать «азарт охотника, а не ужас жертвы»🐆 Я уже зарегалась на платформе, добавилась в чатик…
  • ❤ 12
  • 🔥 7
Post #615 1.94K
Походу салон нанял себе дата аналитика🤭

Или можно подключить аналитику у самого сервиса по записи?

В любом случае я теперь переживаю, что, если не запишусь сейчас, кому-то на дейли придется объяснять просадку retention rate😕

@data_engineerette
  • 😁 66
  • 🤔 2
  • 🌚 2
  • ❤ 1
Post #613 2.43K
Анти чек-лист работы в DE

По ходу жизни собрала список того, что мне не очень нравится в работе. И вот что в него вошло:

1️⃣Канбан

У вас нет пула задач на ближайшее время. К вам могут приходить аналитики и менеджеры с адхоками, которым нужны отчеты еще вчера. Вы не можете спокойно распределить время на свои задачи. В канбане будут всегда прилетать новые задачи, которые нужно взять, как только закончите предыдущую. И вместе с этим постоянное ощущение напряга

2️⃣ Проектная работа

Проекты заканчиваются. Допустим, он длится год, потом вам обещают найти другой. А если проект свернут раньше года? А если другой проект не найдется?

3️⃣ Срочный трудовой договор

Он может быть короче даже самого проекта. А если договор не продлят? Не проще ли сразу найти нормальное место и не жить в страхе от приближения того самого дня?

4️⃣ Ты - единственный DE

Я в такое лезть не пробовала, но внутренне становится некомфортно. Представь, у тебя больше нет DEшной экспертизы в команде. Если не получается - надеешься только на себя (ну и на иишку)

5️⃣ В стеке только 3 инструмента

На рынке де столько всего требуется, как потом красиво преподать свой опыт, когда ты все последнее время писал только SQL и YAML?

6️⃣ Очень сложные задачи

А это я бы назвала другой крайностью 5го пункта) Делать настолько уникальное, что в других местах абсолютно не нужно. Или просто лично для меня непонятное, например, писать заливку данных на Rust

7️⃣ Уникальный стек

Молодец, ты освоишь инструмент, который нигде больше не используется

8️⃣ Нет созвонов

Вот вообще. Хотя бы раз в несколько дней. Просто заканчиваешь одну задачку и берешь следующую. В такие моменты складывается ощущение, что члены команды между собой не общаются. У кого-то такой подход может вызывать лишь восторг) Но для меня общение с коллегами - реально важная часть и чего не хватает на удаленке

9️⃣ Нет чатика с мемами

Это тоже в тему общения с командой и создания более прочных коммуникативных связей

💫💫💫💫💫💫💫💫💫💫💫

Здесь я привела свое субъективное мнение, вы можете поспорить или дополнить своими пунктами🥺

@data_engineerette
  • 🔥 35
  • 👍 12
Post #611 2.31K
Ребят, а тут есть такие, кто идет на дата конфу в Лондоне?

https://www.bigdataldn.com

Она бесплатная, нужно просто прилететь🙂 По темам очень похоже: лейкхаус, AI агенты, data fabric, data governance. И сессии от топовых компаний: Databricks, Microsoft, Google, JetBrains, dbt Labs, Snowflake…

Я вот зарегалась и даже на некоторое время задумалась над подачей визы🤭 Но потом как вспомнила, что ИМЕННО В ЭТИ ДАТЫ у меня конфа в Москве

Так что ищу шпиониро😎

Полную программу конференции можно хотя бы полистать тут

@data_engineerette
  • 😁 15
  • 💅 4
  • ❤ 2
Post #609 2.91K
пупупу
у меня всего 9 с половиной😚
  • 😁 52
  • ❤ 8
Post #608 3.35K
Отгадайте с первой попытки, за какой это было период и что случилось😁😁

@data_engineerette
  • 🌚 12
  • 😁 6
  • 💅 2
Post #606 3.8K
Сеньорские вопросы

🤵 Чем круче вы становитесь, чем в более highload сторону вы идете, чем быстрее развиваются ллмки, тем вопросики к вам становятся все серьезнее

Собрала для вас подборку таких вопросов по технологиям:

Spark

Из чего состоит executor memory?
Что такое spark.memory.storageFraction?
В чем разница между Sort-Merge Join и Broadcast на маленькой таблице?
Каким образом уменьшить количество шафла?
Зачем нужен data spill?
Как работает AQE?
Какие проблемы спарка в кубере?

🧊Iceberg

Как айсберг работает с параллельным изменением одного файла и нескольких?
Почему при записи из старой таблицы в новую в айсберге джоба бежит очень долго? 
Почему при перекладке в айсберг забивается кэш?
Какие проблемы с айсбергом, кроме maintenance?

🌺 Airflow, Python

Что такое TYPE_CHECKING?
Как добавить шаблонизированное поле, если оператор не поддерживает jinja?
Что такое dynamic task mapping?

🖥 ClickHouse

Если данные писались в одну ноду клика, то при ее падении какие данные будут лежать на остальных?
Какие проблемы с Replacing Merge Tree при вставке 5тб данных?
300 колонок, 8 ключей - в чем проблема такого подхода и как лучше поменять?

🧘Kafka

Как интеграция Spark-Kafka умеет обеспечивать exactly once?
Как будет читать спарк из кафки, если 10 коров, 5 партиций? Сколько будет простаивать экзекьюторов?
Как будет читаться таблица в спарке, если 1ТБ один файл, 20 коров? Сколько будет простаивать экзекьюторов?
Как будут читать 10 инстансов приложения из 5 партиций?

@data_engineerette
  • 👍 26
  • ❤ 8
  • 🤔 6
  • 🌚 3
  • 😁 1
Post #605 3.04K
Всем привет! Возвращаюсь на связь, на прошлой неделе была в отпуске😌

А пока на нашем рынке я такого не видела, но на зарубежном после HR-интервью присылается очень подробное и информативное саммари: о чем говорили, что нужно спросить в следующий раз, ваши плюсы/минусы, соответствие вакансии

@data_engineerette
  • 👍 20
  • ❤ 5
  • 💅 2
  • 🌚 1
Post #602 2.98K
Кажется, я уработалась😕

Это моя первая мысль, как только я села в такси
  • 😁 52
  • 😭 8
  • ❤ 6
Post #601 3.47K
Раскрываю тайну

Наверняка у многих был такой момент, что вы заходите в YARN, находите Hive-запрос, хотите в него провалиться, но Tez UI недоступен?

Теперь вы знаете, как он выглядит

@data_engineerette
  • 🤔 3
Post #594 3.78K
Data + AI

🍿 Вчера-сегодня проходит Data + AI Summit от Databricks. Основная суть — как работать с данными в эру AI, реклама собственных разработок, интервью с партнерами и крупными пользователями, кейсы применения сервисов

Меня больше всего поразило — как они красиво говорят, у них такая чистая четкая речь и акцент, как на аудировании😍 И больше 30к людей в офлайне!!

Есть очень много интересных моментов, которые я пометила себе:

🤩Аннонсировали Lakehouse//RT на собственном движке Reyden, который возвращает результат на огромном объеме данных за мс и не требует перекладки данных в отдельную бд под дэши (красивые графички тут) ✨✨

🤩Обсуждали Lakebase — это постгря как движок над s3. Чтобы опять-таки хранить данные в одном месте, а не перекладывать из OLTP в OLAP-системы🤪

🤩LTAP (Lake Transactional/Analytical Processing) = Lakebase + Lakehouse. Данные пишутся строками => строки конвертятся в столбцы => чтение по столбцам. Правда, нам не сказали, насколько эта конвертация затратна❓

🤩На сцене побывал Ryan Blue, один из главных создателей Iceberg. Он сказал, что в Databricks уже поддерживается iceberg v3, где одна из фич — это кросс-поддержка iceberg+delta lake, которые на диске лежат одинаково, и не надо ничего переписывать при смене формата. А к концу q4 или чуть позже уже выйдет iceberg v4

🤩Genie One + Genie Ontology — чат-бот, дополненный глоссарием/знаниями предметной области компании на основе графов + коннектов к гугл драйв/почте/и т.д. А еще он умеет чекать пермишены к данным перед тем, как вернуть ответ. А агентов можно шерить с коллегами✨

🤩Добавляется отдельный агент Genie ZeroOps, который постоянно следит за кластером. Если в 2 часа ночи упал пайплайн, он пойдет искать причины по линейджу всех зависимостей, внесет изменения в код, потестит в песочнице, подготовит фикс и отправит алерт о готовности. Вам остается только аппрувнуть✨✨

🤩Omnigent — платформа, где можно миксовать несколько моделек, чтобы они делали разные операции. Это называется "meta-harness"

🤩В Uber за 1 квартал потратили годовой бюджет на AI

🤩Pepsico — один из пользаков, у которых раньше было 600 дата лейков😳

🤩Databricks заколлабились с OpenAI (приходил кофаундер Greg Brockman), чтобы их модельки забустили дата-сервисы

@data_engineerette
  • 🔥 9
  • ❤ 5
  • 💅 4
Older posts →

About this channel

How can I read @data_engineerette without a Telegram account?
TGViewer shows the public web preview Telegram publishes for дата инженеретта: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does дата инженеретта have?
дата инженеретта (@data_engineerette) has 3.43K subscribers on Telegram, refreshed roughly every 30 minutes.
Does дата инженеретта know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →