TGViewer
Channel Public Channel
EasyData

EasyData

@data_easy

Добро пожаловать!
Меня зовут Мария Жарова, и это мой блог про науку о данных✨

Лайфхаки из будней MLщика, полезности по Data Science и ответы на вопросы, которые волнуют новичков и не только🌝

Автор @NaNCat
Subscribers
1.46K
Photos
185
Videos
12
Links
114

Showing posts older than #199 · Back to latest

Older Posts 11 shown
Post #198 1.25K
Привет, друзья!
Поздравляю всех причастных с Днём студента!🤩
Держите небольшую подборку бесплатных курсов, которые помогут в изучении DS - как для начинающих, так и для продолжающих🤓

📚Для совсем новичков открытый курс по Python на Stepic.
С него можно начинать изучение программирования в принципе, подойдёт не только для будущих дата-саентистов, но и для разработчиков.
➡️ Ссылка на Stepik и на дублирующий плейлист на youtube.

📚Для погружения в классический ML можно начать с курса лекций и семинаров от МФТИ.
➡️ Ссылка на плейлист youtube.

📚 Для тех, кто уже знаком с основами ML, есть продолжение предыдущего курса от МФТИ, который знакомит с DL.
➡️ Ссылка на плейлист youtube.

📚Также в качестве дополнения можно ознакомиться с материалами годового курса от DeepLearning School.
➡️ Здесь найдёте материалы базового потока, а здесь - продвинутого.

📚Для погружения в NLP можете посмотреть материалы курса с ODS.
➡️ Ссылка на курс (нужна регистрация).

📚Для любителей рекомендательных систем есть два мини курса, также с ODS.
➡️ Ссылка на первую часть и на вторую.

📚По CV хороший курс на Hugging Face. Единственный возможный минус - он на английском.
➡️ Ссылка на материалы.

Успехов в учёбе и хороших выходных!🍀

#python@data_easy
#classic_ml@data_easy
#cv@data_easy
#nlp@data_easy
Stepik: online education Инди-курс программирования на Python: Начальный уровень, Бесплатно | курс на Stepik Бесплатный курс «Инди-курс программирования на Python» на Stepik: 2 602 отзыва, 74 урока, 551 тест. Начните обучение бесплатно.
  • 🔥 27
  • ❤ 14
  • 👍 5
Post #197 1.15K
Привет, друзья!
🎯 Как понять, кто вы — джун, мидл или сеньор? А может быть, "мидл+" или "мидл-"😁

Оценка своей роли в команде — важный шаг для профессионального роста и понимания, куда двигаться дальше. Но границы между грейдами часто размыты, а названия ролей в разных компаниях могут означать совершенно разные вещи. Например, в одной бизнес-аналитик — это человек, который анализирует данные и строит диаграммы, а в другой — это фактически продукт-менеджер, управляющий стратегией продукта🤔

📊 Большие компании стараются разрабатывать понятные критерии для грейдов сотрудников. У нас, пожалуй, наиболее распространён playbook от Avito, в котором подробно расписаны навыки и ожидания от IT-специалистов на разных этапах их карьеры. Там вы найдёте градацию по:
- технической экспертизе,
- взаимодействию с командой,
- уровню влияния на развитие продукта.

🔗 Ссылка на репозиторий со всеми материалами: github.com/avito-tech/playbook

Пролистав этот документ, можно определить:
- Какие навыки необходимо развивать, чтобы перейти на следующий уровень?
- Соответствуют ли текущие задачи вашему грейду?
- Не занижены или, наоборот, завышены ли ожидания от вашей роли?

Успехов в самоисследовании!😎

#карьера@data_easy
GitHub GitHub - avito-tech/playbook: AvitoTech team playbook AvitoTech team playbook. Contribute to avito-tech/playbook development by creating an account on GitHub.
  • 🔥 21
  • 👍 7
  • ❤ 5
  • 👀 1
Post #196 1.19K
Всем привет! 👋
Сегодня расскажу о магическом способе дообучить большие языковые модели (LLM), даже если у вас нет сервера с мощными видеокартами. Этот метод называется адаптеры.

Большие языковые модели вроде GPT или BERT уже натренированы на огромных объёмах текстов, но, разумеется, часто их необходимо "подстроить" под конкретные задачи. Например, представьте универсального переводчика, который знает 100 языков, но иногда путается в редких диалектах. Чтобы он стал идеален, ему потребуется донастройка.

🐾 Можно использовать классическое дообучение последних слоёв, однако этот подход часто ограничивает адаптацию. Он использует "универсальные" признаки из начала модели, которые могут быть недостаточно информативны для вашей специфической задачи.
А изменение всех весов, конечно, крайне дорогое для LLM с миллиардами параметров.

🙏 Адаптеры — это маленькие модули, которые вставляются между слоями уже обученной нейросети. Именно они обучаются на новой задаче, при этом исходные слои модели остаются неизменными (замороженными).

Если хотите попробовать, вот несколько инструментов:

😶 Hugging Face PEFT (Parameter-Efficient Fine-Tuning) — библиотека для адаптеров, LoRA и других методов.
🔗ссылка на документацию
🔗папка с примерами из официального репозитория

😶 AdapterHub — репозиторий готовых адаптеров для разных задач.
🔗 ссылка на страничку официального сайта
🔗 документация с примерами

Лёгкой рабочей недели! 😘

#nlp@data_easy
  • 🔥 22
  • ❤ 9
  • 👍 9
Post #195 1.24K
Чек-лист_собеседование_DS.pdf72.2 KB
Привет, дорогие подписчики!
Поздравляю с Новым годом! 🎉 Пусть он принесет вдохновение, множество новых возможностей и ярких свершений✨ Пусть каждый день будет наполнен теплом, радостью, а маленькие шаги ведут к большим победам!😊

Чтобы этот пост был не только праздничным, но и полезным, держите небольшой подарок: чек-лист вопросов с собеседований по Data Science 📋

Подобное может встречаться как на первичном звонке с HR, так и на полноценном техническом собеседовании, где могут попросить развернутые объяснения ключевых тем🤪


Всем успехов в карьере и уверенности в своих силах в 2025 году! 🎉

#карьера@data_easy
  • 🎄 18
  • 🔥 14
  • ❤ 9
  • 🎉 5
Post #193 1.55K
Всем привет, друзья!
Пару дней назад выпустили новую статью на Habr про BERT и его товарищей ❤️
Материал в первую очередь рассчитан для новичков, так что если давно хотели узнать…
🐈 как устроен механизм внимания без математики, а на примерах;
🐈 в чём особенности BERT, чем он так хорош и для каких задач подходит;
🐈 какие у него разновидности;
- время настало😊

И держите практический шаблон в colab с использованием предобученного DistilBert для решения задачи классификации двумя способами😎

С первым днём зимы!☃️

#nlp@data_easy
  • 🔥 12
  • ❤ 10
  • 🐳 2
  • 🤔 1
Post #192 1.24K
Всем привет, друзья!
Как вы обычно ускоряете вычисления, если Python показывает ожидаемое время работы кода несколько часов или дней?😄
Есть простой способ сократить время и заставить процессор работать на полную мощность при помощи библиотеки joblib😎
Она умеет не только (де-)сериализовать объекты, но ещё и упрощает использование нескольких процессов или потоков на Python без необходимости углубляться в тонкости теории.

Ключевой инструмент для параллельного выполнения задач — Parallel. Попробуйте сравнить два варианта кода:


import time
from tqdm import tqdm

def slow_function(x):
time.sleep(1)
return x**2
results = [slow_function(x) for x in tqdm(range(100))]

и

from joblib import Parallel, delayed

# Обертка для распараллеливания
results = Parallel(n_jobs=4)(delayed(slow_function)(x) for x in tqdm(range(100)))


Как это работает:

🌟 Parallel(n_jobs) указывает, сколько процессов или потоков использовать. Например, при n_jobs=4 будут использоваться 4 ядра процессора, а при n_jobs=-1 — все доступные. Так что, если точно не знаете, какое число указать, попробуйте -1, т.к. если переборщить, код может не сработать🙈
🌟 delayed превращает функцию в "ленивую", откладывая её выполнение до тех пор, пока Parallel не передаст её в пул процессов.

Полезные ссылки:
🔗 Документация joblib
🔗 Репозиторий GitHub

Хорошей недели!❄️

#python@data_easy
GitHub GitHub - joblib/joblib: Computing with Python functions. Computing with Python functions. Contribute to joblib/joblib development by creating an account on GitHub.
  • 🔥 12
  • 👍 10
  • ❤ 8
Post #191 1.18K
И для тех, кого нет в чатике - держите ссылку на хакатон ЕВРАЗа 3.0, который организуют мои знакомые🧑‍💻

🦾 Задача хакатона — создать ИИ-чатбота, который будет помощником для нас, разработчиков:) Кстати, можно участвовать не только дата-саентистам — решать задачу можно на Python, TypeScript или C#.

📆 Даты: 29 ноября – 1 декабря 2024.

🕺 Формат: гибридный (онлайн и офлайн).

💷 Призовой фонд: 500.000 рублей.

Если нет команды — организаторы помогут ее собрать!

🔸 Регистрация уже открыта! Подавайте заявку до 25 ноября 23:59 МСК по ссылке.
хакатоневраза.рф ХАКАТОН ЕВРАЗА 3.0 Упрощай рутину, оставляй время на прорывные проекты — участвуй в хакатоне ЕВРАЗа!
  • 👍 6
  • ❤ 3
  • 🆒 1
Post #190 1K
Всем доброго дня!
По вашим просьбам собрала небольшой чек-лист самых популярных методов регуляризации😎
Главное, запомнить, что понятие регуляризации включает в себя не только L1 и L2, а целый класс методов для борьбы с переобучением😁

#classic_ml@data_easy
Telegraph Регуляризация в ML Регуляризация — это набор методов, которые помогают моделям лучше обобщать данные и избегать переобучения. Переобучение происходит, когда модель слишком хорошо подстраивается под обучающую выборку и теряет способность работать с новыми данными, которых ещё…
  • 🔥 12
  • 👍 5
  • ❤ 4
  • 😍 2
  • 🤝 1
Post #189
EasyData pinned «В последнее время к каналу присоединилось довольно много новых подписчиков😊 Чтобы нам всем было проще общаться в одном месте, а не только в комментариях к постам - приглашаю присоединиться к чату канала https://t.me/+v1fdmoHV3JwyYTJi Может, найдёте товарищей…»
Post #188 1.21K
В последнее время к каналу присоединилось довольно много новых подписчиков😊
Чтобы нам всем было проще общаться в одном месте, а не только в комментариях к постам - приглашаю присоединиться к чату канала https://t.me/+v1fdmoHV3JwyYTJi

Может, найдёте товарищей для хакатонов / друзей / будущих коллег😉
Telegram EasyData-chat Чат канала EasyData❤️
  • ❤ 12
  • 🔥 3
Post #178 1.39K
Всем доброго вечера!👋
На вопрос: "Какая самая популярная библиотека для анализа данных?" - большинство ответит: "Pandas". Однако, когда дело доходит до больших объёмов информации (порядка млн строк) или важна скорость работы - Pandas может оказаться не лучшим выбором❔

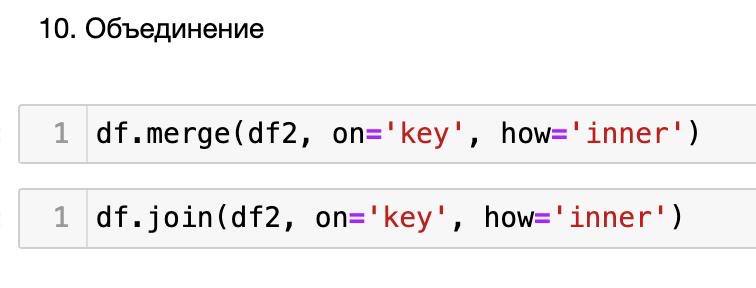
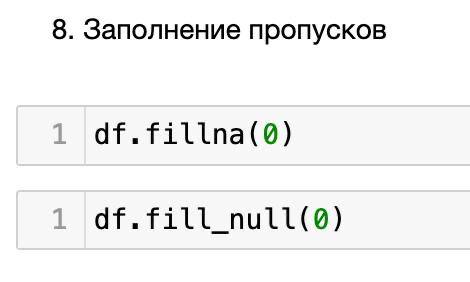
Ранее мы разбирали, как распараллелить операции на Pandas, но есть кое-что получше - ✨библиотека Polars✨ В WB часто ей пользуются, т.к. она действительно намного превосходит Pandas по скорости и эффективности. По синтаксису она где-то на ~70% похожа Pandas и ~30% на Pyspark, сравнение десяти самых важных операций ловите в карточках ❤️

Главные преимущества Polars:

✨ Написана на языке Rust, а он поддерживает многопоточность + использует память более эффективно.

✨ Polars поддерживает ленивые операции (Lazy Execution, эта же фича есть в pyspark), что позволяет "откладывать" их выполнение до тех пор, пока не будет вызвана команда .collect(). Благодаря этому можно оптимизировать выполнение сразу нескольких шагов, минимизируя нагрузку на память и процессор.

✨ Основной недостаток Pandas - то что он обрабатывает данные последовательно. Polars же без дополнительных "танцев с бубнами" может использовать несколько ядер процессора параллельно.

✨ Ещё одно следствие из первого пункта: Polars гораздо меньше расходует память. За счёт этого он может работать с большими данными на уровне, который просто недостижим для Pandas.

🐈 Ссылка на официальную документацию
🐈 Репозиторий на GitHub

#аналитика@data_easy
#classic_ml@data_easy
  • ✍ 7
  • 🔥 7
  • ❤ 3
  • 👍 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →