
Всем привет! 👋
Сегодня расскажу о магическом способе дообучить большие языковые модели (LLM), даже если у вас нет сервера с мощными видеокартами. Этот метод называется адаптеры.
Большие языковые модели вроде GPT или BERT уже натренированы на огромных объёмах текстов, но, разумеется, часто их необходимо "подстроить" под конкретные задачи. Например, представьте универсального переводчика, который знает 100 языков, но иногда путается в редких диалектах. Чтобы он стал идеален, ему потребуется донастройка.
🐾 Можно использовать классическое дообучение последних слоёв, однако этот подход часто ограничивает адаптацию. Он использует "универсальные" признаки из начала модели, которые могут быть недостаточно информативны для вашей специфической задачи.
А изменение всех весов, конечно, крайне дорогое для LLM с миллиардами параметров.
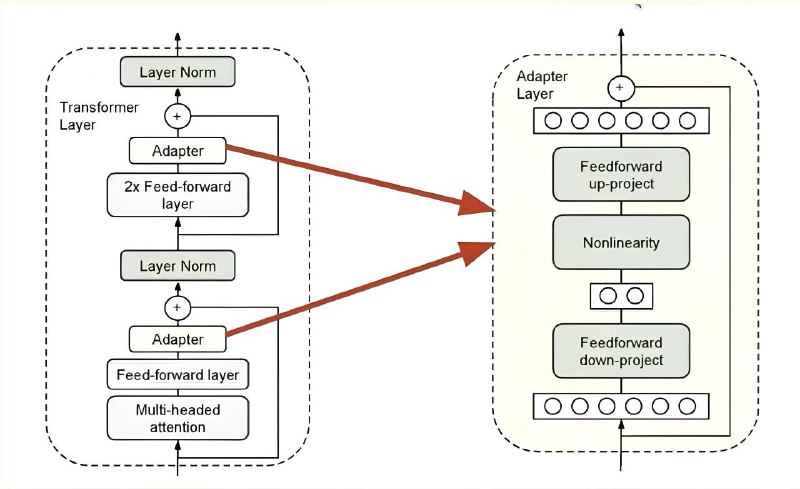
🙏 Адаптеры — это маленькие модули, которые вставляются между слоями уже обученной нейросети. Именно они обучаются на новой задаче, при этом исходные слои модели остаются неизменными (замороженными).
Если хотите попробовать, вот несколько инструментов:
😶 Hugging Face PEFT (Parameter-Efficient Fine-Tuning) — библиотека для адаптеров, LoRA и других методов.
🔗ссылка на документацию
🔗папка с примерами из официального репозитория
😶 AdapterHub — репозиторий готовых адаптеров для разных задач.
🔗 ссылка на страничку официального сайта
🔗 документация с примерами
Лёгкой рабочей недели! 😘
#nlp@data_easy
Post #196
1.19K
- 🔥 22
- ❤ 9
- 👍 9