مدلهای
VLM (Vision-Language Model) فقط تصویر و زبان رو ترکیب میکنن و هدفشون درک یا توضیح صحنههاست.
اما
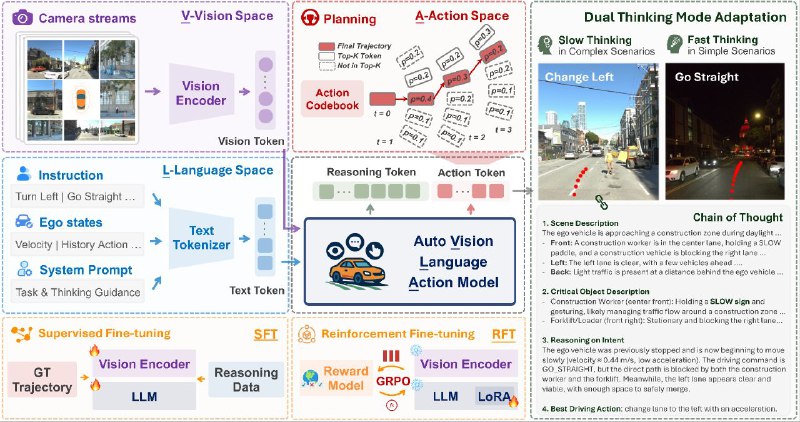
VLA (Vision-Language-Action)ها یه قدم جلوترن — اونها علاوه بر
دیدن و
فهمیدن،
اقدام هم میکنن؛ یعنی میتونن در محیط واقعی تصمیم بگیرن و عمل کنن.
🔹 تازهترین نمونه این دسته، مدل GigaBrain-0 هست:
مدلی پایهای برای رباتهای هوشمند که با استفاده از دادههای ساختهشده توسط world model (مثل ویدیوهای مصنوعی، انتقال از انسان یا شبیهساز به واقعیت) یاد میگیره.
به لطف این روش، دیگه لازم نیست حجم زیادی داده واقعی از رباتها جمعآوری بشه.
📈 نتیجه:
تعمیم بهتر بین وظایف مختلف
عملکرد قویتر در کارهای پیچیده و بلندمدت
تصمیمگیری پایدارتر
نسخه سبکترش، GigaBrain-0-Small هم برای سختافزارهایی مثل NVIDIA Jetson AGX Orin بهینه شده.
💡 خلاصه: GigaBrain-0 گام بزرگیه به سمت رباتهایی که مثل انسان میبینن، میفهمن و عمل میکنن.
https://huggingface.co/open-gigaai#vla #vlm