TGViewer
Channel Public Channel
Tensorflow(@CVision)

Tensorflow(@CVision)

@cvision

اخبار حوزه یادگیری عمیق و هوش مصنوعی
مقالات و یافته های جدید یادگیری عمیق
بینایی ماشین و پردازش تصویر

TensorFlow, Keras, Deep Learning, Computer Vision

سایت:
http://class.vision

👨‍💻👩‍💻پشتیبان دوره ها:
@classvision_support

لینک گروه:
@tf2keras
Subscribers
15.1K
Photos
1.3K
Videos
318
Links
2.6K

Showing posts older than #4243 · Back to latest

Older Posts 20 shown
Post #4242 5.61K
دیاگرام بکشید، هوش مصنوعی کدش رو بزنه:

AgentKit

thenewstack.io/openai-launches-a-no-code-agent-builder

محصول جدید OpenAI، یعنی AgentKit، یک ابزار سازنده ایجنت بدون کد است که به توسعه‌دهندگان و شرکت‌ها امکان ساخت و استقرار سریع سیستم‌های چند ایجنتی را می‌دهد.
همچنین، Apps in ChatGPT به کاربران اجازه می‌دهد تا برنامه‌های شخص ثالث، مانند Zillow، را مستقیماً از طریق رابط چت‌جی‌پی‌تی فراخوانی و با آنها تعامل داشته باشند.
The New Stack OpenAI Launches a No-Code Agent Builder At its developer conference in San Francisco, OpenAI beta launched AgentKit, a no-code agent builder, and the ability to invoke third-party apps in ChatGPT.
  • ⚡ 8
  • ❤‍🔥 2
  • 👍 2
  • ❤ 1
Post #4241 4.91K
بابا منظورم به زبان فارسی بوده. وقتی کد میفرستم چرا از ادبیات آزمون باید طرح کنه😐😩
  • 👀 13
  • 🤯 3
  • ❤ 2
  • ❤‍🔥 1
  • ⚡ 1
  • 🤔 1
Post #4240 5.43K
Post #4238 4.44K

Forwarded from آموزش LLM و VLM

امروز نسخه سبکتر Qwen3-VL رو منتشر شد!

امروز، ۴ اکتبر ۲۰۲۵، تیم Qwen دو مدل جدید از خانواده Qwen3-VL رو منتشر کرد:
مدل Qwen3-VL-30B-A3B-Instruct
و Qwen3-VL-30B-A3B-Thinking
به‌همراه نسخه‌ی FP8 برای هر دو مدل که حجم و مصرف حافظه رو به‌طور قابل‌توجهی پایین میاره.

تا قبل از این، Qwen3-VL فقط مدل‌های خیلی سنگین داشت و عملاً نسخه‌ای سبک یا بهینه برای استفاده عمومی نداشت. حالا با این نسخه FP8 و تنظیمات جدید، بالاخره میشه مدل‌های Qwen3-VL رو راحت‌تر روی GPUهای معمولی هم بالا آورد.

🔹 نسخه Instruct بیشتر برای کارهای گفت‌وگومحور و دستورمحور طراحی شده.
🔹 نسخه Thinking روی استدلال پیچیده و فهم عمیق‌تر تصویر و ویدیو تمرکز داره.

هر دو مدل از فهم متن و تصویر پشتیبانی می‌کنن، OCR قوی دارن (تا ۳۲ زبان)، و حتی می‌تونن از روی تصویر کد HTML یا JS بسازن!
پشتیبانی از context طولانی (تا ۱ میلیون توکن) هم داره — چیزی که برای پروژه‌های چندرسانه‌ای واقعاً غنیمته.

📦 https://github.com/QwenLM/Qwen3-VL
  • 👍 12
  • ❤ 1
  • ❤‍🔥 1
  • 🔥 1
Post #4237 4.45K
دنیایی از منابع برنامه‌نویسی توی این کانال بصورت دسته‌بندی شده با هشتگ بصورت روزانه قرار داده میشه.

@pythony
  • ❤ 7
  • ❤‍🔥 1
  • 🔥 1
Post #4236 4.62K
🌟 آموزش مدل‌های زبانی-تصویری (VLM) منتشر شد🎉


مدل‌های زبانی-تصویری (VLM) نسل جدیدی از مدل‌های مولد هستن که علاوه بر متن، تصویر رو هم می‌فهمن. یعنی می‌تونن عکس رو توصیف کنن، به سوال درباره‌ی محتواش جواب بدن و حتی بین متن و تصویر ارتباط برقرار کنن.

📚 در این دوره یاد می‌گیرید:

- ساختار و معماری مدل‌های VLM

- کاربردهای جذاب مثل پرسش‌وپاسخ تصویری و مولتی‌مودال

- نحوه‌ی آموزش و به‌کارگیری این مدل‌ها در پروژه‌های واقعی

🎁 تخفیف ویژه 70٪ با کد زیر:

COUPON-c4cd3

🔥 برای اطلاع از  کدهای تخفیف، همین حالا عضو کانال تلگرام ما بشید:
👇👇👇
@llm_huggingface
👆👆👆

🎓ما رو تو اینستاگرام هم دنبال کنید...

https://www.instagram.com/class.vision

🔗 مشاهده دوره:
https://mktb.me/e3gx/
  • ❤ 5
  • ❤‍🔥 1
  • 👍 1
  • 🔥 1
Post #4233 4.5K
▪️ اشنایی با مقالات و منابع هوش مصنوعی و علوم پزشکی

✅ @AI_DeepMind
  • ❤ 3
  • ❤‍🔥 1
  • 🔥 1
Post #4231 4.8K

Forwarded from آموزش LLM و VLM

کد تخفیف 70 درصدی تست شده

فقط موقع استفاده حتما تیک دسترسی کامل را بردارید، اگر قبلا در سبد خرید بوده حذف کرده و مجدد با برداشتن این تیک به سبد خرد خود اضافه کنید.

COUPON-c4cd3

https://mktb.me/e3gx/
  • 🤔 6
  • ❤ 3
  • ❤‍🔥 1
  • 🔥 1
Post #4230 3.61K

Forwarded from آموزش LLM و VLM

🌟 آموزش مدل‌های زبانی-تصویری (VLM) با تدریس علیرضا اخوان‌پور منتشر شد🎉

مردادماه دوره‌ی مدل‌های زبانی بزرگ (LLM) در مکتب‌خونه منتشر شد؛ دوره‌ای که توش یاد می‌گرفتید مدل‌هایی مثل ChatGPT یا Gemini چطور آموزش می‌بینن، چطور کار می‌کنن و چطور می‌تونن به زبان‌های مختلف – حتی فارسی – پاسخ بدن و ...

♨️حالا نوبت یکی از داغ‌ترین موضوعات دنیای AI رسیده:
🔹 مدل‌های زبانی-تصویری (VLM)

مدل‌های زبانی-تصویری (VLM) نسل جدیدی از مدل‌های مولد هستن که علاوه بر متن، تصویر رو هم می‌فهمن. یعنی می‌تونن عکس رو توصیف کنن، به سوال درباره‌ی محتواش جواب بدن و حتی بین متن و تصویر ارتباط برقرار کنن.

📚 در این دوره یاد می‌گیرید:

- ساختار و معماری مدل‌های VLM

- کاربردهای جذاب مثل پرسش‌وپاسخ تصویری و مولتی‌مودال

- نحوه‌ی آموزش و به‌کارگیری این مدل‌ها در پروژه‌های واقعی

👨‍🏫 تدریس هر دو دوره توسط مهندس علیرضا اخوان‌پور انجام شده


🔗 مشاهده دوره:
https://mktb.me/e3gx/
  • 👍 3
  • ❤ 1
  • ❤‍🔥 1
  • 🔥 1
Post #4229 3.14K

Forwarded from آموزش LLM و VLM

🎉 دوره جدید منتشر شد:

آموزش مدل‌های زبانی-تصویری (VLM):
از درک تصویر و ویدیو تا فاین‌تیون پیشرفته 🚀

🎁 تخفیف ویژه 70٪ با کد زیر:
COUPON-c4cd3


🔗 تهیه دوره:
https://mktb.me/e3gx/
~~~~~~~
اطلاعات بیشتر
~~~~~~~
🔥 برای اطلاع از  کدهای تخفیف، همین حالا عضو کانال تلگرام ما بشید:
👇👇👇
@llm_huggingface
👆👆👆

🎓ما رو تو اینستاگرام هم دنبال کنید...

https://www.instagram.com/class.vision
  • ❤ 6
  • 👍 2
  • 🔥 1
Post #4228 3.83K
Yolo26 و Edge device

به‌تازگی پیش‌نمایش YOLO26 توسط Ultralytics منتشر شد — و به‌نظر می‌رسه یک نقطه عطف در بینایی real-time باشه...
مدل‌های فعلی معمولاً:
❌ سنگین
❌ وابسته به GPU
❌ سخت برای اجرا روی دستگاه‌های edge


🔑 چی باعث تفاوت YOLO26 میشه؟
1️⃣ End-to-End، بدون NMS → دیگه خبری از Non-Maximum Suppression نیست. پیش‌بینی‌ها مستقیم از شبکه میان.
2️⃣ استقرار ساده‌تر → حذف Distribution Focal Loss (DFL). خروجی راحت به ONNX، TensorRT، CoreML، TFLite و OpenVINO.
3️⃣ بهینه‌ساز MuSGD → ترکیبی از SGD + Muon (الهام‌گرفته از آموزش LLMها). پایدارتر، همگرا سریع‌تر.
4️⃣ تشخیص بهتر اجسام کوچک → با ProgLoss + STAL عملکرد قوی‌تر برای پهپادها، IoT، رباتیک و نظارت.
5️⃣ تا ۴۳٪ سریع‌تر در inference روی CPUها.

📦 یک فریم‌ورک، وظایف متعدد
YOLO26 از Detection، Segmentation، Pose، Classification و Oriented Object Detection (OBB) پشتیبانی می‌کنه.


🏁 جمع‌بندی

✅ پیچیدگی کمتر
✅ قابلیت استقرار بیشتر
✅ سرعت بالاتر روی CPU
✅ الهام‌گرفته از دستاوردهای LLM


🔗https://docs.ultralytics.com/models/yolo26/

#yolo #yolo26 #edge #ultralytics
  • 🔥 15
  • ❤ 2
  • 👍 2
Post #4226 3.36K

Forwarded from آموزش LLM و VLM

🎉 دوره جدید منتشر شد:
آموزش مدل‌های زبانی-تصویری (VLM): از درک تصویر و ویدیو تا فاین‌تیون پیشرفته
از درک تصویر و ویدیو تا فاین‌تیون پیشرفته 🚀

📚 در 4 فصل:
1️⃣ آشنایی با مدل‌های مولتی‌مدال (CLIP تا SigLIP)
2️⃣ کاربرد VLM در درک تصویر و ویدیو
3️⃣ فاین‌تیون و پروژه‌های تخصصی
4️⃣ آموزش پیشرفته با DPO، GRPO و MPO

🔑 ویژگی‌های کلیدی:
✔️ معرفی روش‌ها و مدل‌های جدید مثل MPO و FASTVLM اپل
✔️ استفاده از HuggingFace و Unsloth
✔️ بیش از 15 کد عملی همراه توضیح کامل

🎁 تخفیف ویژه 70٪ با کد زیر:
COUPON-c4cd3


🔗 تهیه دوره:
https://mktb.me/e3gx/

کانال تلگرامی دوره | کانال تلگرام کلاس‌ویژن | کدهای دوره
اسلایدهای دوره | کوئیزهای دوره | تمرین+پروژه
مکتب‌خونه آموزش مدل‌های زبانی-تصویری (VLM): از درک تصویر و ویدیو تا فاین‌تیون پیشرفته هدف دوره این است که شما نه تنها مفاهیم را یاد بگیرید، بلکه بتوانید بلافاصله آن‌ها را در پروژه‌های واقعی پیاده‌سازی کنید. دوره شامل 15 نوت‌بوک عملی (Jupyter Notebook) آماده اجراست – بدون نیاز به نصب پیچیده است.
  • ❤ 12
  • 👍 3
  • 🔥 1
Post #4224 4.45K
Post #4223 4.63K
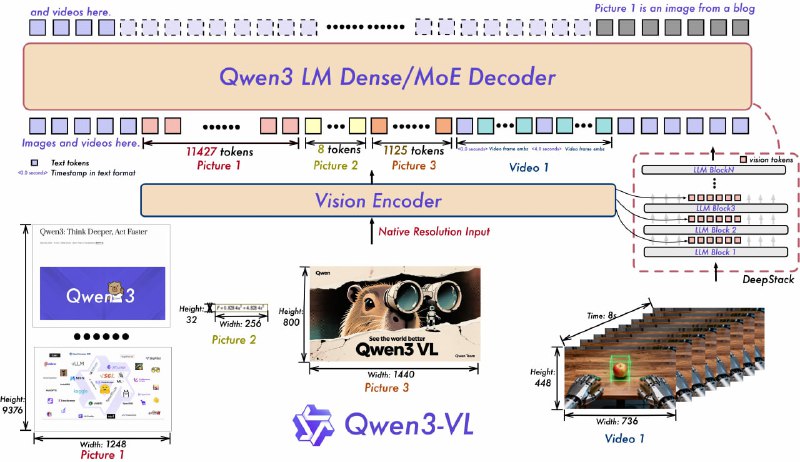
مدل مولتی مدال Qwen 3-VL منتشر شد:


این VLM همون توانایی‌های Qwen2.5 VL مثل درک ویدیو و تصویر و چارت و ... را داره، ولی خیلی دقیق‌تر، با حافظه خیلی بلندتر، و از همه مهمتر با قابلیت عامل‌محور (Agentic) قوی‌تر.

Blog:
https://qwen.ai/blog?id=99f0335c4ad9ff6153e517418d48535ab6d8afef&from=research.latest-advancements-list

Github:
https://github.com/QwenLM/Qwen3-VL
GitHub GitHub - QwenLM/Qwen3-VL: Qwen3-VL is the multimodal large language model series developed by Qwen team, Alibaba Cloud. Qwen3-VL is the multimodal large language model series developed by Qwen team, Alibaba Cloud. - QwenLM/Qwen3-VL
  • ❤ 11
  • 🔥 1
Post #4222 5.11K
گوگل در تحقیق جدیدی، روشی به نام In-Context Fine-Tuning (ICF) معرفی کرده است که با استفاده از آن، مدل پیش‌بینی سری زمانی TimesFM می‌تواند به صورت few-shot، یعنی با تعداد کمی نمونه در زمان اجرا (inference)، تنظیم شود؛ بدون نیاز به آموزش مجدد جداگانه برای هر مجموعه داده.


در هنگام پیش‌بینی، چند سری زمانی مشابه (به عنوان «نمونه کمکی») همراه با داده هدف به عنوان ورودی به مدل داده می‌شوند، و مدل با توجه به این مثال‌ها خود را تطبیق می‌دهد.

در بنچمارک‌هایی که داده‌ها از توزیع متفاوت بودند، مدل جدید عملکردی معادل آموزش تحت نظارت (supervised fine-tuning) داشت و نسبت به نسخه پایه TimesFM بهبود ۶٫۸٪ در دقت نشان داد.

عدم نیاز به پیاده‌سازی و نگهداری چرخه‌های آموزش مخصوص برای هر دیتاست، کاهش هزینه‌های عملیاتی و ساده‌تر شدن استقرار مدل‌ها در محیط‌های چند کاربری و متغیر از جمله مزیتهای این روش است.

https://research.google/blog/time-series-foundation-models-can-be-few-shot-learners/

https://icml.cc/virtual/2025/poster/43707
  • ❤ 18
  • 🔥 2
  • 👍 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →