
Почему мы решили выкинули готовый LLM-прокси и написали свой gateway
LiteLLM закрывает 90% задач прокси к LLM, но мы упёрлись в оставшиеся 10% и они оказались всей сутью нашего продукта.
Сначала коротко, о чём вообще речь.
Когда в компании больше одного человека ходит в модели, между людьми и провайдером ставят прокси, один вход, через который идут все запросы.
Он раздаёт ключи, роутит на нужного провайдера, считает расход, пишет логи.
LiteLLM самый популярный такой прокси, и он хорош.
Мы делаем систему безопасности для LLM: маскирование персональных данных, детекция prompt injection, инциденты, политики.
И жила она набором плагинов внутри этого прокси.
Логика была нормальная: не писать чужую работу заново. Полгода это работало. Потом перестало, и не по одной причине, а по трём.
1️⃣Перекладывание между протоколами теряет то, чего нет в целевом формате.
Клиенты говорят на разных протоколах: Chat Completions, Responses, Anthropic Messages. Прокси приводит их к одному виду, чтобы отправить дальше.
Одно обновление прокси поменяло режим этой перекладки и запросы стали терять reasoning-контекст. За двое суток это дало сотни ошибок «connection lost» у живых пользователей.
Дефект починили, но вывод остался: перекладка это не бесплатная операция.
Она должна быть отдельной функцией со своими тестами и явным списком того, что теряется, а не режимом по умолчанию, который меняется в чужом релизе.
2️⃣ Наше маскирование ломало кеш провайдера, и мы это не контролировали.
Провайдеры кешируют вход по совпадающему префиксу: если начало запроса такое же, как в прошлый раз, вы платите за него в разы меньше.
В нашем трафике больше 90% входа шло из кеша. На этом держится вся экономика.
А маскирование подменяет персональные данные на плейсхолдеры: [PII_1], [PII_2]. И у нас они нумеровались справа налево.
Значит, каждое новое упоминание имени или телефона в конце диалога сдвигало нумерацию во всём префиксе.
Префикс переставал совпадать с прошлым запросом и кеш промахивался целиком.
Функция безопасности молча ломала экономику. Пока она была плагином, никто и не смотрел на неё с этой стороны: у прокси свои метрики, у плагина свои.
3️⃣ Плагин видит запрос кусками, а там появляются слепые зоны.
Плагин получает не запрос, а то, что ему отдаёт хост: в своём формате, в свой момент, отдельно на каждом протоколе.
Поэтому наша проверка ветвилась по протоколам. И однажды выяснилось, что инспекция вложений работает на одном пути и не работает на другом.
Это не баг плагина и не баг прокси. Это следствие того, что у безопасности нет собственного представления запроса.
Отсюда решение.
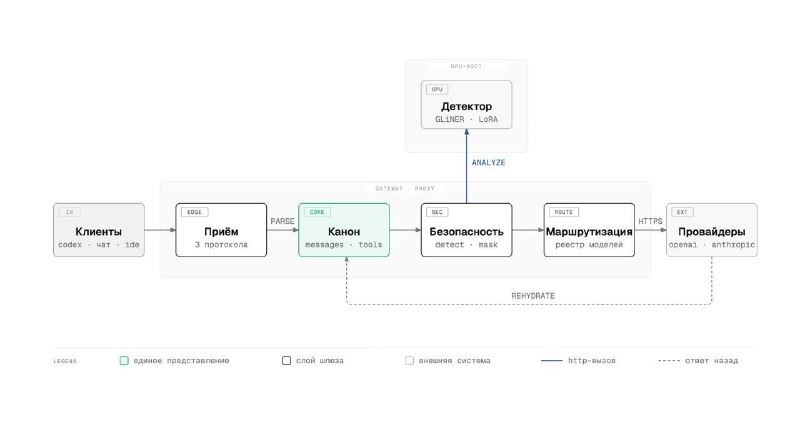
Мы собрали свой gateway, где внутри есть каноническое представление запроса. Три протокола на входе приводятся к одному виду, слой безопасности работает только с ним, а специфика протокола живёт в адаптерах на краях.
Проверка перестала знать, по какому протоколу пришёл клиент и слепые зоны закрылись не тестами, а устройством.
Теперь про цену.
Свой gateway про перенос ответственности на себя.
Мы взяли роутинг, повторы, фолбэк, учёт токенов, совместимость с клиентами и
поддержку всего этого. Чужой прокси развивался без нас, а наш - только нашими руками.
Поэтому переезд делали с подстраховкой:
- новый шлюз сначала стоял рядом и получал копию каждого запроса, а его ответ
сравнивался со старым по статусу, содержимому и порядку событий стрима
- пара служебных эндпоинтов реализована в формате старого прокси, чтобы не менять мониторинг одновременно с переездом
- ключи перенесены так, что пользователи ничего не настраивали
- старый прокси остался поднятым, откат это просто возврат одного правила маршрутизации
Правило, которое я бы отсюда вынес.
Если ваша логика поверх LLM наблюдающая - логи, лимиты, роутинг, учёт денег, то берите готовый прокси и не выдумывайте.
Если ваша логика меняет содержимое запроса и ответа и отвечает за результат: маскирует, блокирует, переписывает, то она должна быть частью системы, а не
плагином к ней.
Признак, что пора: ваша фича обязана работать на каждом пути одинаково, а вы регулярно узнаёте, что где-то она не сработала.
Post #89
171
- 🔥 4
- 🥰 1