
Код теперь пишут все. В том числе те, кто не умеет его читать.
Вайб-кодинг вышел за пределы разработки: прототип собирает аналитик, внутреннюю утилиту менеджер, интеграцию - тот, кому она понадобилась. Модель выдаёт рабочий код за десять минут, но не отвечает за то, что в нём осталось: зашитый ключ, библиотека с известной CVE, бакет, открытый на чтение всем, неизвестные нам ИИ инструменты и их вызовы.
Раньше между написанием кода и выпуском в прод стоял человек, который читает код. Теперь его там может не быть.
Прогнать SAST руками, посмотреть отчёт, закрыть это разовая процедура. А код появляется постоянно и во всех проектах сразу, не только в коммерческих. Представим, что их 50: нужен другой уровень абстракции, проверять весь портфель, всеми видами проверок, регулярно и без участия человека в запуске.
Что сделал
secguard - агент, который сканирует, и платформа, которая держит на нём весь портфель проектов.
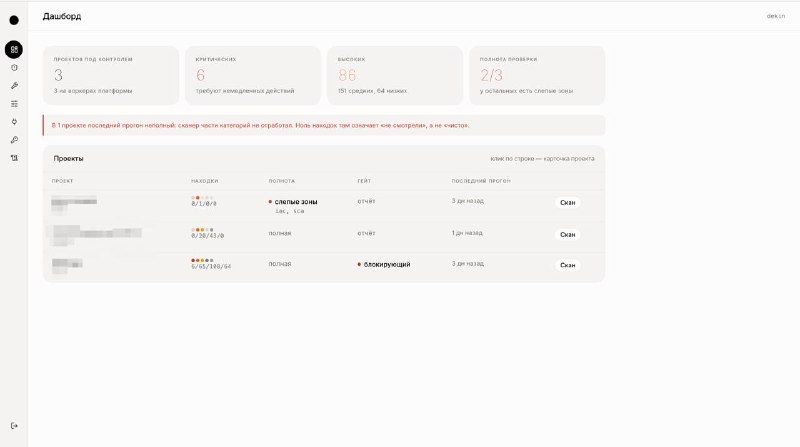
AppSec открывает один экран и видит все проекты: где что нашли, что появилось за неделю, что вернулось после исправления. Сканы идут по расписанию и не надо ходить по командам, спрашивать, дошли ли руки, и контролить ТЛ на предмет внедрения сканеров.
Что проверяем
SAST - semgrep.
Секреты - gitleaks, включая историю git.
SCA - trivy.
IaC - trivy и checkov: Dockerfile, Kubernetes, Terraform.
Образы - trivy по tar, который выгружает демон воркера.
DAST - OWASP ZAP на живом стенде.
Порты и TLS после деплоя проверяет свой сканер на сокетах.
Отдельно AI BOM: какие модели реально вызывает код, какие MCP-серверы подключены, совпадает ли это с задекларированным. Ровно та проблема, с которой пост начинался, это когда вызов модели приезжает в проект, и знает о нём только автор.
Агент живёт на стандартной библиотеке: единственная зависимость это парсер YAML. Инструменту, который проверяет чужие зависимости, свои приносить не очень круто.
Как боремся с шумом
Четыре механизма, и все работают в одну сторону — снижают строгость, а не повышают:
• fingerprint: версионированный отпечаток по сканеру, правилу, файлу, строке и дискриминатору категории. Идентичность находки: по нему она живёт между прогонами и не задваивается, когда сдвинулись строки;
• baseline: гейт считает только появившееся после снимка, иначе легаси краснеет вечно и его перестают смотреть;
• reachability: для SCA помечаем, достижим ли уязвимый пакет из первопартийного кода. Недостижимые можно не пускать в гейт;
• LLM-триаж умеет ровно одно - пометить находку ложной. Поднять важность или уронить сборку не может: вердикт считает детерминированный движок по порогам.
Что делаем с находками
Блокируем merge, сами пороги задаёт AppSec в платформе, а не команда у себя.
Предлагаем патч: платформа генерирует исправление, применяет на своей копии, прогоняет тесты проекта. Человек смотрит diff и решает, после одобрения делается ветка и MR. Мержить платформа не умеет, это остаётся ревьюеру.
Ведём жизненный цикл: принять риск можно только с обоснованием и сроком, по истечении находка сама возвращается в работу.
Что в итоге изменилось
Раньше хватало одного занятого спринта, чтобы проект выпал из-под контроля и никто не заметил. Теперь проверка не зависит ни от кого.
Чужой код мы считаем недоверенным: скан идёт без сети вовсе, а тесты проекта при проверке патча запускаются в отдельном контейнере, где нет ни сети, ни ключей.
Главное правило, которое не даём обойти: пустой результат не считается чистым. Упал сканер значит категория помечается слепой зоной, сборка краснеет, а находку из неё нельзя объявить исправленной.
Замечен любопытный дефект: у semgrep код возврата 1 означает и найдены проблемы, и сканер упал, а значит авария SAST выглядела как чистый прогон.
Цифры
Боевой прогон небольшого проекта(вайбкодерского): 146 находок, 19 высокой важности, шесть минут на средний репозиторий. Отчёт это один HTML без внешних запросов: открывается из артефактов CI без интернета. 636 тестов.
Дальше подключаем остальной портфель и смотрим на шум. Только после этого включаем блокировку: инструмент, который валит пайплайн на ложных срабатываниях.
Post #78
181


- 👍 7
- ❤ 1