TGViewer
Channel Public Channel
Время Валеры

Время Валеры

@cryptovalerii

Мне платят за то, что я говорю другим людям что им делать.
Автор книги https://www.manning.com/books/machine-learning-system-design
https://venheads.io
https://www.linkedin.com/in/venheads
Subscribers
30.8K
Photos
232
Videos
9
Links
468
Recent Posts 19 shown
Post #1002 8.25K
На днях начал делать ревью А/Б-платформы от Три сигма, позавчера отправил им 9 уточняющих вопросов, и пока они отвечают, попросили прорекламировать их митап в Ташкенте.

На что я говорю: так вы ответьте на вопросы, я в одном посте разбор проведу и заодно про митап расскажу.

Говорят, не успевают, митап уже скоро.

1 октября у них митап в Ташкенте
Data-Driven – от данных к действиям
  • 😁 198
  • ❤ 12
  • 💩 7
  • 🔥 6
  • 🤮 2
Post #1000 21.4K
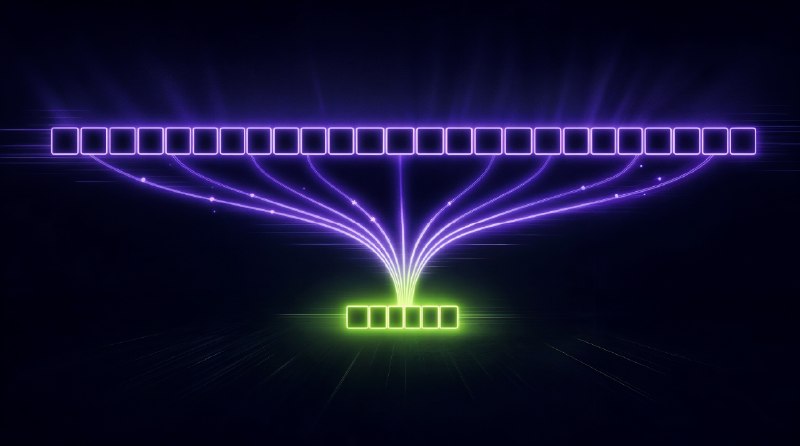
Прочитал отличную заметку Shopify про gisting — сжатие системного промпта в обучаемые токены.

По сути, это компиляция промпта.

У GraphQL-агента Sidekick системный промпт занимал около 6 000 токенов, которые постоянно приходилось обрабатывать снова и снова.

Prefix caching решает проблему лишь частично. Модели не нужно повторно вычислять KV cache для промпта, но при генерации каждый новый токен всё равно работает со всем контекстом. Чем длиннее промпт, тем больше памяти и времени требуется на каждый шаг декодирования. Придумали логичную штуку применить: gisting

Как работает gisting.
Сначала Shopify выбрали коэффициент сжатия 4:1(это гиперпараметр) и создали 1 500 новых специальных токенов вместо 6 000 исходных.

Эти токены не были выбраны из системного промпта и не являлись его текстовым summary. Это просто новые ID вроде <GIST_1>, <GIST_2> и так далее.

Дальше:
* Все веса модели замораживаются. Обучаются только эмбединги новых gist-токенов.
* Teacher-версия модели получает полный системный промпт, запрос пользователя и начало правильного ответа. На каждой позиции она выдаёт распределение вероятностей следующего токена.
* Student-версия той же самой модели получает тот же запрос и ответ, но вместо 6 000 токенов системного промпта видит 1 500 gist-токенов;
* Распределения teacher и student сравниваются через KL divergence.
* Градиент меняет только эмбединги gist-токенов, пока student не начинает выдавать практически те же распределения ответов, что и teacher.
* Изначально новые эмбединги можно было бы задать случайно. Но Shopify нашли более эффективную инициализацию: исходный промпт разделили на группы по четыре токена, а каждый gist-embedding инициализировали средним значением эмбедингов соответствующей четвёрки. Это снизило начальный loss в семь раз.

При этом <GIST_1> не становится сокращённым обозначением первых четырёх токенов. Все 1 500 embeddings обучаются совместно и в итоге кодируют не текст промпта, а его влияние на поведение модели.

Получаем сжатие поведения: модель учат реагировать на короткую последовательность обучаемых векторов так же, как на длинную текстовую инструкцию.

В результате примерно 6 000 обычных токенов превратились в 1 500 обученных токенов. Модель ведёт себя так, будто прочитала полный промпт, хотя фактически получает его сжатое представление.

После обучения никакой отдельной архитектуры не требуется. Эмбединги записываются в embedding matrix, токены регистрируются в tokenizer, а длинный промпт при запросе просто заменяется их последовательностью. Нет дополнительного encoder, специального attention mask или отдельного serving path.

Результаты при нагрузке 350 запросов в минуту:
— time to first token: с 438 до 354 мс, −19%;
— полная задержка: с 6,8 до 4,2 секунды, −38%;
— throughput: с 20,2 до 23,4 запроса в секунду, +16%;
— требуемое количество GPU: −14%.
Качество при этом не ухудшилось.

Как они подбирали рецепт: Autoresearch-цикл сам менял гиперпараметры, запускал обучение и оценивал результат.

Так нашли оптимальное сжатие 4:1. При дальнейшем уменьшении количества gist-токенов качество начинало падать. Для другой модели, промпта и предметной области граница будет другой.
Предварительный расчёт teacher logits и токенизация сократили один обучающий прогон с 30 до 6 часов.

Оказалось также, что усреднение функции потерь по токенам ответа приводило к галлюцинациям, а усреднение по batch сохраняло больше сигнала от длинных ответов. Хорошее напоминание, что даже в относительно простой оптимизации детали функции потерь могут полностью изменить поведение системы.

Prompt engineering постепенно превращается в обычный ML engineering.
Системный промпт можно рассматривать как исходный код, а gist-токены — как его скомпилированную версию. Здесь всё знакомо: датасет, distillation, loss, evaluation, нагрузочное тестирование, мониторинг качества и стоимости.
#ArticleReview
Shopify Gisting: Compressing LLM Agent context to ↑ throughput and ↓ cost (2026) - Shopify Gisting compresses context into a set of learned tokens, preserving its quality while making the model faster and cheaper.
  • 👍 139
  • ❤ 39
  • 🤯 17
  • 🔥 9
  • 🥴 8
  • 👏 2
Post #999 17.7K
На основе пятничного поста про промт:
Сожми документ максимально, не потеряв никакой информации.

Превратили этот подход в отдельный open-source skill — lossless-doc-compress.

Скилл читает документ целиком и относит каждый фрагмент к одной из трёх категорий:

KEEP — содержит информацию и остаётся без изменений;
REMOVE — доказуемо избыточен и удаляется;
FLAG — требует решения автора, поэтому остаётся в документе с пометкой.

Он удаляет filler, пустой hedging, LLM-slop, дословные повторы и избыточные формулировки. Сохраняет факты, цифры, решения, оговорки, ограничения, названия систем, код и таблицы.

Если есть сомнение — не удалять, дает отметку для автора

Результат: три артефакта:
Сжатый документ.
Лог всех удалений и спорных мест.
Scorecard: число слов до/после, процент сокращения и подтверждение сохранности содержания.

npx skills add ML-SystemDesign/MLSystemDesign
Код и инструкция:
https://github.com/ML-SystemDesign/MLSystemDesign/tree/main/skills/lossless-doc-compress

Это пост был прогнан через скилл
GitHub MLSystemDesign/skills/lossless-doc-compress at main · ML-SystemDesign/MLSystemDesign Contribute to ML-SystemDesign/MLSystemDesign development by creating an account on GitHub.
  • 🔥 161
  • 💅 35
  • 😁 24
  • 👍 16
  • ❤ 14
  • 👎 3
Post #998 15K
☁☁☁☁☁☁☁

24 сентября Yandex Cloud проведёт флагманскую технологическую конференцию — Yandex Scale 2026.

🎨🎨🎨🎨🎨🎨🎨🎨🎨🎨
🎨🎨🎨🎨🎨🎨🎨🎨🎨🎨
🎨🎨🎨🎨🎨🎨🎨🎨🎨
В программе четыре продуктовых трека — AI, Data, Security и Hybrid Infrastructure & DevOps, — и отдельный углублённый технологический трек DeepTech, который пройдёт только онлайн.

🎨🎨🎨🎨🎨🎨🎨🎨🎨🎨
🎨🎨🎨🎨🎨🎨🎨🎨🎨🎨
🎨🎨🎨🎨🎨🎨🎨🎨🎨
В треке DeepTech откроем программу докладом о том, как мы ускорили Lua в Valkey — добавили LuaJIT и Lua 5.5 без патчей интерпретатора и получили прирост скорости до 2–5 раз. Расскажем, как строим экономически эффективный инференс LLM для агентских сценариев в Yandex AI Studio — на примере DeepSeek-V3.2 и DeepSeek-V4-Flash. Разберём, что разваливается в поиске, когда он должен быть одновременно распределённым, транзакционным и линейно масштабируемым — на примере векторного, полнотекстового и гибридного поиска в YDB. Покажем, какая инфраструктура превращает недетерминированную модель в управляемый и наблюдаемый сервис, когда агент выходит из демо в продакшн. Расскажем, как мы первыми в РФ научились мониторить ИИ-агентов внутри «чёрного ящика» LLM. И заглянем под капот сети облака — Interconnect, Private Link, Inbound DNS и DNS Firewall, которые складываются в герметичный контур между Yandex Cloud, on-premises и другими облаками.

🎨🎨🎨🎨🎨🎨🎨🎨🎨🎨
🎨🎨🎨🎨🎨🎨🎨🎨🎨🎨

Плюс демозоны, питчинг решений, IT-квест и мерч для тех, кто в Москве. А кто смотрит онлайн, помимо трека DeepTech, есть ещё отдельная онлайн-студия: розыгрыш призов и секретный гость.


Полную программу можно посмотреть на сайте, там же — зарегистрироваться. Участие бесплатное
  • 💩 297
  • 👎 50
  • 🤮 36
  • ❤ 19
  • 👍 11
  • 🔥 6
Post #997 18K
После ревью документов сегодня (один из дизайнов был на 51 страници!) даю совет всем, кто готовит документацию, пишет дизайн-доки и т. п.

1. То, что это написал агент/LLM, — не проблема, если вы это прочитали, поправили, дали контекст и т. д. Считайте, что отдали работу по редактуре. Если делегировали думать, получается чаще ерунда.

2. Прогоните свой документ через простую команду: «compress this as much as possible without losing any information» — обычно сокращает где-то в 2 раза (и заодно чистит часть слопа).

Всем хорошо: вам, ревьюерам, команде, моделям.
  • 👍 336
  • 😁 66
  • ❤ 41
  • 🌭 12
  • 🔥 11
  • 💯 7
  • 👎 2
  • 💅 2
Post #995 20.4K
Две первые главы книги «Agentic AI System Design» уже написаны и сейчас находятся на ревью у соавторов.

Один соавтор тот же: https://t.me/partially_unsupervised
Два — с курса по ML System Design.

По отзывам вышло неплохо:
Прочитал с кайфом и даже взял на вооружение


Надеюсь, к концу года допишем.
Telegram partially unsupervised @arsenyinfo пишет про software engineering и machine learning
  • 🤡 186
  • 👍 132
  • 🔥 48
  • ❤ 31
  • 😁 4
  • 🥰 2
  • 👎 1
  • 🙏 1
  • 👨‍💻 1
Post #994 62.9K
3 года назад я рассказывал про сказочника в своем посте

Но тот случай был хотя бы безвредным, да и, прочитав это, сказочник быстро убрал свои фантазии.

На днях в местах, где я живу, произошла история более печальная и более масштабная со всех сторон.

Профессор Jason Arday, который стал самым молодым черным профессором в истории Кембриджа, оказался не тем, за кого себя выдавал. Оказалось, что докторская его с большой вероятностью полна плагиата.

Но здесь ничего необычного нет - плагиат встречается регулярно. Необычно то, что человека, судя по всему не очень связанного с реальностью (дальше станет понятно почему), подняли на флаг и использовали как классический токен.

Arday с каждым годом завирался все больше
* То он пробежал 600 миль (почти 1000 км) за 6 дней.
* То он научился читать и писать только в 18 лет, но при этом в 16 сдал два GCSE (аналог ОГЭ) и учился на BTEC в колледже.
* То он пролежал в коме и заново учился ходить.
* То он собрал 5 млн фунтов на благотворительность.
* Где-то сообщалось, что он говорил, что участвовал в записи телепередачи ребенком, оказалось, что она про детей, которые родились за 15+ лет до него
* И много-много чего еще, очевидно невероятного.

Его лекции, по словам студентов, представляли собой (если он приходил на них) какую-то околесицу, где в основном смотрели YouTube и затем обсуждали в группах. Это, конечно, говорит еще и про качество самой дисциплины, где он преподавал (sociology of education).

Кембридж вначале сказал, что все это клевета и навет.
Потом, под весом доказательств, когда университеты, указанные Джейсоном в резюме как те, где он почетный лектор, сообщили, что это не так и он никогда у них не был, согласился на расследование. До этого 4 месяца полиция слегка прессовала журналиста, который посмел найти плагиат у почетного академика - теперь публично извинилась.

В конце концов - Джейсон ушел в отставку, а сегодня BBC сообщило, что он найден мертвым.

В итоге история, начавшаяся как враки и фантазии, принесла множество бед. Самому Джейсону и его семье. Студентам, многие из которых заплатили деньги, чтобы слушать такую чепуху, Кембриджу, а заодно дала повод для критики практик DEI. Такой вот Мюнхгаузен наших дней.

Самое удивительное в этой истории — как настолько очевидную ложь и регулярные жалобы со стороны студентов заметали под ковер в жертву великой идее. А казалось бы, университет мирового уровня.

Поэтому каждый раз, сталкиваясь на работе с фантазерами и решая промолчать (а ситуаций, аналогичной этой, много, пусть и не в таком масштабе), подумайте о конечном эффекте и о том, к чему это может привести.
Telegram Время Валеры У меня в друзьях в Фейсбуке есть сказочник из Узбекистана. Причем не такой сказочник, как Дмитрий Гайдук. То он устроится в OpenAI работать над узбекским языком и через два месяца уволится (понятное дело, ни в каком OpenAI он не работал). То создаст сервис…
  • 👍 159
  • 😁 40
  • ❤ 37
  • 😱 21
  • 😢 8
  • 🦄 6
  • 💯 5
  • 🔥 4
  • 🥴 4
  • 🤓 2
  • 👎 1
Post #992 20K
Мы с Романом Нестером, Валерием Бабушкиным и Бесланом Курашовым (plevako.ai и karpov.courses) приглашаем вас на наш FuckUp Night 26 августа.

От формата отходить не будем — поделимся своими историями, где всё пошло не по плану. И поговорим про культуру ошибок: как не зацикливаться на промахах и использовать их в свою пользу.

Встречу проведём онлайн, поэтому подключиться можно из любой точки и всем, кто принимает решения на основе данных.

🔵 Важно! Записи не будет, поэтому приходите на эфир. Главное, не забудьте зарегистрироваться.
  • 💅 48
  • 🔥 28
  • ❤ 14
  • 👍 4
  • 👎 2
Post #991 21.6K
Пару лет назад я общался с CTO Ozon Tech Антоном Степаненко и ребятами из его команды по поводу создания платформы для LLM. Ребята оказались замечательными, но переезжать из Лондона я не стал (примерно как с кафедрой ЦУ вышло), а ещё за пару лет до этого я выиграл книгу во время доклада Бориса Штерна в Яндексе — за лучший вопрос.

И вот эти два замечательных человека встречаются хэдлайнерами на конференции E-CODE от Ozon Tech, а в секцию ML/DS добавляется Валентин Малых, с которым мы недавно стояли на капитанском мостике.

ML-секция хорошая — индустриальный ML, работа с генеративными подсказками, уровни дообучения и агентский Cotype.

Зарегистрироваться можно здесь: https://ecode.ozon.tech/

Участие в конференции и вечеринках — бесплатное
  • 💅 90
  • 🔥 48
  • ❤ 25
  • 👍 11
  • 👎 8
  • 🤡 5
  • 💩 1
Post #989 24.3K
В комментариях к предыдущему посту просили рассказать про оптимизацию состояния тела, и тут как раз есть что рассказать.

Мой текущий набор в виде Ultimate Anti-Ageing Bundle и Orange Triad + Greens Vitamins имеет следующую проблему:

Тяжело набирать 20 таблеток из первого, да ещё с учётом того, что в каждом пакете разное количество порций, то есть части стака банально заканчиваются в разное время

И отвратительный вкус второго, хотя это меньшая проблема.

Почитав, посмотрев — решил попробовать играть как Бэкхэм The Beckham Stack - IM8

По нутриентам заменяет всё выше.
По удобству — гораздо лучше.
Вкус — хороший.

Рекомендовать пока не могу, но через три месяца напишу.
  • 🤣 187
  • 💊 139
  • ❤ 20
  • 👍 9
  • 👎 5
  • 👏 2
  • 👌 1
  • 🖕 1
Post #988 23.9K
Зашёл в магазин, где шьют обувь королю. Спросил, за какой срок пошьют bespoke. Сказали 18 месяцев.

В истории за такой срок менялись многие правители, а в ЮК совсем недавно так 3 премьер-министра было за это время.
Много думал.
  • 😁 323
  • ❤ 24
  • 💅 18
  • 🔥 4
  • 🤡 3
  • 🌭 2
Post #987 25.5K
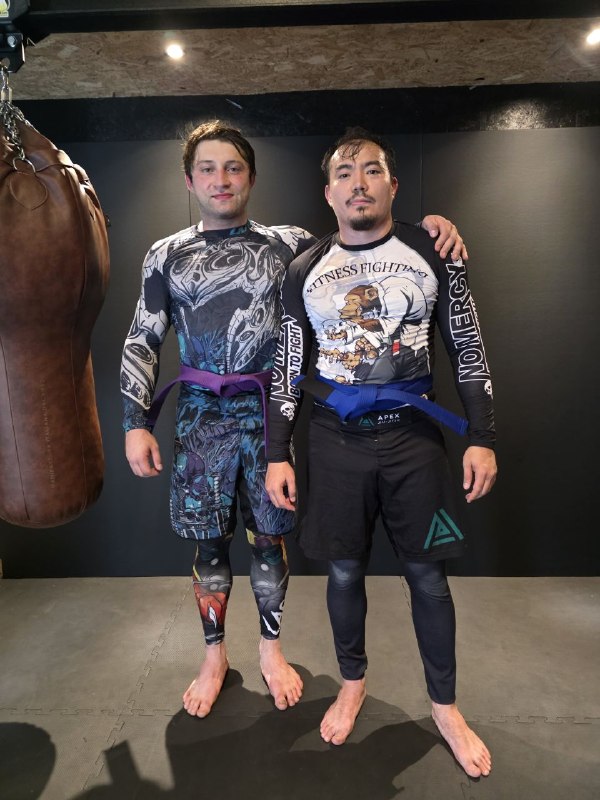
Два года не мог забрать фиолетовый пояс. Наконец-то забрал. Теперь у меня есть ещё одна профессия, где я могу учить.
  • 💅 414
  • 🔥 366
  • 👍 62
  • ❤ 29
  • 😎 11
  • 🎉 7
  • ⚡ 5
  • 👀 3
  • 👏 2
  • 🐳 2
  • 🦄 2
Post #986 20.9K
Прочитал замечательную статью: The Linux Scheduler: a Decade of Wasted Cores

“And you have to realize that there are not very many things that have aged as well as the scheduler. Which is just another proof that scheduling is easy.”
Linus Torvalds, 2001

15 + лет спустя
As a central part of resource management, the OS thread scheduler must maintain the following, simple, invariant: make sure that ready threads are scheduled on available cores. As simple as it may seem, we found that this invariant is often broken in Linux. Cores may stay idle for seconds while ready threads are waiting in runqueues. In our experiments, these performance bugs caused many-fold performance degradation for synchronization-heavy scientific applications, 13% higher latency for kernel make, and a 14-23% decrease in TPC-H throughput for a widely used commercial database


и
The Group Imbalance bug
The bug. We encountered this bug on a multi-user machine which we used to perform kernel compilation and data analsis using the R machine learning package. We suspected that this system, a 64-core, eight-node NUMA server, did not use all available cores for highly-threaded computations, instead crowding all threads on a few nodes. We illustrate this bug with the output from our visual tool


Стоит заметить, что их фикс у меня вызывает много сомнений, замена среднего на минимум, для оценки загрузки - многое может пойти не так. Да и в целом, я бы даже не назвал это багами, оптимизировали под свою нагрузку - честь им и хвала, но это не значит что в среднем стало лучше, а не хуже.

Самый важный вывод, что понимая систему достаточно глубоко, можно ее взять и допилить очень значимо под себя
  • 👍 33
  • 💯 27
  • ❤ 12
  • 🔥 5
  • 🤓 5
  • 🎉 2
Post #984 26.3K
Post #981 46.5K
Post #980 29K
Добавили еще один скилл - AI Stage-Gate Review. Поможет вам ответить на вопрос, стоит ли продолжать или лучше перестать.

Скилл имени Адама Елдарова

Use this skill to run a gate review for an AI product and reach a defensible decision: advance, fix-and-recycle, or stop. Stage-Gate is a portfolio-management process that structures an AI product from idea to scale: each stage of work ends at a gate where results are defended and a Go/Conditional/Kill decision is made. The useful output is not a checklist stamp. It is a decision that says what is proven, what is still a risk, what must be true to advance, and how much to invest next.

Provenance. This skill encodes a generic Stage-Gate process adapted for AI products — six stages on Discovery and Delivery tracks, traffic-light gates, and dual value-and-technical validation. It is a distilled, vendor-neutral adaptation, not a transcription of any one organization's internal playbook; tune the stages, criteria, and thresholds to your own portfolio. It is a sibling of ml-system-design-review in the same ML System Design skill collection: that skill judges how good a design is; this one judges whether it has earned the next investment.

The process runs on two tracks — Discovery (find and validate ideas) and Delivery (build and scale) — across six stages, with an optional Fast Track for low-uncertainty products. The AI difference is that value alone is never enough: technical feasibility, data, and alignment must clear each gate too.
GitHub MLSystemDesign/skills/ai-stage-gate/SKILL.md at main · ML-SystemDesign/MLSystemDesign Contribute to ML-SystemDesign/MLSystemDesign development by creating an account on GitHub.
  • 💅 135
  • 👍 16
  • ❤ 10
  • 🔥 7
  • 💩 2
  • 🙏 2
  • 🌭 2
  • ❤‍🔥 1
  • 👌 1
Older posts →

About this channel

How can I read @cryptovalerii without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Время Валеры: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Время Валеры have?
Время Валеры (@cryptovalerii) has 30.8K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Время Валеры know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →