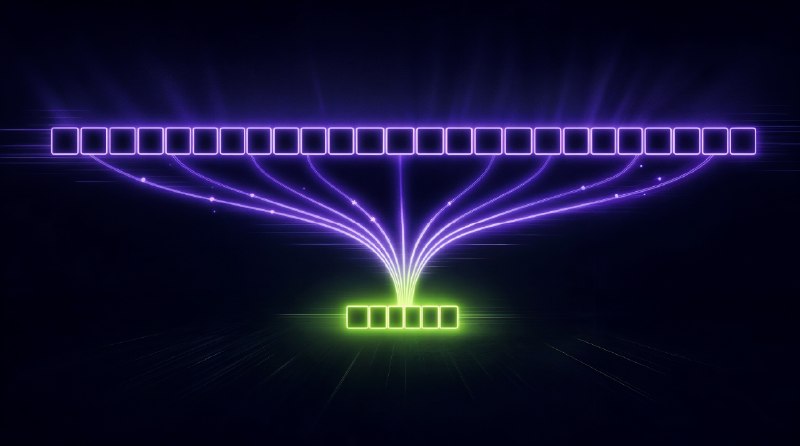
По сути, это компиляция промпта.
У GraphQL-агента Sidekick системный промпт занимал около 6 000 токенов, которые постоянно приходилось обрабатывать снова и снова.
Prefix caching решает проблему лишь частично. Модели не нужно повторно вычислять KV cache для промпта, но при генерации каждый новый токен всё равно работает со всем контекстом. Чем длиннее промпт, тем больше памяти и времени требуется на каждый шаг декодирования. Придумали логичную штуку применить: gisting
Как работает gisting.
Сначала Shopify выбрали коэффициент сжатия 4:1(это гиперпараметр) и создали 1 500 новых специальных токенов вместо 6 000 исходных.
Эти токены не были выбраны из системного промпта и не являлись его текстовым summary. Это просто новые ID вроде
<GIST_1>, <GIST_2> и так далее. Дальше:
* Все веса модели замораживаются. Обучаются только эмбединги новых gist-токенов.
* Teacher-версия модели получает полный системный промпт, запрос пользователя и начало правильного ответа. На каждой позиции она выдаёт распределение вероятностей следующего токена.
* Student-версия той же самой модели получает тот же запрос и ответ, но вместо 6 000 токенов системного промпта видит 1 500 gist-токенов;
* Распределения teacher и student сравниваются через KL divergence.
* Градиент меняет только эмбединги gist-токенов, пока student не начинает выдавать практически те же распределения ответов, что и teacher.
* Изначально новые эмбединги можно было бы задать случайно. Но Shopify нашли более эффективную инициализацию: исходный промпт разделили на группы по четыре токена, а каждый gist-embedding инициализировали средним значением эмбедингов соответствующей четвёрки. Это снизило начальный loss в семь раз.
При этом
<GIST_1> не становится сокращённым обозначением первых четырёх токенов. Все 1 500 embeddings обучаются совместно и в итоге кодируют не текст промпта, а его влияние на поведение модели.Получаем сжатие поведения: модель учат реагировать на короткую последовательность обучаемых векторов так же, как на длинную текстовую инструкцию.
В результате примерно 6 000 обычных токенов превратились в 1 500 обученных токенов. Модель ведёт себя так, будто прочитала полный промпт, хотя фактически получает его сжатое представление.
После обучения никакой отдельной архитектуры не требуется. Эмбединги записываются в embedding matrix, токены регистрируются в tokenizer, а длинный промпт при запросе просто заменяется их последовательностью. Нет дополнительного encoder, специального attention mask или отдельного serving path.
Результаты при нагрузке 350 запросов в минуту:
— time to first token: с 438 до 354 мс, −19%;
— полная задержка: с 6,8 до 4,2 секунды, −38%;
— throughput: с 20,2 до 23,4 запроса в секунду, +16%;
— требуемое количество GPU: −14%.
Качество при этом не ухудшилось.
Как они подбирали рецепт: Autoresearch-цикл сам менял гиперпараметры, запускал обучение и оценивал результат.
Так нашли оптимальное сжатие 4:1. При дальнейшем уменьшении количества gist-токенов качество начинало падать. Для другой модели, промпта и предметной области граница будет другой.
Предварительный расчёт teacher logits и токенизация сократили один обучающий прогон с 30 до 6 часов.
Оказалось также, что усреднение функции потерь по токенам ответа приводило к галлюцинациям, а усреднение по batch сохраняло больше сигнала от длинных ответов. Хорошее напоминание, что даже в относительно простой оптимизации детали функции потерь могут полностью изменить поведение системы.
Prompt engineering постепенно превращается в обычный ML engineering.
Системный промпт можно рассматривать как исходный код, а gist-токены — как его скомпилированную версию. Здесь всё знакомо: датасет, distillation, loss, evaluation, нагрузочное тестирование, мониторинг качества и стоимости.
#ArticleReview