TGViewer
Channel Public Channel
Complete AI

Complete AI

@complete_ai

Меня зовут Андрей Кузнецов

Руковожу управлением в Sber AI, построил успешную лабораторию FusionBrain в AIRI, один из основателей Kandinsky, к.т.н., 15+ лет опыта в Computer Vision, выступаю с лекциями и пишу о событиях в AI и ML
Subscribers
7.86K
Photos
517
Videos
39
Links
289

Showing posts older than #145 · Back to latest

Older Posts 7 shown
Post #142 2.02K
⚡️⚡️⚡️Generating Images with Multimodal Language Models
(от создателей FROMAGe)


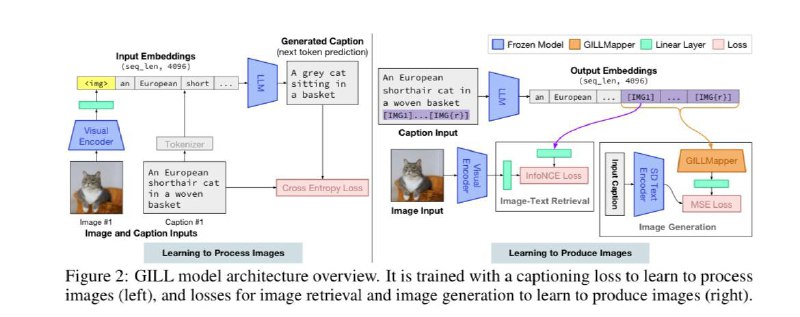
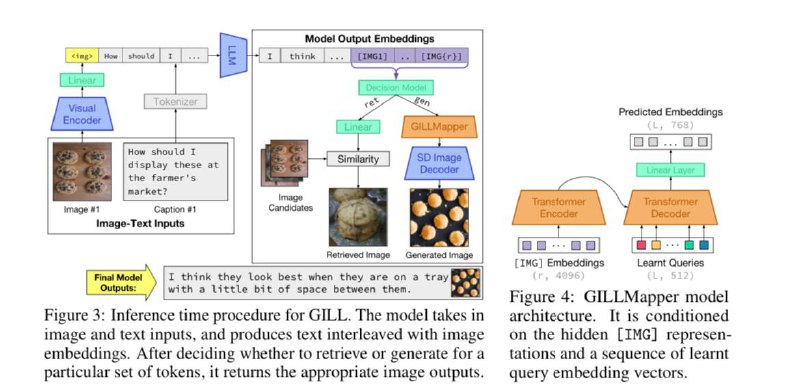
Команда Carnegie Mellon University представила новое мультимодальное решение, которое позволяет использовать изображения в контексте языковой модели не только в качестве input’а, но и для генерации output’а. Другими словами, генерация изображений доступна теперь нативно. Всего обучается несколько небольших линейных мапперов и GILL трансформер, а остальные части архитектуры заморожены.

🔥Понимание изображений - обычный линейный маппинг на эмбеддингах замороженных картиночном энкодере и LLM (обучение на парах данных для задачи image captioning)

🔥Генерация спецтокенов - добавляется r [IMG] токенов для обогащения словаря LLM и учится небольшой трансформер - маппер, который позволяет модели понимать изображения. Учится отдельная матрица весов E, а LLM остаётся замороженной

🔥Генерация изображений - обучается GILLMapper - энкодер-декодерный трансформер из 4х слоёв, который использует в качестве condition - скрытые состояния токенов IMG из языковой модели. На выходе он позволяет получать L обучаемых эмбеддингов языковой модели для входа генеративной text2image модели (StableDiffusion) - принцип похож на DETR и BLIP-2. То есть по сути учится маппить hidden state спецтокенов в пространство текстового энтодерма text2image модели

🔥Image retrieval - добавляются еще два линейных маппинга t2i и i2t и соответствующий InfoNCELoss для задачи retrieval.
Все 4 режима объединяются в одной функции потерь и учатся на датасете ConceptualCaptions3M

📌Языковая модель - OPT-6.7B
📌Визуальный энкодер - CLIP ViT-L
📌Генератор изображений - SD 1.5
📌Обучаемых параметров - 50M
📌Обучение - 20k итераций с bs=200, 2 дня на 2xA6000

Статья
GitHub

@complete_ai
  • 👍 21
  • 🔥 9
  • ❤‍🔥 3
  • 👏 1
  • 🎉 1
  • 🏆 1
Post #140 2.01K

Forwarded from Институт AIRI

Открываем прием заявок на Лето с AIRI! ☀️

2 недели науки об искусственном интеллекте для молодых исследователей. В этом году мероприятие пройдет в Татарстане.

🗓 Заявки принимаются до 4 июня 2023 года.

Программа включает в себя лекции, семинары и практическую работу по направлениям:

– обучение с подкреплением
– робототехника
– 3D компьютерное зрение
– генеративное и вероятностное моделирование
– моделирование данных на многообразиях машинного обучения
– графовые нейронные сети
– детектирование и диагностика аномалий по сенсорным данным

📍Питание, обучение и проживание бесплатное, оплатить самим нужно будет только проезд.

Прочитать все подробности и подать заявку можно по ссылке 🚀
  • 👍 15
  • ❤‍🔥 5
Post #131 7.38K
Kandinsky 2.?🤔
  • ❤‍🔥 46
  • 🔥 19
  • 👍 6
Post #127 2.46K
Давно я что-то не писал интересных обзоров и снова здравствуйте! Появилось время наконец⏳

🚀BLOOMChat: An Open-Source 176-Billion-Parameter Multilingual Chat Large Language Model

SambaNova на днях выпустила свой мультиязычный чатбот на основе 176 млрд. языковой модели BLOOM. Поддерживает 46 языков, 13 языков программирования.

BLOOM сама по себе очень большая опенсурс языковая модель, которая развивается огромным штатом международного комьюнити. В итоге эту модель удачно дотюнили на формате чат диалогов с помощью датасетов OpenChatKit, Dolly 2.0 и OASST1. Первый сет - исключительно синтетические диалоги, а последующие два - естественные диалоги.

Самый интересный результат - это human evaluation модели на 6 языках, в ходе которого BLOOMChat близок к GPT-4 по предпочтения ответов пользователями - 45% vs 55%. В задаче машинного перевода BLOOMChat тоже преуспел в качестве.

Создатели отмечают возможную токсичность модели, способность придумывать несуществующие факты и конечно предупреждают об ответственности за harmful контент😉

📌HuggingFace
📌Blog
+ несколько результатов сравнения модели в аттаче

@complete_ai
  • 🔥 27
  • 👍 4
  • ⚡ 3
Post #126 3.74K
⚡Всей командой Sber AI начинаем подготовку к очередной конференции AI Journey 2023) И первая аудитория, которую хочется заинтересовать - это друзья, коллеги, знакомые и подписчики из родной академической среды)

В рамках AI Journey 2023 мы запустили отбор статей для выпуска научного журнала.

Работы будут опубликованы в журнале «Доклады Российской академии наук. Математика, информатика, процессы управления» и его англоязычной версии Doklady Mathematics, индексируемый в Scopus.

Авторы также смогут представить доклады в рамках конференции AI Journey 2023, лучшая работа получит приз – 1 000 000 рублей
🌟

Подать статью можно на сайте AI Journey до 31 июля 2023 года.
SpringerLink Doklady Mathematics Doklady Mathematics is a peer-reviewed journal presenting significant new research in mathematics and its applications. Includes pure and applied ...
  • 🔥 34
  • ❤‍🔥 5
  • 🎉 3
  • 👎 2
  • ⚡ 1
Post #125 2.88K
2000!
Спасибо всем за интерес и внимание к публикациям.
Главное, чтобы польза была для читателей🙏⚡
  • ❤‍🔥 41
  • 👏 18
  • 🎉 8
  • 🔥 6
Post #124 3.13K

Forwarded from Dendi Math&AI

🦌 RUDOLPH 🦌

Наконец-то дошли руки написать о нашей давней разработке, о модели RUDOLPH (RUssian Decoder On Language Picture Hyper-tasking), которая умеет решать много задач в модальностях текст и изображение и которая уже успела побывать бейзлайном соревнования FusionBrain Challenge 2.0 в 2022 году (и даже заняла там почётное третье место).

💡 Архитектурно модель представляет собой декодер-блок трансформера, работающий с входной последовательностью токенов, которую можно условно разделить на три основных сегмента: левые текстовые токены, токены изображения и правые текстовые токены. За счёт этого на претрейне можно показывать модели сэмплы по 3 задачам: text2image (генерация изображения по тексту), image2text (описание изображения) и text2text (языковое моделирование в левых текстовых токенах).

💡 Мы обучили 4 версии модели, которые различаются между собой как количеством параметров (соответственно, количеством и размером скрытых слоёв), так и соотношением количества токенов текста и изображения:
👉 RUDOLPH-350M
👉 RUDOLPH-1.3B
👉 RUDOLPH-2.7B
👉 RUDOLPH-2.7B-FBC2

💡 Последняя из этих моделей была дополнительно дообучена на инструктивном датасете (когда это ещё не стало мейнстримом 😊) решать 6 прикладных задач в модальностях текст и изображение: Text QA, Math QA, Image Generation, Image Captioning, Visual QA, Text Recognition in the Wild. RUDOLPH даже немного умеет в zero-shot object detection (после соответствующего файнтюна). Фишка этой версии модели также и в том, что она может понимать формулировку задачи на естественном (русском) языке 💪

Подробнее почитать про архитектуру RUDOLPH, узнать детали обучения и файнтюнинга, посмотреть примеры работы модели можно тут:
👉 Хабр

Воспользоваться и протестировать RUDOLPH можно тут:
👉 GitHub
👉 HuggingFace
👉 Cloud

В создании и обучении RUDOLPH успели принять участие многие ребята (@AShonenkov, @lizagonch - вам отдельное спасибо 👍, @kuznetsoff87, @bra_ket, @NastyaMittseva, @bom_bo0m @Gugutse @alexnikolich👌). Всем огромное спасибо за крутую и качественную работу!

@dendi_math_ai
  • 🔥 35
  • 👍 8
  • ❤‍🔥 2
  • 👎 2
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →