
⚡️⚡️⚡️Generating Images with Multimodal Language Models
(от создателей FROMAGe)
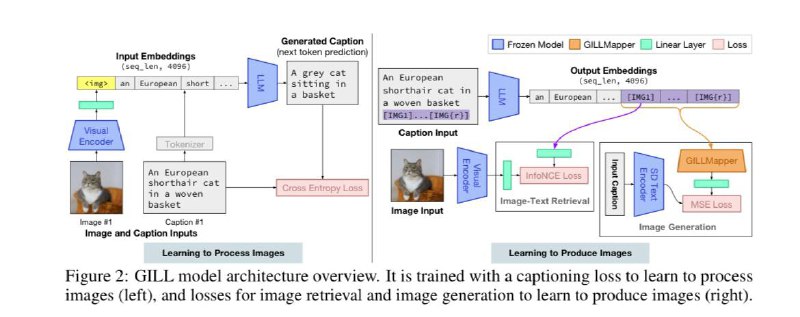
Команда Carnegie Mellon University представила новое мультимодальное решение, которое позволяет использовать изображения в контексте языковой модели не только в качестве input’а, но и для генерации output’а. Другими словами, генерация изображений доступна теперь нативно. Всего обучается несколько небольших линейных мапперов и GILL трансформер, а остальные части архитектуры заморожены.
🔥Понимание изображений - обычный линейный маппинг на эмбеддингах замороженных картиночном энкодере и LLM (обучение на парах данных для задачи image captioning)
🔥Генерация спецтокенов - добавляется r [IMG] токенов для обогащения словаря LLM и учится небольшой трансформер - маппер, который позволяет модели понимать изображения. Учится отдельная матрица весов E, а LLM остаётся замороженной
🔥Генерация изображений - обучается GILLMapper - энкодер-декодерный трансформер из 4х слоёв, который использует в качестве condition - скрытые состояния токенов IMG из языковой модели. На выходе он позволяет получать L обучаемых эмбеддингов языковой модели для входа генеративной text2image модели (StableDiffusion) - принцип похож на DETR и BLIP-2. То есть по сути учится маппить hidden state спецтокенов в пространство текстового энтодерма text2image модели
🔥Image retrieval - добавляются еще два линейных маппинга t2i и i2t и соответствующий InfoNCELoss для задачи retrieval.
Все 4 режима объединяются в одной функции потерь и учатся на датасете ConceptualCaptions3M
📌Языковая модель - OPT-6.7B
📌Визуальный энкодер - CLIP ViT-L
📌Генератор изображений - SD 1.5
📌Обучаемых параметров - 50M
📌Обучение - 20k итераций с bs=200, 2 дня на 2xA6000
Статья
GitHub
@complete_ai
Post #142
2.02K


- 👍 21
- 🔥 9
- ❤🔥 3
- 👏 1
- 🎉 1
- 🏆 1