TGViewer
Channel Public Channel
Complete AI

Complete AI

@complete_ai

Меня зовут Андрей Кузнецов

Руковожу управлением в Sber AI, построил успешную лабораторию FusionBrain в AIRI, один из основателей Kandinsky, к.т.н., 15+ лет опыта в Computer Vision, выступаю с лекциями и пишу о событиях в AI и ML
Subscribers
7.86K
Photos
517
Videos
38
Links
288
Recent Posts 19 shown
Post #933 1.05K
AI + разработка — Senior-разработчиков ждут в Ozon Tech

В компании развивается новое направление, команда, которая будет строить платформу для создания и запуска AI-агентов. Предстоит работать не над одним AI-продуктом, а над инфраструктурой для агентских систем от SDK и инструментов до оркестрации, observability и evaluation.

Ребята в поисках Senior-разработчиков. Можно приходить с любым стеком — Go будет основным, но на интервью разрешают использовать привычный язык. Go можно спокойно освоить уже после выхода: команда поможет с переходом.

Откликнуться
  • 🏆 4
  • 🙊 2
Post #932 2.02K
Мы выложили программу Practical ML Conf 2026

Я уже не первый год состою в программном комитете конференции, помогал отбирать доклады. Из того, что сам точно не пропущу:

➡️ Антон Разжигаев из AIRI в онлайне разберёт, что находится внутри Ouroboros, как устроена петля самоулучшения агента и какие грабли встретились по дороге. Про Ouroboros я здесь уже писал, поэтому особенно интересно послушать от Антона лично)

➡️ Данил Кашин из Яндекса расскажет про Agentic Vision: как научить VLM рассуждать, строить план и использовать внешние инструменты. Будут visual reasoning, OCR, детекторы, поиск и исполняемый код

➡️ Александр Куцаков из GigaChat расскажет про temporal grounding для длинных аудиозаписей: как научить Audio LLM понимать не только что произошло, но и когда именно. Внутри синтетический датасет на 13 тысяч часов, миллион семплов и снижение ошибки в тайм-кодах с 66 до 3,5 секунды

Отдельный респект кейноутам этого года) Я тоже буду на конфе, так что вечером, как всегда, встретимся на нетворк-тусовке и поболтаем!

➡️ Посмотреть программу и зарегаться
  • ❤ 10
  • 🔥 6
  • ❤‍🔥 3
  • 👍 2
Post #931 2.05K

Forwarded from Анализ данных (Data analysis)

Утекли предполагаемые бенчмарки Gemini 4 - цифры выглядят безумно 🤯

В сети разошлась таблица с прогнозируемыми результатами Gemini 4:

- 99,9%+ — ARC-AGI-3
- 99,1% — FrontierMath Tier 4 v2
- 72,8% — Terminal-Bench Science 0.1
- 70,2% — HealthBench Professional
- 62,3% — Terminal-Bench 4.0
- 48,7% — AutomationBench
- 98,6% — BenchCAD

В этой таблице Gemini 4 опережает GPT-6 Astra и Fable 5.1 на всех перечисленных тестах. Особенно сильный скачок якобы приходится на математику, scientific reasoning, работу в терминале и agentic-задачи.

Сам Gemini 4 реален: Google уже подтвердил, что запустил для него свой «самый амбициозный pre-training run» на сегодняшний день.
  • 👍 11
  • 😁 8
  • ❤ 3
  • 🤔 1
Post #930 3.09K
17 сентября в Москве пройдёт AI R&D DAY — конференция для исследователей, разработчиков, руководителей R&D-команд и специалистов, которые создают и внедряют передовые решения на основе искусственного интеллекта, где я буду выступать с лекцией «Автономный универсальный агент для повышения эффективности сотрудников Сбера».

В центре программы — NextGenAI, проект, который исследует новые вызовы и формирует образ будущего ИИ.

Вас ждут 22 доклада в рамках двух треков. Поговорим о:

🔘новых подходах к созданию и обучению моделей
🔘системах, которые одновременно работают с текстом, изображениями, звуком и другими типами данных
🔘развитии голосовых технологий
🔘оценке качества AI-решений
🔘внедрении технологий в реальные продукты

Участие бесплатное, места ограничены. 17 сентября — Москва (очно) и онлайн. Регистрируйтесь.
  • ❤ 15
  • 👍 6
  • 🔥 5
Post #929 2.33K

Forwarded from Уставший техдир

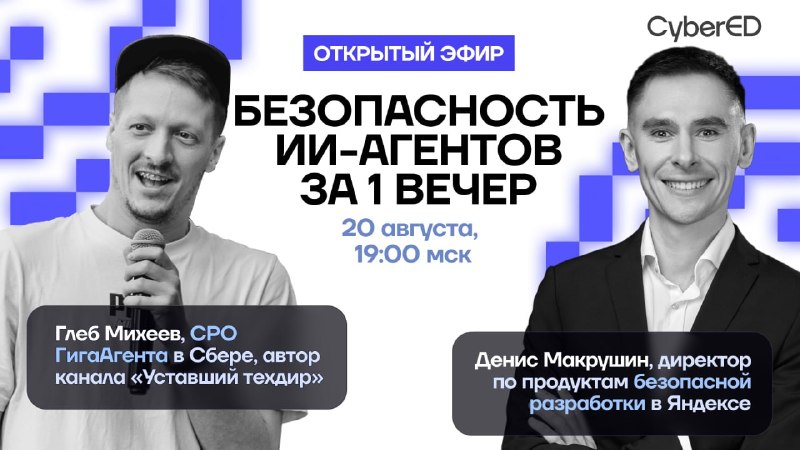
Сегодня вечером мы вместе с Денисом Макрушиным встретимся на стриме и разгоним базу про безопасность в нашем новом дивном мире агентов.

Обсудим потенциальные векторы атаки, как обезопаситься от них и контролировать агентов после внедрения. Будет одинаково полезно и для тех кто делает агентов, и тех, кто использует их для разработки

Присоединяйтесь
  • ❤ 4
  • 👍 3
  • 🔥 1
Post #927 3.46K
🔥 GLM-5.3 от Z.ai — главное за 30 секунд:

Чистый post-training. Та же базовая модель —GLM-5.2 — все улучшения получены только масштабированием RL на длинных агентных задачах (фреймворк slime + SAO)

Сильнейшая open-weight модель для кода. +50% на внутреннем Z.ai Code Bench; Terminal Bench 3.0: 28.3 (было 4.6); DeepSWE v1.1: 66.9 (было 46.2). На TB 2.1 (88.2) вплотную к Fable 5 и GPT-5.6 Sol.

Эмерджентные способности в кибербезопасности — главный сюрприз. Модель сама начала выстраивать полные цепочки эксплуатации уязвимостей. CyberGym 84.5% — #1 среди всех моделей; ExploitBench удвоился (24→54). В реальных проектах нашла 2 436 уязвимостей в 269 OSS-проектах, включая баги возрастом до 40 лет.

Веса будут открыты через 2 недели после завершения safety-аудита и hardening

Честное позиционирование на бенчмарках. Z.ai прямо показывают, где отстают от closed frontier (Fable 5, GPT-5.6 Sol) — ExploitBench 54 vs 78, Terminal Bench 3.0 28 vs 35

Все детали по ссылке
  • 🎉 14
  • 👍 7
  • ⚡ 3
Post #926 3.73K
🐍 Сегодня мы выпустили ГигаАгента

Расскажу, что мы построили и почему это важно.

ГигаАгент — это автономный универсальный ИИ-агент на базе Ouroboros, который переписывает свой собственный код через reviewed self-evolution. Буквально: редактирует рантайм, коммитит через multi-model review gate, рестартится на новой версии. Если сломался — откатывается. Если совсем плохо — /panic.

Это результат синергии, которая редко случается в индустрии: исследовательская команда лаборатории FusionBrain AIRI отвечала за архитектуру агента и самоэволюцию, фреймворк и научный фундамент, а инженерная команда в Сбере — за продуктовую обвязку, инфраструктуру и адаптацию под бизнес-сценарии и enterprise-ограничения. Когда исследователи и инженеры работают как одна команда, получается отличная синергия:

🏆 SOTA на трёх бенчмарках разом:
— Terminal-Bench 2.1: 86.97% (предыдущий лучший — 83.8%)
— OSWorld-Verified: 90.69% — работа мышкой/клавиатурой в реальном десктопе
— CL-Bench: 0.2301 normalized reward — накопление знаний между задачами

На SWE-bench Pro и GAIA — паритет с Claude Code и Codex.

🧬 Ключевая фишка — саморазвитие
Агент может менять свои навыки, промпты, контекст и даже логику ревью. Но каждое изменение проходит через иммунную систему: несколько LLM от разных вендоров независимо ревьюят дифф, голосуют кворумом, плюс отдельная модель с большим контекстом проверяет, не ломает ли правка проект целиком. Fail-closed — при сомнении изменение не проходит. Пользователю доступны разные режимы глубины эволюции: от ядровых компонент до навыков.

Он также умеет
— Создавать рой субагентов для сложных задач
— Проектировать навыки по запросу пользователя
— Решать задачи по расписанию (cron)
— Подключать уже созданные ранее навыки в других агентах, интегрирован магазин ClawHub, есть MCP и A2A протоколы для взаимодействия
— Анализировать и создавать презентации, дэшборды, документы, таблицы, PDF

Как продукт
— Работает в фоне, не нужно контролировать каждый шаг
— Хранит память между сессиями
— Сам создаёт и подключает навыки по необходимости
— Учится на ошибках
— Доступен через Agents Space от Cloud.ru, 4000 бонусов на старте

📄 Техрепорт на arXiv: arxiv.org/abs/2608.08311
📰 Хабр: https://habr.com/ru/companies/airi/articles/1065428/
🔗 Попробовать: https://cloud.ru/agents-space
  • 🔥 34
  • ❤ 13
  • ❤‍🔥 8
  • 🙊 4
  • 👍 2
  • 😱 2
  • 🦄 1
Post #925 6.1K
⚡️ Диффузионные языковые модели: что в них работает, а что вызывает вопросы

Выложили большой разбор dLLM — результат совместной работы нескольких команд: «Интерпретируемый ИИ» лаборатории FusionBrain, «Основы генеративного ИИ» Института AIRI (@Ivan_Oseledets) и «Генеративная поэзия» Сергея Маркова (@oulenspiegel_channel) SberAI.

tldr: год возились с диффузионными языковыми моделями — воспроизводили чужие методы, обучали свои, ускоряли инференс. Разобрали за вас целое поле и рассказываем, что уже стоит брать, а куда пока лучше не вкладывать время.

Для тех, кто не в теме: dLLM генерируют текст не по одному токену слева направо, а параллельно, раскрывая замаскированные позиции по всей последовательности. Отсюда обещание кратного ускорения — но на практике всё упирается в KV-кэш, который в классической диффузии нормально не работает.

Мы разобрали три подхода — и вот что у нас получилось:

Адаптация — переучить готовую LLM в диффузионную за небольшую долю стоимости исходного претрейна. Сегодня это основной путь к большим dLLM — так получают модели вплоть до сотен миллиардов параметров.
У нас DiffuGPT/DiffuLLaMA не воспроизвёлся: нашли и исправили кучу проблем в коде, прогнали на GPT-2, Qwen и GigaChat — но генерация всё равно осталась плохой. Зато ReFusion + GigaChat 3B завёлся: 2,7× ускорение по wall-clock и более чем 2× рост на GSM8K.

Обучение с нуля — дорого и почти всегда не нужно в прикладном сценарии, но без него сложно проверять методические гипотезы. Разбираем MDLM как полигон для экспериментов и Eso-LM, где ради работающего KV-кэша пожертвовали двунаправленным вниманием.

Дистилляция — ускорить уже обученную модель, сократив число шагов расшумления. Рассказываем про свой метод IDLM (ICML 2026): для MDLM число шагов сокращается с 1024 до 16.

В конце — таблица с рекомендациями: какой подход выбирать под конкретную задачу и ограничения.

👉 Хабр
  • ❤ 22
  • 🔥 5
  • 👍 2
Post #924 2.91K
Alibaba, что ты делаешь? Прекрати!

12.08 нас ждёт большой залив весов в опенсурсе. Приятно, что для простых смертных дают дистиллированную версию на 27B параметров💪
  • 🔥 34
  • ⚡ 9
  • 👀 3
Post #923 2.36K

Forwarded from CV Time

Курс по Visual GenAI от Yandex Research и ШАД

Авторы CV Time не только пишут обзоры статей о компьютерном зрении, но и создают обучающие курсы.

Сегодня делимся курсом ШАДа «Генеративные модели в компьютерном зрении», который ведёт Дмитрий Баранчук, руководитель группы GenAI в Yandex Research, вместе с праймовой командой исследователей в этой области.

Будет полезно тем, у кого есть базовые знания по генеративкам и желание разобраться глубже:

• в теории диффузионных моделей, эффективных методах их обучения и семплирования;
• в новых гибридных моделях на основе диффузии для генерации изображений, видео и 3D.

У курса есть открытый GitHub-репозиторий, где можно найти слайды, записи лекций и семинаров, а также домашние задания.

CV Time
  • ❤ 22
  • 🔥 10
  • ❤‍🔥 8
Post #922 2.27K
Post #921 2.5K
Отличный результат для опенсурса на бенчмарке по восстановлению кода frontend’а по изображению или скриншоту💪

Сделал скрипт парсинга сайта, прошелся по страницам, заскриншотил и велкам - копия сайта уже готова:)
  • 👍 10
  • 🔥 7
  • 😁 3
Post #920 2.29K
⚡️CADENA: Stepwise CAD Reverse Engineering
Новое решение от Лаборатории FusionBrain, группы Пространственного интеллекта Института AIRI и команды Sber AI 🚀


Релиз в нашей линейке моделей для реверс-инжиниринга деталей!

tldr: Перешли на пошаговое предсказание — модель стала гибче, качество выросло, и чем сложнее датасет, тем больше отрыв. Плюс собрали CADENA-Bench: 3396 реальных механических деталей, разбитых по категориям ЕСКД, чтобы можно было оценивать готовность к практике для отдельных типов деталей.

Постановка задачи для тех, кто пока про нее не слышал: по скану физической детали восстановить её CAD-модель — дерево построений, которое инженер может править и по которому деталь можно произвести. Последовательность CAD-операций пишется питоновским кодом, так что фактически это mesh2code.

Наши прошлые модели предсказывали всю последовательность разом и потому наследовали статистику трейна: если операция B в обучении всегда стоит между A и C, на инференсе она встанет туда же. На сложных и редких деталях это ломалось. В CADENA мы предсказываем по одной операции за раз — модель исполняет то, что уже написала, смотрит на разницу с целью и решает, что делать дальше. Плюс новый генератор, дающий длинные последовательности операций.

Результат: заметный отрыв на всех датасетах, где мы замеряемся. На CADENA-Bench мы лучше в 5 категориях из 6 и в среднем. На BenchCAD, где свои модели меряет в том числе Claude, восстановление объёма 91% против 71% у фронтирных моделей и 75% у специализированных.

На гифке — как модель собирает деталь по операциям.

🤗 Будем очень благодарны за апвоуты на HF и звёздочки на GitHub:
👉 Paper тут и тут
👉 GitHub
👉 Dataset
👉 Model

👉 Заапвоутить
  • ❤‍🔥 19
  • 🏆 8
  • 👍 5
  • 🔥 2
Post #917 2.75K
Ну вот и Qwen 3.8 пожаловал💪

Автономный кодинг: более 10 дней саморазвивающейся разработки - от пустой папки до готового к эксплуатации продукта без вмешательства человека; полная история проекта доступна на GitHub: https://github.com/qwen-code-dev-bot/oh-my-cli

Работает в пром задачах: готовые решения production уровня для сотен задач

Высокий уровень долгосрочного планирования: автономное планирование на системном уровне с адаптивным обучением по принципу замкнутого цикла, обеспечивающее выполнение 500+ итераций оптимизации дизайна чипов и разработку стратегии на год в e-com

Нативная мультимодальность: vision как непрерывный контур обратной связи для планирования, выполнения задач и самокоррекции
  • 🏆 17
  • ❤ 10
Post #916 2.03K

Forwarded from AbstractDL

Ouroboros теперь SOTA на Terminal Bench, OSWorld и CL-bench

Мой любимый агентный луп на чистом питоне доэволюционорал до состояния лучшего харнесса для кодинга! На главных бенчмарках он теперь обходит Codex, Claude code, Cursor и Hermes.

Выходит, что в рисёрче, в computer use, в работе через терминал и в задачах на кодинг — уроборос сейчас является лучшим агентом. Так что с этого момента всю разработку и исследования я веду только через уробороса.

Для полной воспроизводимости результатов. Весь код, скрипты, трейсы я выложил в открытый доступ.

Напоминаю: лицензия MIT. Так что спокойно ломайте, форкайте, проверяйте трейсы, пишите что я где наврал. И кидайте issues и PR-ы! Все постараемся с уроборосом принять😋

P.S. Кошмар какие дорогие агентные бенчи. Прогнать весь набор стоит как квартиру купить (это не шутка!!)

GitHub, Хабр, установочники
  • 🔥 17
  • 🎉 13
  • 👏 8
  • ⚡ 2
  • ❤ 1
  • 👍 1
Post #914 3.17K
🤖 Ищем менеджера проектов в ИИ-стройку

Мы — SberAI, команда, которая строит будущее строительства с помощью искусственного интеллекта. Совмещаем исследования и реальное применение: автоматизируем анализ и составление строительной документации, извлекаем данные из BIM-моделей, создаём генеративные решения для архитектуры и дизайна.
Ищем человека, который сведёт воедино науку, продукт и стройку.

Чем предстоит заниматься
→ Управлять проектами от идеи до внедрения: планировать сроки, ресурсы, риски и зависимости
→ Синхронизировать усилия исследователей (DS, ML-инженеров) и продуктовой команды — переводить научные разработки в рабочие решения
→ Работать с заказчиками из строительной отрасли: понимать их процессы, формализовывать требования, контролировать качество поставки
→ Вести проектную документацию и обеспечивать прозрачность для всех стейкхолдеров
→ Анализировать рынок строительных ИИ-решений: конкуренты, тренды, регуляторика, потребности заказчиков
→ Формулировать бизнес-требования на основе анализа рынка и обратной связи — переводить инсайты в задачи для команды
→ Определять ключевые метрики: технические (точность, скорость инференса), продуктовые (вовлечённость, retention) и бизнесовые (экономия времени, снижение ошибок)
→ Готовить аналитику для руководства: эффективность внедрённых решений, прогнозы, сравнение с рынком

Что важно для нас
✅ Опыт управления проектами в технических командах 3+ лет — желательно в продуктах с ИИ-компонентом или сложной доменной логикой
✅ Понимание жизненного цикла ML-проектов: от сбора данных до production-инференса
✅ Знакомство со строительной отраслью или готовность быстро погружаться: BIM, проектная документация, СП, стадии строительного цикла
✅ Гибкость: умение работать и в условиях исследовательской неопределённости, и в режиме продуктовой поставки
✅ Коммуникация: умение объяснять сложные технические вещи нетехническим стейкхолдерам и наоборот

Откликнуться — пишите в личку Евгении Газарян @jjg26
  • ❤ 12
  • 🙊 9
  • 🔥 6
  • 😁 2
  • 👍 1
Post #913 2.48K
Интегрально инсайты из K3: 2.78Т параметров, 896 экспертов, 1M контекст. Под капотом — системная оптимизация на каждом уровне стека:

1️⃣ SiTU-GLU — замена SwiGLU с мягким насыщением активаций. Именно это позволило безопасно масштабировать sparsity до 56× (16 из 896 экспертов). Без этого приёма модель бы просто взорвалась

2️⃣ Quantile Balancing — балансировка нагрузки экспертов за один forward pass через квантили. Полностью убрали auxiliary loss, как следствие чище градиенты, быстрее сходимость

3️⃣ MoonViT-V2 — vision encoder обучен с нуля через next-token prediction. Контрастивный pre-training (SigLIP/CLIP) оказался нестабильным при joint optimization

4️⃣ AgentENV — microVM-песочницы вместо контейнеров для RL. Firecracker VM: checkpoint за 133ms, resume за 49ms, memory overcommit 6.5×51.2 млн sandbox'ов за тренинг

5️⃣ MoonEP — expert parallelism с доказуемой верхней границей redundant-экспертов. Обучение работает 100% времени без остановок на балансировку
  • 🔥 13
  • 💯 3
  • 🏆 1
Older posts →

About this channel

How can I read @complete_ai without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Complete AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Complete AI have?
Complete AI (@complete_ai) has 7.86K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Complete AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →