TGViewer
Channel Public Channel
Сергей Марков: машинное обучение, искусство и шитпостинг

Сергей Марков: машинное обучение, искусство и шитпостинг

@oulenspiegel_channel

Машинное обучение, искусственный интеллект, искусство, мемасы, всякое личное и странноэ
Subscribers
11.1K
Photos
3.7K
Videos
425
Links
933
Recent Posts 19 shown
Post #5313 1.01K

Forwarded from На службе у машин

🤩 GigaCode Universal Agent теперь в open source — и в коде не уступает специализированным агентам 🤩

Мы собрали этого универсального агента не только, что писать код, но и решать бизнес-задачи. Он пригодится, если вы подбираете агента под свои рутины и хотите видеть, что происходит в каждом запуске.

🤩 ПРЕДСКАЗУЕМОЕ ИСПОЛНЕНИЕ

...
Каждый запуск воспроизводим:
▫️ на входе фиксируются задача, версия скилла, модель, инструменты и лимиты по токенам, шагам и времени;
▫️ на выходе агент отдаёт результат, артефакты, полный трейс, стоимость и статус.


🤩 БЕЗОПАСНОСТЬ

...
Агента удобно запускать в изолированной среде (Swarm-режим, только Linux), но можно и без изоляции — тогда write_guard по умолчанию не даёт ему писать за пределами папки запуска.


🧩 ВОЗМОЖНОСТИ

...
▫️ субагенты, скиллы и MCP из коробки;
▫️ режим CLI и серверная инсталляция;
▫️ в разработке автороутинг, который будет подбирать оптимальную модель под каждую задачу.


🤩 КОДИНГ

...
На модели Qwen3.6-35B-A3B агент набирает 65,7 % на SWE-bench Verified и 65,0 % на SWE-bench Multilingual. Это выше, чем у OpenCode и Qwen Code в тех же условиях.


Мы в команде уже используем агента — пишем код, анализируем данные, используем для поиска и решаем другие повседневные задачи.

Проверьте у себя: запустите агента в CLI на своей задаче и посмотрите трейс и стоимость прогона.

🔗 Репозиторий на GitVerse

#изнутри #опыт_ML #агенты #опенсорс
  • 👍 8
  • 🤔 3
  • ❤ 2
  • 🤣 1
Post #5312 1.51K

Forwarded from Dealer.AI

Мечтают ли нейромухи о нейроде*%ме.(с)

#meme
  • 😁 42
  • 🔥 12
  • ❤ 9
  • 💯 3
  • 👍 1
  • 😢 1
  • 🙈 1
Post #5311 2K
  • 💩 10
  • 😁 8
  • 🤡 4
  • ❤ 1
  • 👍 1
Post #5310 1.99K
Обсудили проблемы нашей цивилизации в прекрасной компании)
  • ❤ 23
  • 👍 9
  • 🤗 3
  • 😁 2
  • 👏 1
  • 🤝 1
  • 👾 1
Post #5309 2.21K
https://developers.sber.ru/portal/sreda/robo-drive-party

Робо Драйв Пати — закрытая встреча команды робототехники Сбера. Здесь можно познакомиться с инженерами и руководителями команд, которые создают современные продукты в робототехнике.

В программе — короткие выступления о реальных задачах в области Physical AI, ML, RL, Cyber Security и робототехники, а также возможность лично пообщаться с лидерами и ключевыми участниками команд, задать вопросы и узнать о проектах, над которыми они работают сегодня

21.09 19:00; 150 мест
  • 👍 4
  • ❤ 2
Post #5308 1.85K

Forwarded from Sber AI

17 сентября в Москве прошла AI R&D DAY — конференция для исследовательских команд и создателей ИИ-систем 🔥

Более 600 участников на одной площадке, 20+ докладов — концентрат практического опыта, знаний и инструментов, готовых к внедрению сразу по возвращении в офис. 
 
Обсудили альтернативные архитектуры, обучение моделей и AI-агентов, долгосрочную мультимодальную память, новые модальности и коммуникации, а также бенчмаркинг и стандарты качества AI


Среди спикеров — эксперты Сбера (Sber AI, Kandinsky Lab, Центра «ИИ для науки», Центра практического ИИ, Центра робототехники), института AIRI, Лондонского института практических наук, Национального суперкомпьютерного центра в Цзинани и другие создатели ИИ-систем.
 
Видеозаписи докладов уже доступны по ссылкам:
🤩Трек «ML & Research»
🤩Трек «Продуктизация R&D»


А если вы хотите стать частью исследовательского комьюнити Сбера, то переходите по ссылке 🤩

✔️ Подписывайтесь на Sber AI в МАКС
  • ❤ 10
  • 👍 6
  • 🔥 5
Post #5307 2.51K
  • 😁 53
  • 🤣 24
  • ❤ 3
  • ❤‍🔥 2
  • 🥴 2
  • ✍ 1
  • 👏 1
  • 😢 1
  • 🫡 1
Post #5306 2.5K

Forwarded from Баррель черной икры

Anthropic объявила инвесторам о сверхприбыльности своего бизнеса, если из него вычесть все ключевые расходы на ИИ-модели. Новую финансовую модель в сети оценили как PIZDA — Profit If Zero Distribution & AI-training (прибыль исключая затраты на дистрибуцию и анализ). @banki_oil
  • 😁 63
  • 🤣 44
  • ❤ 4
  • 🙈 3
  • 💯 1
Post #5305 2.79K
Смотрите, по обсуждаемым уходам специалистов по безопасности ИИ из DeepMind и Anthropic — меня просили прокомментировать, но я из-за нехватки времени ответил пока отпиской.
Естественно, после этих увольнений, жёлтая пресса тут же подхватила привычную шарманку про «МЫ ВСЕ УМРЁМ!!!1111», и кто-то даже стал из-за этого переживать.

Я вам сейчас примерную механику этих увольнений объясню, но прямо не хочется потом к этой теме возвращаться, поэтому, что называется, «один раз».

В действительности эти увольнения значат примерно одно: реально лаборатории оценивают риски как очень низкие. И вот почему.

Представьте себе, что вы молодой талантливый специалист, вам дают место, которое выглядит как «работа мечты». С высоких трибун, включая даже Капитолийский холм, все говорят о чрезвычайной важности проблемы безопасности ИИ. ИИ-риски, экзистенциальные угрозы, смерть мерзкая от Антропиков, гроб, гроб, кладбище, Сэм Альтман, Билл Гейтс, Илон Маск, nomen illis legio, имена их же, Господи, Ты Сам веси.

Итак, вас берут в топовую лабу, на самую горячую тему, на входе говорят: будет тебе дружный коллектив нобелевских лауреатов, тьма GPU, общественное признание и т. д.

И вот вы начинаете работать, делаете что-то, рисуете презы, разрабатываете гайды, гардрейлы, протоколы пишете, эксперименты проводите. И тут у вас потихоньку начинают забирать ресурсы — людей, GPU. Сначала говорят, что временно, потом временное происходит всё чаще, а где-то превращается в постоянное. Людей к вам в команду набирают по остаточному принципу, новые ставки не дают, GPU-бюджеты не растят, а то и режут в пользу экспериментов, направленных на улучшение позиций в ИИ-гонке. На ваши презы кивают, говорят: «Да, да, отлично, молодцы!», но проблема в том, что из ваших результатов скорее следует вывод о том, что чёрт не так страшен, как его малюют. Особо громкого пиара не выходит уже из ваших экспериментов, реальная опасность, как всем видно, скорее не экзистенциальная, а социальная (алгоритмическое неравенство, локальная техбезработица, усиление социальной сегрегации и пр.), в итоге вы понимаете, что ваша карьера идёт не туда. Обещали, но не женились, дело тухляк. И тут вы увольняетесь. А чтобы привлечь к себе внимание рынка труда делаете несколько громких заявлений — publicity, как говорится, is prosperity.

Если бы экзистенциальные риски реально были так велики, как кажется после прочтения материалов жёлтой прессы и думеров, то, поверьте, никаких уходов специалистов по ИИ-рискам из топовых компаний не было бы. Наоборот, был бы быстрый рост этих направлений, рост зарплат в них, ресурсов и т. д.
  • 👍 41
  • 🤔 14
  • 😁 9
  • ❤ 6
  • 🥴 4
  • 💯 4
Post #5304 3.52K
Ищем DS/AI Tech Lead → агентные системы на масштабе страны 🚀

Команда Департамента развития искусственного интеллекта и машинного обучения Сбера (Сбер AI) ищет технического лидера направления DS/AI.

Наши решения доходят до миллионов пользователей, а горизонт задач — не квартал, а несколько лет: мы участвуем в формировании технологической повестки в области ИИ и работаем над тем, как GenAI меняет целые отрасли. При этом путь от гипотезы до внедрения короткий — идея, проверенная сегодня, через квартал может оказаться в эксплуатации. И мы не варимся в себе: организуем AI Journey, одну из крупнейших в мире AI-конференций, и постоянно на связи с исследователями и индустрией.

Чем предстоит заниматься?

✅ Разрабатывать и валидировать модели под задачи агентов, доводить решения до внедрения
✅ Проектировать архитектуру агентных решений — оркестрация, планирование, tool use, память, мультиагентные сценарии
✅ Выстраивать оценку качества там, где готовых бенчмарков нет: метрики, автотесты сценариев, контроль надёжности
✅ Технически вести направление AI-агентов: от гипотезы и прототипа до продакшена
✅ Растить экспертизу команды и задавать технические стандарты направления.

Почему это интересно?

🔹 Передовой стек и ранний доступ к моделям Сбера — работаете с фронтиром, а не догоняете его
🔹 Агенты в реальной эксплуатации, а не в демо: сложные домены, интеграции, требования к надёжности
🔹 Задачи без готовых решений — типовые практики здесь заканчиваются на первом шаге
🔹 Техническое лидерство без потери рук: вы принимаете архитектурные решения и сами остаётесь в коде
🔹 Траектория роста — от технического лидера направления до владельца технологического портфеля
🔹 Видимость: AI Journey, публикации, выступления, сообщество практиков.

Ждём, если вы

🟢 Строили решения на LLM и понимаете, как устроены модели внутри
🟢 Проектировали агентные или сложные LLM-пайплайны и доводили их до продакшена
🟢Умеете принимать технические решения за направление и защищать их.

Как откликнуться?

📩 Контакты для отправки резюме в Telegram рекрутеру:
@skornyakova_sofya

#ai #ds #hiring
  • 👍 8
  • 😁 4
  • ❤ 1
  • 💯 1
Post #5303 2.52K
Мы тут засабмитили препринт про спекулятивное декодирование и гибридную архитектуру:

How Lossless Is Lossless Speculative Decoding? The Role of Numerical Precision in Orthrus

https://huggingface.co/papers/2609.15504 (https://huggingface.co/papers/2609.15504)

В ходе экспериментов обнаружили интересный эффект: выбор floating precision на инференсе ломает lossless-декодирование, но не просто портит его, а иногда немного улучшает на downstream задачах 🧐

Статья сейчас в процессе ревью. Будем благодарны за upvote, он поможет нам продвигать наши исследования по теме текстовых диффузионок
huggingface.co Paper page - How Lossless Is Lossless Speculative Decoding? The Role of Numerical Precision in Orthrus Join the discussion on this paper page
  • 👍 17
  • ❤ 3
  • 🔥 3
Post #5302 2.89K

Forwarded from RnD ML Team

🚀 3/3 EMNLP 2026 🚀

Три из трех (!!!) наши статьи по исследованиям жестовых языков (РЖЯ в частности) прошли на EMNLP 2026. Это была последняя переподача, до этого было несколько реджектов на другие крупные конфы. Спасибо всем причастным, кто работал над созданием статей, особенно наших бывших коллег @karinakvanchiani @TOOFACK и @lizaforlizard

О чем писали и какие ревью пришли?

🔤 Bukva: Russian Sign Language Alphabet
https://arxiv.org/abs/2410.08675

Bukva — открытый датасет изолированного дактиля (алфавита) русского жестового языка (РЖЯ). Он содержит 3757 видео (33 буквы, включая 8 динамических), записанных 155 дикторами. В качестве бейзлайнов использованы модели с модулем временного сдвига (TSM) на базе MobileNet/ResNet. Также представлено демо-приложение для обучения алфавиту.

➕ 155 участников — это огромный шаг вперед по сравнению со старыми датасетами РЖЯ (где было от 4 до 20 человек).
➕ Прозрачный пайплайн: Подробно описан процесс сбора, фильтрации и оплаты труда краудворкеров.
➕ Строгий контроль: Дикторы и валидаторы сдавали экзамен на знание РЖЯ.
➕ Качественный сплит train и test по дикторам (модель тестируется на людях, которых не видела при обучении, в других работах разбивка была случайна).

➖ Игнорирование специфики: динамическое буквы (главная фишка датасета) не оцениваются отдельно от статических.
➖ Слабые бейзлайны: Нет сравнения с современными трансформерами (за этом нам часто напихивают, но любой трансформер переобучится под этот сет)

👌 HandReader: Advanced Techniques for Efficient Fingerspelling Recognition
https://arxiv.org/abs/2505.10267

Эту статью приняли с очень высокими рейтингами: accept, clear accept, strong accept
Работа посвящена распознаванию дактиля американского жестового языка (ASL). Мы предлагаем семейство из трех моделей (RGB, скелетные точки и мультимодальная) с новыми архитектурными блоками: TSAM (для обработки видео разной длины без паддинга) и TPE (кодировщик поз). Модель устанавливает новый SOTA на бенчмарке ChicagoFSWild+.

➕ Работа с естественными данными, независимыми от диктора.
➕ TSAM легко решает проблему видео переменной длины (без обрезки и паддинга), что экономит память.
➕ Превосходит все предыдущие методы, обученные даже на больших объемах данных.

➖ Заявляем об «экономии 50% VRAM» и «легковесности», но не приводим ни одной цифры (нет замеров FLOPs, параметров, скорости инференса или потребления памяти).
➖ Слабая мультимодальность: простое суммирование фичей RGB и скелета дает минимальный прирост, что ставит под сомнение реальную взаимодополняемость модальностей.

👩‍💻 Znaki: A Russian Fingerspelling Recognition Dataset
Это первый непрерывный датасет дактиля РЖЯ. В отличие от Bukva (где буквы изолированы), здесь дактиль связан во фразы (в основном имена собственные). Датасет включает 37252 видео (35.4 часа) от 68 дикторов. Краудсорсинг с двухэтапной проверкой на знание РЖЯ.

➕ Уникальность: заполняет критический пробел, отсутствие датасетов именно непрерывного русского дактиля.
➕ Исключение утечек: жесткое разделение по дикторам и фразам между train/validation/test.
➕ Разнообразие: Записи сделаны в разных условиях (не только в студии)

➖ Отсутствие побуквенной разметки: Размечены только начало и конец всей фразы, что делает невозможным обучение точной временной сегментации букв.
➖ Синтетическая природа фраз: Фразы генерировались с помощью GPT-4o
➖ Узкий охват: Только имена собственные, нет чисел, аббревиатур или естественной разговорной речи.

🌟 Общее саммари по всем трем статьям
Все работы посвящены актуальной и сложной проблеме распознавания дактильной речи (fingerspelling). Две работы (Bukva и Znaki) фокусируются на создании датасетов для русского жестового языка (РЖЯ), который исторически страдает от нехватки данных, в то время как третья (HandReader) предлагает архитектурные улучшения для американского жестового языка (ASL).

Ну и главный плюс — работы в opensource! 🖥

#release #emnlp2026 #conference
  • 🔥 14
  • 🎉 13
  • ❤ 7
  • 👍 4
Post #5300 3.16K

Forwarded from RnD ML Team

До AI R&D DAY осталось меньше двух недель 📆

Обсудим альтернативные архитектуры, процессы обучения, память, бенчмаркинг и много чего ещё.

В преддверии конференции решили напомнить о регистрации и разыграть 2 проходки на мероприятие. Места в офлайне разлетаются быстро, но победителю мы гарантируем посещение 🔥

Условия розыгрыша просты:
— подписаться на наши с коллегами каналы
— пройти небольшой опрос в боте @RnD_DAY_Bot

Итоги подведём 14 числа отдельным постом 🤖
  • ❤ 5
  • 🔥 2
  • 😁 1
Post #5299 2.81K

Forwarded from Sber AI

ЕДИНСТВЕННАЯ РОССИЙСКАЯ ОТКРЫТАЯ МОДЕЛЬ С РЕЖИМОМ РАССУЖДЕНИЯ

Сегодня мы представляем GigaChat 3.5 Reasoning — новую флагманскую мультимодальную нейросеть, которая рассуждает последовательно: разбирает задачу на этапы, строит план, проверяет промежуточные результаты и исправляет собственные ошибки


Такой режим рассуждений — результат специального обучения, а собственная архитектура с технологией линейного внимания помогает эффективнее работать с длинным контекстом.

GigaChat 3.5 Reasoning тратит токены значительно экономнее ведущих открытых ИИ-моделей. Например, на решение математических задач она тратит в среднем на 37% меньше токенов, чем DeepSeek V4 Flash Preview.

Рост результатов новой версии по отношению к модели без режима рассуждения очевиден на бенчмарках:
🤖 IFBench — с 44 до 77 баллов
🤖 Natural Plan — с 64 до 80 баллов
🤖 Live Code Bench v6 — с 56 до 85 баллов

Подробнее о процессе обучения модели и результатах читайте в посте команды.

Модель можно использовать бесплатно по лицензии MIT:
🔗 Hugging Face
🔗 GitVerse

А в личных задачах модель уже можно попробовать в ГигаЧате — просто включите функцию «Рассуждение» в чате с нейросетью ↖️

✔️ Подписывайтесь на Sber AI в МАКС
  • 🔥 43
  • 🤣 12
  • ❤ 10
  • ❤‍🔥 7
  • 👍 3
  • 👏 1
  • 🤡 1
  • 💯 1
Post #5297 4.13K
Сегодня спонсор моего поста компания «Озон». В целом, мне Озон всегда более-менее нравился, хотя они и не смогли за 28 лет сделать фильтры или хотя бы сортировку в разделе «Заказы». Ну, штош, я понимаю, в наше время нормального UX'ера нанять трудно, а в вайбкод там пока не научились. Ну я не знаю, кароч, сломано и сломано, но я уже привык

Вы помните, наверное, прохладную историю с Ozon.Travel, про которую я писал раньше? В отличие от Яндекса, Ozon'у, в принципе, по-моему, всё равно абсолютно, что там про него пишут, но это же не повод не развлечь хотя бы вас очередным потребительским триллером.

В общем, в июле я съездил в славный город Ленинград, где поселился в двухместном номере вместе с женой. Поскольку поездка была связана с рабочей командировкой, работа, естественно, могла мне оплатить проживание моё, но не жены. Соответственно, бухгалтерии понадобилась справка, в которой было бы сказано, что либо цена на двухместный номер не отличается в зависимости от числа гостей (1 или 2), либо отличается, и составляет X при наличии одного гостя и Y при наличии двух гостей.

В общем, сегодня Озон мне отказал окончательно. Но не сразу, конечно, как вы понимаете, а спустя два месяца переписки, бюрократической волокиты, обращений, присылки мне другой, ненужной мне справки (просто сообщающей о том, сколько стоил наш номер) и проч., и проч., и проч. Дескать, отель такую справку не дал, а мы не можем. Причём цену-то покупателю назначает именно Озон, а не отель. Как вы понимаете, отель может давать цену номера, не зависящую от числа гостей, а Озон, напротив, зависящую и наоборот. Но снова «информационный сервис» не может предоставить информацию. Никогда не было, и вот опять...

Помните, как критиковали советскую бюрократию, рисовали в журнале «Крокодил» развесёлого крокодила, задорно пронзающего ягодицы бюрократов своими фирменными вилами? Где же ты, наш любимый крокодил? Где твои верные вилы? Чтобы пронзить упитанные жопки новоявленных капиталистических бюрократов? Нет, увы, куда там. Копитализом порешал. Конкуренция, повышение уровня сервиса, говорили они... В итоге породили такие исчядия ада и делириума, до которых советским бюрократам как от земли до неба...
  • 😁 42
  • 👍 17
  • 💯 9
  • 🤡 6
  • 😱 4
  • ❤ 2
  • ❤‍🔥 2
  • 💩 2
  • ✍ 1
  • 🔥 1
  • 😢 1
Post #5296 4.33K
  • 🤣 48
  • 🔥 12
  • 💯 7
  • ❤ 3
  • 😭 3
  • 👍 1
  • 👏 1
  • 😢 1
  • 😈 1
Post #5295 3.57K

Forwarded from RnD ML Team

🎧 Middle+ Speech Researcher / ML Engineer

Ищем ML-инженера, который активно работал с речевыми технологиями: ASR, TTS, омнимодальные речевые LLM.

🔬 Над чем сейчас работаем
🏗 Omnimodal Fusion — нативное объединение аудио, текста и визуала в едином латентном пространстве, без костылей
⚡️ Полноценный голосовой full-duplex streaming — архитектура для работы в реальном времени: детекция перебиваний, low-latency инференс, потоковое обновление контекста
🧠 Latent Reasoning — многошаговые рассуждения прямо в hidden state, без генерации промежуточных токенов

🛠 Чем предстоит заниматься
— Формулировать research-гипотезы и валидировать их
— Разбирать SOTA по omnimodal/full-duplex и находить точки для кратного апгрейда
— Писать код, который можно воспроизвести: конфиги, чекпоинты, model cards
— В случае успешных исследований, публиковаться на NeurIPS/ICLR/Interspeech и т.д. — опционально, но очень поощряем 📄

✅ Что ждём от кандидатов
— Понимание трансформеров и мультимодальных пайплайнов
— Опыт работы с аудио/визуальными фичами (speech, video)
— Качественный ML-код (а не только вайбкодинг), умение ставить эксперименты в multi-GPU режиме
— Умение быстро проверять смелые гипотезы

➕ Будет плюсом
— Публикации на A/A* конференциях
— Large-scale training (FSDP/DeepSpeed)
— Знание классического speech/vision ML

🔥 Если такая постановка задач будоражит — пишите.
📩 Куда слать резюме: @VeronikaShel

#найм #hiring #job
  • ❤ 6
  • 🔥 3
  • 👍 1
Post #5292 3.05K

Forwarded from Data Secrets

Саша делает стартап Сегодня мы вышли из stealth! Про нас написали Wired (с заголовком these russian mathematicians ахах), а еще мы опубликовали блог пост с описанием технологии. Все ссылки в этом посте, буду очень рада если сможете репостнуть и прокомментировать :) https:/…
Российские математики придумали модель, которая заняла первое место на ARC-AGI

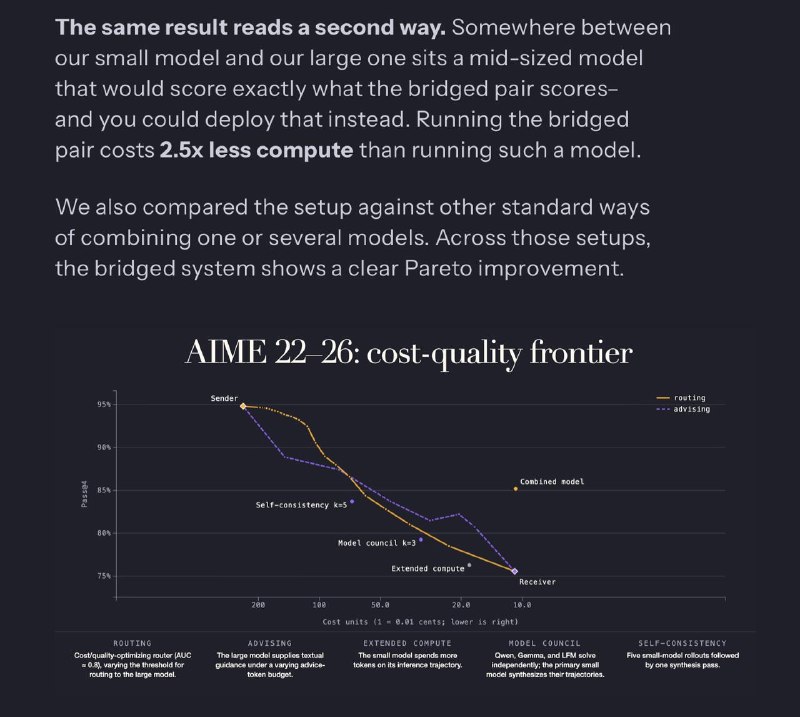
Небольшой стартап Mostik состоит из 15 человек, среди которых 12 PhD и Филдсовский медалист Станислав Смирнов. Компания существует всего 4 месяца, и только что вышла из стелса со своей идеей о новом подходе к ансамблированию. Ребята придумали, как модели могут обмениваться скрытыми состояниями.

Как это работает:

Языковая модель, генерируя один токен, строит огромные скрытые векторы. Это порядка миллиона чисел (~2 МБ). При этом в выхлоп попадает только ~17 бит – сам токен, а остальное выбрасывается.

Все системы, где модели общаются между собой (команды агентов, консилиумы и тд), общаются именно через этот узкий текстовый канал. При этом в отбрасываемой части остается море информации, описывающей все, что модель знает о задаче в этот момент. Это не только данные о текущем токене, но и о будущих (вспомните то же исследования Anthropic J-space: https://t.me/data_secrets/9497).

Идея Mostik – это, собственно, дать моделям "мостик", через который они смогут общаться полноценно, чтобы работать эффективнее. Они обучили небольшой модуль-переводчик, который передает скрытые состояния от одной модели к другой. При этом модели могут быть из разных семейств, их веса не меняются, и совсем никакого текста между ними не проходит.

Результаты:

Авторы взяли большую GLM-5.2 (753B) и маленькую Qwen-3.5 (4B), и сделали так, что GLM-5.2 только читает текст (это дешевле), а затем передает Qwen скрытое состояние через мостик, чтобы та уже генерировала токены. Разрыв в качестве у моделей огромный, но при таком сетапе закрывается 50% этой разницы. На некоторых задачах прирост в качестве получается в 2 раза, и при этом связка обходится в 2.5 раза дешевле по вычислениям, если пересчитывать результаты на эквивалентную среднюю модель.

Кроме того, "мостик" можно использовать для дистилляции или создания инструментов для мониторинга. Авторы также упоминают о том, что система на основе этого подхода предварительно заняла первое место на лидерборде ARC Prize этого года.

Поздравляем авторов с потрясающей работой и просим для них максимальной поддержки!

Статья Wired | Блогпост Mostik | Канал CEO Саши Малышевой
  • 🔥 83
  • 👍 29
  • ❤ 15
  • 👎 4
  • 😱 2
Older posts →

About this channel

How can I read @oulenspiegel_channel without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Сергей Марков: машинное обучение, искусство и шитпостинг: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Сергей Марков: машинное обучение, искусство и шитпостинг have?
Сергей Марков: машинное обучение, искусство и шитпостинг (@oulenspiegel_channel) has 11.1K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Сергей Марков: машинное обучение, искусство и шитпостинг know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →