TGViewer
Channel Public Channel
Dendi Math&AI

Dendi Math&AI

@dendi_math_ai

Канал Дениса Димитрова о математике и искусственном интеллекте. В основном разные интересные и актуальные новости и мысли
Subscribers
3.03K
Photos
41
Videos
38
Links
37
Recent Posts 13 shown
Post #122 2.17K
🤖 Всё никак не добирался написать, но новость интересная и точно заслуживает вашего внимания. Недавно мы выложили в открытый доступ Kandinsky WM 1.0 — линейку генеративных моделей для Physical AI

Один из больших трендов сейчас — развитие Physical AI Foundational Models (FM), которые способны полноценно моделировать физический мир.

И многие сильные команды приходят к Physical AI FM именно через видеогенерацию. Это довольно естественный путь: обучаясь на видео, модель получает представление о движении, динамике и взаимодействии объектов. Следующий шаг — связать эту модель с действиями агента. Отсюда, в частности, вырастает направление World Action Models: моделей, которые связывают действия робота с тем, как вследствие этих действий изменится наблюдаемый мир (и, наоборот, как выбрать оптимальное действие робота в соответствии с наблюдаемым / предсказанным поведением мира, среды).

При этом сама видеогенерация постепенно становится частью более широких omni-моделей. Например, Cosmos 3 от NVIDIA умеет работать с текстом, изображениями, видео, звуком, действиями на вход и на выход и может использоваться для разных robotics задач. Atlas от World Labs работает с текстом, изображениями, видео и 3D и позволяет восстанавливать реальные сцены и строить на их основе симуляции.

Мы развиваем Kandinsky в том же направлении: используем накопленный опыт в видеогенерации, чтобы строить модели для роботов и беспилотников. Kandinsky WM 1.0 — наш первый открытый релиз в этом треке. Мы выложили open source три специализированные модели:
🚗 K5-AV (Autonomous Vehicle) для генерации автомобильных сцен,
🦾 K5-RO (Robotics) для генерации различных сцен манипуляции с предметами,
🌍 K5-PH (Physics) для генерации сцен со сложной физикой в целом: движением людей, протеканием процессов и взаимодействием объектов.

Все модели получены дообучением нашей базовой модели генерации видео Kandinsky-5 Video Lite (2B). Модели умеют генерировать 5 секунд видео по первому кадру и текстовому описанию (то есть работают в режиме I2V).

Разрабатывали эти модели мы в первую очередь для генерации синтетических данных для обучения других моделей — в основном VLA — которые управляют роботами и беспилотными авто. Особенно важны тут редкие сценарии: сцены ДТП, видео экстремальной погоды или кейсы с отказом оборудования. Собирать такие данные в реальности дорого, очень сложно, а иногда и просто небезопасно. С помощью генеративной модели такие данные можно получасть практически неограниченно. Но у такого подхода есть и обратная сторона: если VideoGen модель неправильно воспроизводит физику, то в обучающие данные для VLA попадут ошибки. К сожалению, такого рода галлюцинации характеры для всех современных VideoGen моделей, потому что при их обучении больше фокусируются на эстетическом (визуальном) качестве, чем на физической достоверности.

Улучшить физичность по сути можно 2 способами: добавляя больше данных со сложной динамикой в претрейн и используя различные приёмы на этапе alignment (например, RL с физическими reward-моделями). Претрейн у нас уже был фиксирован (Lite), поэтому мы фокусировались на alignment: cначала делали SFT на качественных данных каждого домена (AV, RO, PH). Затем — RL с хитрыми reward-моделями за физическую достоверность (подробности можно почитать в статье на хабр)

⚡️По бенчмаркам: на Physics-IQ Verified для модели K5-PH получили рост общего score 16,0 (Lite) → 25,8 (Lite SFT PH) → 30,8 (K5-PH). Бенчмарк проверяет, как модели в режиме генерации видео продолжают реальный физический эксперимент по первому кадру. Домены экспериментов: механика твёрдых тел, динамика жидкостей, оптика, термодинамика и магнетизм.

Модели сейчас тестим с коллегами из Центра робототехники (ребята в том числе помогали с обучающими данными для K5-RO) и с AIRI в рамках развития симулятора XSIM World.

Веса и код моделей выложены под открытой лицензией MIT.
Полезные ссылки:
👉 Хабр
👉 GitHub
👉 HuggingFace

@dendi_math_ai
  • 🔥 18
  • 👏 6
  • ❤‍🔥 5
  • ❤ 1
  • 🫡 1
  • 😎 1
Post #115 1.06K

Forwarded from CV Time

Курс по Visual GenAI от Yandex Research и ШАД

Авторы CV Time не только пишут обзоры статей о компьютерном зрении, но и создают обучающие курсы.

Сегодня делимся курсом ШАДа «Генеративные модели в компьютерном зрении», который ведёт Дмитрий Баранчук, руководитель группы GenAI в Yandex Research, вместе с праймовой командой исследователей в этой области.

Будет полезно тем, у кого есть базовые знания по генеративкам и желание разобраться глубже:

• в теории диффузионных моделей, эффективных методах их обучения и семплирования;
• в новых гибридных моделях на основе диффузии для генерации изображений, видео и 3D.

У курса есть открытый GitHub-репозиторий, где можно найти слайды, записи лекций и семинаров, а также домашние задания.

CV Time
  • ❤ 13
  • 🔥 10
  • ❤‍🔥 6
  • 🥰 1
  • 😁 1
Post #114 1.94K
Dendi Math&AI В этом году я организую секцию GenCV в рамках DataFest 2026. Будут интересные доклады: о моделях генерации изображений, видео, 3D, о моделях мира, о VAE для токенизации мультимодального контента. Обсудим разные подходы при создании такого рода моделей (обязательно…
Сегодня в 12:00 продолжаем, но теперь онлайн: https://dion.vc/event/datafest-kb

Программа на сегодня вот тут
  • 🔥 7
  • 🤩 3
  • ❤ 2
  • 🤝 1
Post #113 2.09K
Dendi Math&AI В этом году я организую секцию GenCV в рамках DataFest 2026. Будут интересные доклады: о моделях генерации изображений, видео, 3D, о моделях мира, о VAE для токенизации мультимодального контента. Обсудим разные подходы при создании такого рода моделей (обязательно…
Подключайтесь послушать:

Секция GenAI
Секция GenCV

Вот тут программа
  • ❤ 11
  • 🔥 7
  • ⚡ 4
  • 👏 1
Post #112 2.72K
В этом году я организую секцию GenCV в рамках DataFest 2026. Будут интересные доклады: о моделях генерации изображений, видео, 3D, о моделях мира, о VAE для токенизации мультимодального контента. Обсудим разные подходы при создании такого рода моделей (обязательно — омнимодальность 😉), поговорим про инженерные сложности pre-train, alignment (SFT, RL) и про то, как добиться real time генерации видео, затронем нюансы сбора и фильтрации данных. Конечно, обсудим применения моделей генерации изображений/видео и их потенциал в настоящем и будущем. В общем, будет интересно и полезно! 💪

Сегодня последний день, когда можно подать доклад. Так что если есть релевантные темы, скорее подавайте заявку, и буду рад вас видеть. Или просто приходите послушать доклады и понетворкать
  • 🔥 14
  • ⚡ 7
  • 👍 2
  • 👏 2
  • ❤ 1
  • 😁 1
Post #111 1.73K

Forwarded from if-else

А вы знали, что методы генерации видео можно использовать для прогноза погоды?

Наша команда разработала Marchukпервую в России генеративную модель для прогнозирования климатических рисков.

Мы взяли диффузионные трансформеры (которые обычно генерируют изображения и видео) и научили их предсказывать погоду. И вот что получилось:

✔️Субсезонный диапазон: Marchuk позволяет строить прогнозы на 15-30 дней вперёд
✔️Компактная модель: имея всего 276M параметров, она показывает сопостовимое качество с 1,6B аналогом
✔️Доступность: Код и веса модели в открытом доступе, а запустить ее можно всего на одной видеокарте или в Colab

💡 Имя модели — дань уважения математику Гурию Ивановичу Марчуку, заложившему основы численного моделирования климатических процессов.

👇 Читайте подробности о разработке по ссылкам:
ArXiv | Project Page | GitHub | Colab | HF
  • ❤ 17
  • 🔥 9
  • 👍 3
  • 🤔 2
  • 😁 1
Post #110 1.98K

Forwarded from Институт AIRI

Приглашаем на пятый Большой Семинар AIRI, который пройдёт 16 апреля в 17:00 ⤵️

Хотим поделиться с вами, что у Института AIRI тоже юбилей — в этому году нам исполняется пять лет. Готовимся праздновать ❤️

Докладчиком выступит доктор экономических наук, декан и профессор экономического факультета МГУ им. М. В. Ломоносова, заведующий кафедрой прикладной институциональной экономики Александр Александрович Аузан.

Тема выступления: «Новая гипотеза образования в эру ИИ».

Модератор Большого Семинара AIRI — доктор физико-математических наук, профессор РАН, генеральный директор AIRI, декан факультета искусственного интеллекта МГУ Иван Оселедец.

📌Подробное описание лекции и регистрация на очный формат по ссылке. Трансляция пройдёт в VK Видео и на YouTube. Сбор гостей начинается с 16:30.

До встречи!
  • 🔥 9
  • ❤ 5
  • 😁 1
  • 👌 1
Post #106 8.9K
⚡️Коллеги из Центра Робототехники Сбера на этой неделе опубликовали техрепорт по Green-VLA. Это 4B staged vision–language–action (VLA) модель для generalist-роботов и, в первую очередь, конечно же для робота Грина 😎 Его как раз и делают ребята — они представляли Грина и довольно подробно про него рассказывали (особенно в части железа и контрола) на AI Journey в конце ноября 2025

В статье подробно разобрано, что именно помогает VLA моделям не разваливаться в реальном мире и быть устойчивыми к изменению сред и робот-платформ. На самом деле, это всё очень сложные задачи (например, картины по разным причинам рисовать «проще» 😄 — в смысле, картинки генерировать). У человека способности уверенно оперировать в физическом мире, в том числе подстраиваться к незнакомым средам, выполнять там сложные задачи, в конце концов пространственно ризонить, развивались миллионы лет в процессе эволюции: средний человек, например, почти не приложит никаких усилий для того, чтобы «в совершенно незнакомой квартире (например, у новых друзей) найти кухню и заварить там чашечку кофе». Стив Возняк к слову предложил именно эту задачу как тест на human-level embodied AGI (неспроста 💯)

В случае роботов (и, конкрентно, VLA, которые действиями роботов управляют) этого прогресса исследователям фактически надо добиваться «с нуля» (на самом деле, не совсем так — ведь есть фундаментальные модели почти на все случае жизни: языковые, мультимодальные, модели генерации изображений и видео)

В общем, в процессе исследований коллеги из Центра Робототехники:
🔘разработали пятиступенчатый пайплайн обучения (он даёт роботу возможность надёжно выполнять разные задачи в реальном мире):
L0 (тут берётся базовая обученная VLM-ка)
L1 (дополнительная стадия дообучения для лучшего понимания моделью физики мира, прокачивание пространственного ризонинга)
R0 (ещё одна стадия претрейна на 3,000+ часах видео с широкого класса роботов)
R1 (тюн уже под конкретного робота)
R2 (RL-based policy alignment — даёт дополнительную робастность при выполнении роботом сложных инструкций)

🔘показали, как эффективно выучивать и использовать единое action-пространство для разных робот-платформ (необходимо, чтобы перенос между эмбодиментами был системным и масштабируемым);
🔘показали SOTA результаты на разных бенчмарках: Simpler/BRIDGE WidowX, CALVIN ABC→D и на реальном Green Humanoid

🧩 Из планов — мы с ребятами уже проводим совместную работу по генерации синтетики с помощью семейства моделей Kandinsky, чтобы ещё сильнее увеличить generalization Green-VLA и расширить покрытие «редких» сценариев (которые по естественным причинам сложно и дорого собирать в реальном мире)

По хорошей традиции ребята залетели в топ Daily Papers на HF 🤗 Они уже давно топ-1 среди статьей дня и недели и топ-2 в рейтинге месяца. Считаю, что надо помочь ребятам стать топ-1 по месяцу — работа получилась очень хорошая. Если вам техрепорт тоже показался полезным, обязательно ставьте upvote ⬆️

И ещё раз все полезные ссылки:
👉 Upvote ставить тут
👉 ArXiv
👉 Project Page
👉 GitHub
  • 🔥 21
  • ❤ 17
  • 👍 8
  • 😎 2
  • 👏 1
  • 🏆 1
Post #104 14.5K
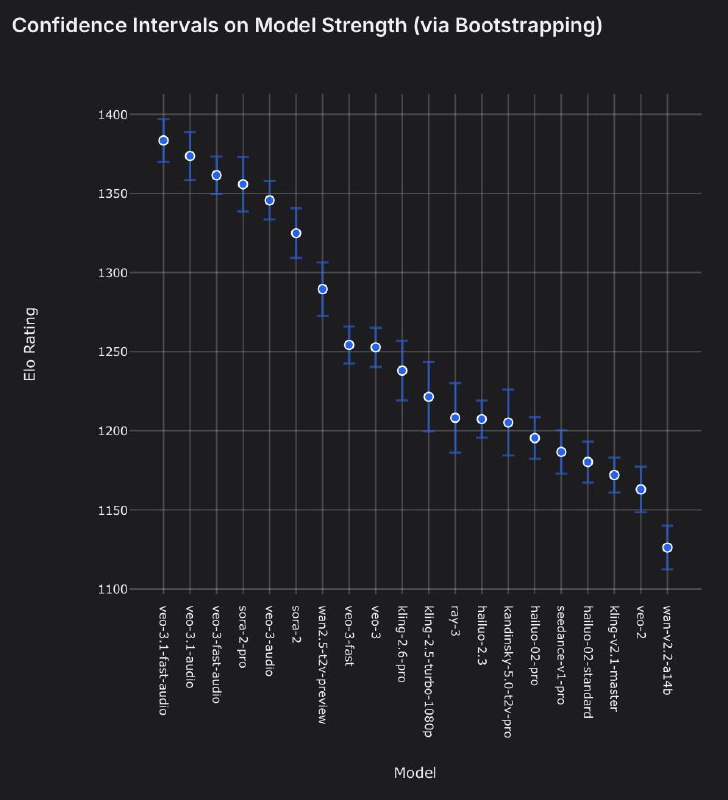
🥳 Мы докатили в text-to-video арену две наши последние модели генерации видео Kandinsky 5.0 Video Lite и Pro

⚡️Результаты следующие:
🔘Pro версия является ТОП-1 опенсорсом в мире (см. модели с лицензиями MIT, Apache 2.0 в лидерборде)
🔘Lite версия лучше первой версии Sora (не супердостижение, но у Lite всего 2B параметров)
🔘Лучше нас (Pro) только Google (Veo 3.1, Veo 3), OpenAI (Sora 2), Alibaba (Wan 2.5), KlingAI (Kling 2.5, 2.6) — объективно самые сильные модели генерации видео в мире на текущий момент; в паритете с нами Luma AI (Ray 3), MiniMax (Hailuo 2.3) — отрыв по ELO максимум 3 балла, при 95% доверительном интервале оценивания +-21 балла
🔘В целом стоит отметить, что для российских генеративных моделей выход на международную арену — довольно уникальное событие

🚀 Полезные ссылки:
🔘Посмотреть весь лидерборд можно вот тут: lmarena
🔘Твиттер организаторов арены: X lmarena.ai
🔘Почитать подробнее про Kandinsky 5.0: пост, техрепорт,
🔘Потестить Kandinsky 5.0: github и hf

@dendi_math_ai
  • 🔥 70
  • ❤ 22
  • 👍 16
  • 🤔 2
  • 😁 1
  • 👌 1
Post #103 11.3K
Салют, Гига! — уже сегодня

Обещал вернуться с программой — вот она.

Моя команда приготовила на эту конференцию большое количество материалов в формате докладов, воркшопов, постеров и стендов. Фокус — на синтез мультимедийного контента (изображений, видео, синхронного аудио) с помощью новых моделей Kandinsky. Успеем рассказать почти всё (и продемонстрировать это на практике)

Поговорим:
🔘об архитектуре, инфраструктуре и деталях обучения нового семейства моделей генерации изображений и видео Kandinsky-5: как этапа pre-train, так и alignment (SFT и RL);
🔘о способах дообучения Kandinsky-5 для персонализации и добавления новых сущностей, а также для более качественного управления камерой;
🔘о том, как мы готовили датасет для pre-train и alignment моделей Kandinsky-5;
🔘об ускорении диффузионных моделей в разы — с помощью диффузионной дистилляции;
🔘о добавлении синхронного аудио к видео при генерации;
🔘о разработке и применении метода разреженного внимания NABLA (Neighborhood Adaptive Block-Level Attention) для ускорения инференса и обучения моделей Kandinsky-5;
🔘о K-VAE, которые нужны для кодирования и декодирования изображений и видео и которые крайне необходимы для обучения core-модели;
🔘даже о моделях мира, которые строятся поверх моделей генерации видео;
🔘и, конечно, о будущем моделей генерации изображений и видео, вызовах, которые стоят перед их разработчиками, и о некоторых их применениях

Кроме того, коллеги из GigaChat и GigaData подготовили огромное количество очень интересных выступлений и докладов про разработку и обучение семейства языковых моделей GigaChat, а также про данные, которые для этого необходимы. А организаторы уложили это в концепцию целого ГигаГорода

В общем, будет очень насыщенно, интересно и полезно!

Участие бесплатное, но нужна регистрация. К сожалению, оффлайн регистрация уже закрылась, но ещё можно запланировать и подключиться онлайн (мой собственный доклад в 14:00)

Увидимся! 🚀
  • 🔥 9
  • ❤ 6
  • 👍 6
  • 😁 3
  • 👏 1
  • 🕊 1
Post #102 8.15K
Кстати говоря, за последнюю неделю наш техрепорт сначала взял топ-1 за день, потом за неделю, а сейчас уже и за месяц (ноябрь) в рейтинге Daily Papers на HF 🤗, причём с хорошим отрывом. Осталось продержаться 3 дня :)
  • 🔥 35
  • 🫡 14
  • 👏 8
  • 👍 4
  • 😁 2
Post #101 13.3K
Всем привет!

В дополнение к нашему подробному техрепорту по линейке моделей Kandinsky 5.0 на английском сегодня мы выпустили статью на Хабр на русском 🔥

Там найдёте ещё больше подробностей разработки наших моделей, примеров их использования и разных применений!

👉 Ещё раз ссылка на статью на Хабр
👉 Ссылка на техрепорт

@dendi_math_ai
  • 🔥 20
  • ❤ 5
  • 😁 3
  • 🎉 3
  • 👍 2
  • ❤‍🔥 1
Post #100 7.69K
Older posts →

About this channel

How can I read @dendi_math_ai without a Telegram account?
TGViewer shows the public web preview Telegram publishes for Dendi Math&AI: recent posts, photos, videos and the subscriber count, with no app, login or account.
How many subscribers does Dendi Math&AI have?
Dendi Math&AI (@dendi_math_ai) has 3.03K subscribers on Telegram, refreshed roughly every 30 minutes.
Does Dendi Math&AI know I viewed it here?
No. Public channel previews carry no viewer identity, and TGViewer has no accounts or tracking of what you look up.
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →