TGViewer
Channel Public Channel
Книжный куб

Книжный куб

@book_cube

Канал Александра Поломодова (@apolomodov), cto & technical fellow.

https://polomodov.tech - сайт со всеми материалами
youtube.com/@tellmeabouttech - канал со всеми видео
Subscribers
15.8K
Photos
3K
Videos
6
Links
2.5K

Showing posts older than #4925 · Back to latest

Older Posts 14 shown
Post #4924 3.03K
Code of Leadership S2E20: Где у CTO больше свободы — в стартапе или корпорации с Кириллом Евсеенко (Рубрика #Leadership)

В стартапе CTO может утром принять решение, а вечером увидеть его в продукте — но людей, денег и времени почти всегда не хватает. В корпорации ресурсов гораздо больше, но любое серьёзное изменение приходится проводить через множество зависимостей.
Так где в итоге больше свободы? И что важнее — свобода принимать решения или способность реально менять большую систему?

11 сентября в 18:00 МСК будет новый прямой эфир Code of Leadership с Кириллом Евсеенко — CTO музыкального сервиса «Звук».

Кирилл начинал с заправки картриджей и системного администрирования, работал над туристическими сервисами и медицинским стартапом, руководил технологиями и продуктом в START, а теперь — CTO «Звука». Поэтому стартап и корпорацию будем сравнивать не по привычным мемам про скорость и бюрократию, а по реальным решениям, ограничениям и цене ошибки. У Кирилла есть свой канал @tak_ya_vse_pridumal

Поговорим о том:

• какие привычки из стартапа помогают на большом масштабе, а какие превращают самого CTO в узкое место;
• где согласования действительно защищают от дорогой ошибки, а где просто размывают ответственность;
• какие решения CTO должен оставлять за собой, а какие принципиально не должен принимать;
• как перейти от личного контроля к системе сильных лидеров и при этом не потерять контакт с инженерной реальностью;
• что вообще происходит со скоростью, ответственностью и влиянием руководителя, когда команда вырастает от десятков до сотен человек.

Отдельно проверим формулу «быстрый стартап — медленная корпорация». Возможно, с ростом масштаба скорость никуда не исчезает. Просто раньше ты ускорял компанию тем, что быстро действовал сам, а теперь — тем, что создаешь систему, в которой сотни людей могут быстро принимать хорошие решения без тебя.

И попробуем ответить на главный вопрос: в какой момент технический руководитель перестает быть главным инженером и становится CTO?

Приносите в комментарии вопросы Кириллу и свои истории перехода между стартапами и большими компаниями.

#Management #Leadership #Career #Strategy #Engineering #Podcast #Strategy #Startup #Enterprise
YouTube Code of Leadership S2E20: Где у CTO больше свободы — в стартапе или корпорации с Кириллом Евсеенко В стартапе CTO может утром принять решение, а вечером увидеть его в продукте — но людей, денег и времени почти всегда не хватает. В корпорации ресурсов гораздо больше, но любое серьёзное изменение приходится проводить через множество зависимостей. Так где…
  • ❤ 3
  • 👍 3
  • 🔥 2
Post #4923 2.55K
Приходите на новый подкаст «Где профит от данных, Лебовски?» о данных и их ценности для бизнеса. Первый выпуск будет ключевым и будет посвящен теме «Превращаем данные в деньги: что это значит и какие есть варианты».

Обсуждать будем втроем
- Андрей Цыбин - взгляд со стороны продуктовой аналитики и онлайн-экспериментов
- Николай Голов - взгляд со стороны дата-архитектуры и продуктовой разработки платформы данных
- Александр Поломодов - взгляд со стороны software архитектуры, AI4SDLC и инженерного лидерства

#Data #Database #Analytics #Money #Metrics #Business
YouTube Превращаем данные в деньги: что это значит и какие есть варианты Запускаем новый подкаст «Где профит от данных, Лебовски?» о данных и их ценности для бизнеса. Авторский состав такой - Андрей Цыбин (https://smartdataconf.ru/archive/2024/persons/4e7d3c49c77144f69b3c5637d52252df/) - взгляд со стороны продуктовой аналитики…
  • ❤ 7
  • 🔥 6
  • 👍 2
Post #4922 2.42K
Stanford MS&E435: Baseten и как юнит-экономика меняет стратегию (Рубрика #AI)

В беседе Apoorv Agrawal с Тухином Шриваставой, сооснователем Baseten, из стэнфордского курса Economics of the AI Supercycle мне понравилась история о том, как рост бизнеса заставляет пересматривать архитектуру. Сначала компания берёт готовые API, потом обзаводится своими моделями. А её инфраструктурный провайдер тем временем начинает задумываться о собственных GPU. У обоих постепенно меняется ответ на вопрос: что мы можем делегировать?

На старте логика понятная: run fast. Берёшь топовую модель провайдера, собираешь продукт, проверяешь спрос. Пока непонятно, нужен ли кому-то твой сервис, строить команду эксплуатации моделей довольно дорого. Гораздо полезнее быстро выяснить, за что люди готовы платить.

Дальше появляются пользователи, повторяющиеся задачи и счёт за инференс. Тут начинается run effective: имеет смысл взять модель с открытыми весами и дообучить под свой сценарий. Универсальность большой модели оплачивается в каждом запросе, хотя конкретному продукту нужна лишь часть её возможностей.

По оценке Шриваставы, открытые модели можно запускать на 70–90% дешевле передовых закрытых. Это оценка спикера, а не обещание такой экономии любому продукту. Считать придётся стоимость успешно выполненной задачи, включая обучение, проверки качества, повторные попытки и работу команды. При достаточном объёме экономия начинает окупать всю эту возню.

Но между «скачать веса» и «отвечать за работающий сервис» лежит отдельная профессия. Нужны люди, которые подготовят данные, дообучат модель, развернут её, добьются нужной задержки и будут разбираться, почему ночью всё упало. Здесь появляется Baseten: по описанию Шриваставы, платформа берёт на себя инфраструктуру обучения и инференса. Клиент приносит данные и определяет, что считать хорошим результатом. Понимание собственного продукта делегировать сложнее.

К экономике добавляется конкуренция. Вот наглядный пример не из лекции.
Anthropic поставляет модели разработчикам приложений и одновременно развивает Claude Code, который работает с той же аудиторией, что и Cursor. Поставщик вполне может захотеть сам продавать конечный продукт. При этом собственные модели Cursor появились ещё до Claude Code: Tab работает на кастомной модели с марта 2024 года. Позже компания представила Composer 2 на базе Kimi K2.5, с дополнительным предобучением и reinforcement learning. Кстати, Baseten действительно работает с Cursor, хотя из этого не следует, что весь его инференс обслуживается там.

Я бы отделял эту конкуренцию от страха, что провайдер обучится на твоих данных. Использование данных регулируется условиями работы; у Anthropic для коммерческого API уже действует отказ от обучения по умолчанию. Но такой запрет не мешает поставщику самостоятельно выйти на твой рынок. Собственные модели дают больше контроля над себестоимостью и развитием продукта.

И дальше та же история повторяется этажом ниже.

Baseten строит программную платформу поверх чужих облаков: оптимизирует инференс, собирает доступные мощности, обеспечивает отказоустойчивость. По словам Шриваставы, дефицит GPU заставляет компанию двигаться к владению частью оборудования: нужно гарантировать ресурсы под будущую нагрузку клиентов. Вместе с железом появляются расходы на его покупку, риск недозагрузки и устаревания. При дефиците посредник, умеющий находить мощности у разных поставщиков, становится особенно полезным. Но если ты обещаешь клиенту надёжную услугу, в какой-то момент приходится брать под контроль поставку критического ресурса. Через долгосрочную аренду, собственное оборудование или сочетание обоих вариантов.

Получается симметрия: Cursor наращивает контроль над моделями, Baseten — над вычислениями. Масштаб меняет границу между тем, что удобно покупать как услугу, и тем, за что уже приходится отвечать самому. И эту границу полезно пересматривать вместе со счётом за инфраструктуру.

#AI #Architecture #PlatformEngineering #Product #Management
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Applications, Applied AI For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education This seminar covers applications, applied AI, and agent monetization. Follow along with the course schedule: https://mse435.stanford.edu/ Guest…
  • ❤ 4
  • 🔥 2
  • 👍 1
Post #4921 2.59K
TokenOps: как управлять бюджетом всего AI-agent run (Рубрика #AI4SDLC)

Недавно я писал, почему token burn полезен как финансовая телеметрия, но опасен как доказательство ценности. В 21-минутном докладе «FinOps for AI Agents: Who Spent All the Tokens?» два инженера Microsoft, Tisha Chawla и Susheem Koul, заходят с другой стороны: если стоимость всё-таки нужно контролировать, как делать это во время работы агента, а не после счёта от провайдера?

Их ответ — TokenOps, ранний open-source prototype и reference architecture, а не продукт Microsoft или Azure. Главный тезис мне кажется правильным: единицей управления должен быть весь run, а не отдельный LLM-запрос. Одна агентная задача проходит через модели, tools и subagents; обычный per-request лимит видит фрагменты, но теряет общую стоимость и причинность.

TokenOps добавляет к исполнению несколько вещей:

- Единый run_id проходит через model и tool calls, а расходы складываются в общий ledger;
- Бюджеты и policies назначаются сегментам: пользователю, команде, workload или типу запуска;
- Control plane возвращает одно из решений: ALLOW, STEER или HALT;
- Preview mode сначала показывает, какие правила сработали бы, но ничего не ломает.

Самая интересная идея здесь — по возможности STEER before HALT. Жёсткий стоп сохраняет бюджет, но уничтожает уже почти готовый результат. Поэтому систему предлагают корректировать раньше: сократить число RAG-chunks, ограничить tool output, сжать контекст, попросить модель отвечать короче или остановить бесполезный loop. В демонстрации retrieval вернул 20 фрагментов, хотя полезны были первые пять: governor может оставить пять ещё до следующего дорогого вызова модели.

Это не магия поверх шлюзов. Приложение нужно инструментировать: размечать границы и оборачивать вызовы, чтобы control plane видел структуру run. Зато решение о политике остаётся снаружи бизнес-логики, а исполняется там, где ещё можно изменить траекторию агента.

Авторы показывают и собственный benchmark на Browser Use и MetaGPT: сумма spend по 27 scored trials снизилась с $1.839 до $0.388, то есть на 78.9%, а число успешных запусков внутри бюджета выросло с 18/27 до 26/27. Но это пока иллюстрация PoC, а не доказанный production ROI: сценариев всего три, они специально подобраны для демонстрации ловушек, независимой репликации нет. Есть и несостыковка: в устном рассказе baseline назван простым throttling, а статья и таблица сравнивают TokenOps с vanilla/ungoverned запуском. Поэтому здесь важнее направление эффекта, чем красивый процент.

И ещё одна граница. Доклад начинается с перехода от token maxing к value maxing, но value-aware слой авторы пока не построили. Текущая система дисциплинирует стоимость; «задача завершилась внутри бюджета» ещё не означает, что ответ верный или полезный. Следующий взрослый шаг — связывать такой ledger с evals, риском и rework и считать cost per accepted task.

Я бы рекомендовал запись платформенным командам, которые уже запускают агентов в production. Не как готовый продукт, а как архитектурный checklist: стабильный run_id, прозрачная атрибуция, per-run budget, preview policies, ранний steering и hard stop только последним рубежом.

#AI4SDLC #AI #Agents #FinOps #Engineering #PlatformEngineering
YouTube FinOps for AI Agents: Who Spent All the Tokens? — Tisha Chawla & Susheem Koul, Microsoft Turning the full policy suite on cut average agent spend by about 78% across benchmark runs on two open source repos, and lifted the share of runs that actually completed from 67% to roughly 96%. That second number is the point. Simple throttling holds the…
  • 👍 7
  • ❤ 5
  • 🔥 3
  • 😱 1
Post #4920 2.56K
Материалы 3 AImigo S1E4: AI нанимает AI. Как пересобрать IT-собеседования? (Рубрика #AI)

Готовы материалы четвёртого выпуска 3 AImigo, который вышел 4 сентября. Вместе с Евгением Сергеевым и Алексеем Литвиновым (@tip_podcast) мы разбирали довольно неудобную конструкцию: AI уже сидит по обе стороны собеседования, а сам процесс всё ещё пытается измерять кандидата линейкой из мира до агентов.

Запретить AI на интервью кажется простым решением, но оно проверяет человека в среде, не похожей на будущую работу. Разрешить AI и засчитать красивый результат — тоже слабый фильтр. Поэтому главный вопрос выпуска не «можно ли пользоваться агентом», а «какие сигналы действительно предсказывают работу в конкретной роли».

Обсудили:
- Почему привычная воронка из резюме, кодинга, систем-дизайна и поведенческих вопросов всё хуже отделяет инженерную способность от умения готовиться к интервью;
- Как пересобрать найм как eval-систему: сначала описать результат роли и нужные признаки, а затем проверить, что каждый этап измеряет именно их;
- Зачем разделять AI-off и AI-on части. Без AI — смотреть на фундамент и самостоятельное рассуждение; с AI — на постановку задачи, сбор контекста, выбор процесса, проверку ответа и ответственность за результат;
- Как превратить систем-дизайн из рисунка на доске в задачу в песочнице: развернуть сервис, дать нагрузку, найти заложенный сбой и защитить решение. Но здесь остаётся трудная часть — калибровка интервьюеров и признание корректных нестандартных решений;
- Почему product, platform и R&D-инженерам нельзя механически выдавать одинаковые пороги: домен, неопределённость и цена компромисса у них различаются;
- Что меняется для кандидата, когда узкая специализация дешевеет, а поиск работы становится отдельным проектом — с исследованием компаний, собственной воронкой, адаптацией резюме, сетью контактов и внутренней мобильностью.

При этом AI может помочь обеим сторонам сузить выбор, но культуру, доверие и финальное обязательство по-прежнему сверяют люди. Автоматизировать подбор — ещё не значит автоматизировать решение о совместной работе.

Все материалы выпуска:

- Страница выпуска: содержание, таймлайн и все форматы
- Видео: YouTube, VK Видео
- Аудио: Podster, Яндекс Музыка, Apple Podcasts
- Текст: русский конспект

Если вы нанимали или сами проходили собеседование с AI, расскажите: какой этап дал реальный сигнал, а какой просто проверил умение пройти интервью?

#AI #AI4SDLC #Engineering #Management #Evals #Interview #Podcast
polomodov.tech AI нанимает AI. Как пересобрать IT-собеседования? — 3 AImigo AI уже участвует в найме с обеих сторон, поэтому запрет инструмента не возвращает старый сигнал: резюме и привычные онлайн-этапы всё хуже предсказывают работу в роли.
  • ❤ 7
  • 👍 5
  • 🔥 2
Post #4919 2.63K
Code of Leadership S2E19: Первые 90 дней CTO (Рубрика #Management)

В среду в 11:00 расскажу в прямом эфире про первые 90 дней технического директора. Начну с небольшого переворота: первый рабочий день — уже середина перехода. В докладе разберу весь маршрут:

- Как выбирать задачу, а не красивый шилдик;
- Зачем до выхода договориться о полномочиях, ресурсах и критериях успеха;
- Почему первый месяц лучше потратить на сбор реальной карты компании, а не на формирование портфеля изменений;
- Как к 90-му дню выбрать одну-две системные ставки, показать первый результат и не пропустить красные флаги.

Это не универсальный чек-лист «успешного успеха», а практическая модель: исследование → взаимный контракт → диагностика → первые изменения. И ещё: компания в эти три месяца тоже проходит испытательный срок.

#Management #Leadership #CTO #Engineering #Career
YouTube Code of Leadership S2E19: Первые 90 дней CTO В среду в 11:00 расскажу в прямом эфире про первые 90 дней технического директора. Начну с небольшого переворота: первый рабочий день — уже середина перехода. В докладе разберу весь маршрут: - Как выбирать задачу, а не красивый шилдик; - Зачем до выхода…
  • 🔥 10
  • 👍 7
  • ❤ 4
Post #4913 2.58K
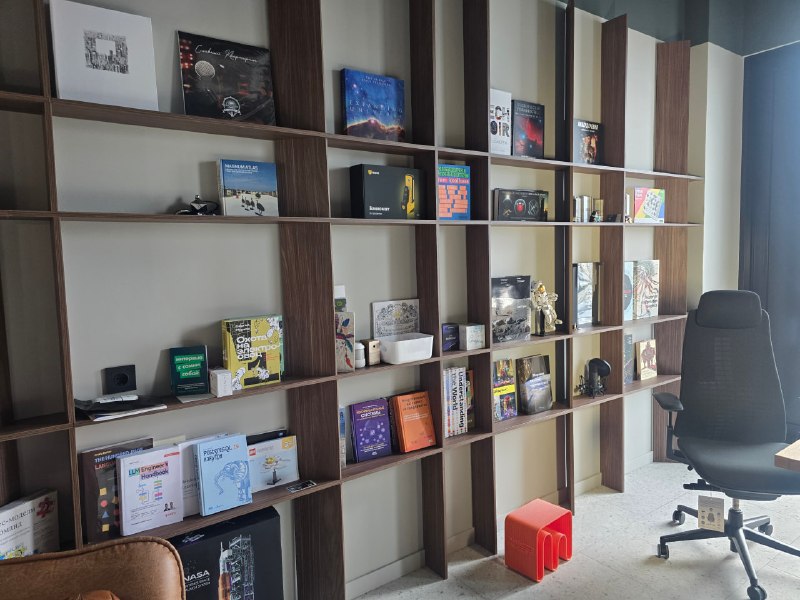
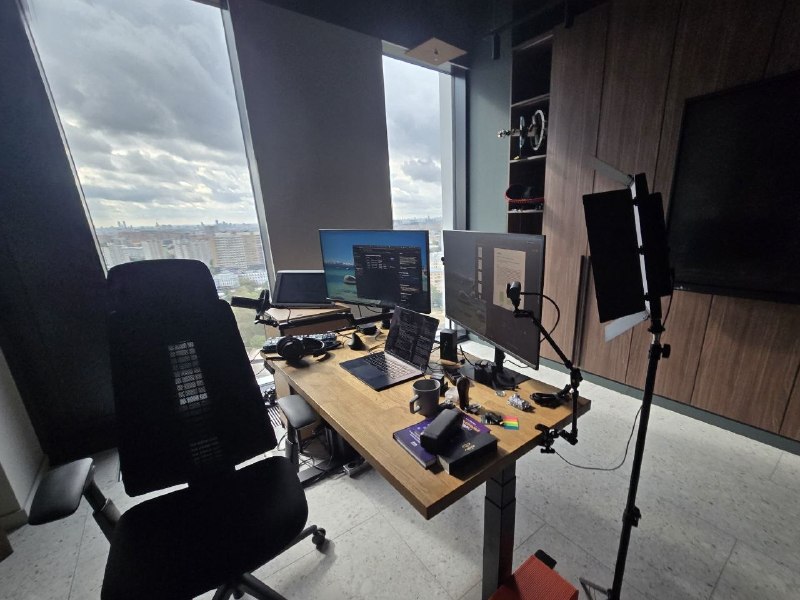
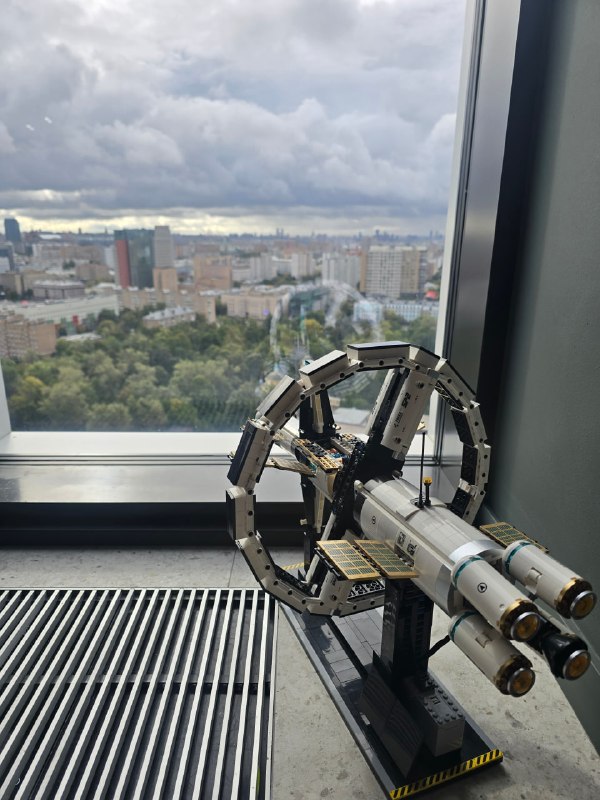
Новый офис

Доехал сегодня в свой офис, чтобы записать выпуск подкаста с соведущими. И хоть я сейчас стараюсь все подкасты проводить в прямом эфире, но отпуски никто не отменял - в итоге, мы решили записать пару серий про запас и выпустить их по расписанию и без пропусков.

Но рассказать я хотел про офис, который получился супер-комфортным и удобным для меня. Спасибо моей жене, что нашла дизайнера, строительную компанию и курировала ремонт. В итоге, офис получился отличным - у меня есть своя рабочая зона + место для оффлайн-подкастов - мне здесь нравится больше, чем в моем прошлом кабинете, что был у меня пока я работал в корпорации. А за стеной кабинет жены, который выполнен в более теплых тонах и который выглядит более милым и уютным:)

Грустно будет прощаться с этим кабинетом при переезде в Лондон, но ближайшие пару месяцев я планирую ходить сюда как на работу и заниматься своими проектами:)
  • 🔥 44
  • ❤ 20
  • 👍 8
  • 👎 1
  • 👏 1
  • 💔 1
Post #4912 2.59K
Stanford MS&E435: кто выбирает технологический стек — разработчик или кодинговый агент? (Рубрика #AI)

«Я вообще не знаю, что такое Vercel. Мой агент привёл меня сюда». Так, по словам Guillermo Rauch, написал ему в личку в X один из новых клиентов, столкнувшийся с ошибкой. В одной фразе — новая экономика дистрибуции софта: человек не сравнивал облака и, возможно, вообще не знал названия платформы. Платформу для развёртывания выбрал его любимый кодинговый агент:)

Это очередной разбор лекции из курса Stanford MS&E435, где мы начинали с карты экономики AI-суперцикла, а теперь дошли приложений и вопроса, а кто забирает ценность, когда софта становится больше. Guillermo Rauch, основатель и CEO Vercel, предлагает такой ответ: код дешевеет, но результат всё ещё нужно развернуть, запустить и обслуживать. Экономическая ставка Vercel — занять слой между намерением и работающим продуктом: дать агенту API для развёртывания, preview URL, изолированную среду, шлюз к моделям и долгоживущие процессы, а в перспективе — облако, которое само диагностирует эксплуатационные проблемы. Это одновременно содержательная лекция и аккуратно собранный питч от вендора.

Но интереснее то, что происходит до развертывания. По словам Rauch, агент приходит с уже сложившейся «картиной мира»: модели успели узнать Next.js, React и open-source инструменты Vercel из материалов в интернете. Такой агент не проводит нейтральный анализ. Я бы сформулировал экономическое следствие так: open source здесь становится дистрибуцией, а runtime — монетизацией.

В выступлении это подкрепляется цифрами из исследования Amplifying: Claude Code выбрал shadcn/ui в 64 из 71 ответов с извлечённым основным выбором (90,1%), а Vercel — во всех извлечённых deployment-ответах для Next.js и React SPA. Здесь важна сноска. Это 2 430 успешных ответов Claude Code с тремя моделями Claude на четырёх greenfield-репозиториях; Vercel получил 86 из 112 deployment picks в целом, то есть 76,8%. Это не доля рынка и не доказательство того, что выбранный продукт качественнее альтернатив.

Именно поэтому формула «агент выбрал» не равна формуле «рынок порешал». Выбор складывается из обучающих данных модели, системной инструкции, текущего стека, качества документации, видимости проекта в open source и того, может ли агент понять и применить компонент локально. В разборе Developer Experience для кодинговых агентов мы уже говорили про стандартный стек, CLI/API, быстрые тесты и понятные ошибки. Теперь видно экономическое продолжение: агентная эргономика становится не просто хорошим DevEx, а каналом продаж.

Есть и второй слой. Rauch считает, что интерфейс и локальный сценарий работы всё чаще будут генерироваться под задачу, а система учёта (system of record), данные, права доступа и API останутся. Я бы описал это как два периода полураспада софта: одноразовая оболочка и долговечное ядро. В самой лекции есть оговорка к тезису «software is basically free»: над сложным инфраструктурным кодом в Vercel, по словам Rauch, иногда собирают три агента и сильных инженеров, чтобы понять одну строку.

То есть дешевеет реализация, но не обязательно архитектура, проверка, безопасность и владение системой. В The New SDLC harness — это обвязка вокруг модели, делающая генерацию управляемой. Здесь появляется следующий экономический слой: агент и его harness становятся точкой выбора компонентов.

Для поставщика инструмента отсюда новый вопрос: сможет ли агент сам найти продукт, понять документацию, установить его, восстановиться после ошибки и объяснить свой выбор? Для покупателя — другой: почему агент принёс именно эту зависимость и какие варианты он даже не рассматривал? Раньше DevRel конкурировал за внимание разработчика. Теперь ему приходится бороться ещё и за место в картине мира модели — а этот gatekeeper часто вообще не виден пользователю.

#AI #Agents #PlatformEngineering #DevTools #Product #Economics
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Applications, Coding AI For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education This seminar covers applications, coding AI, and the future of software. Follow along with the schedule: https://mse435.stanford.edu/ Guest Speaker:…
  • 👍 5
  • ❤ 2
  • 🔥 1
Post #4911 2.78K
Книжный куб Только что рассказал про первые 90 дней CTO на мероприятии Стратоплана Вот слайд-дека - https://polomodov.tech/2026-09-03-first-90-days-cto/ Вот лонгрид - https://polomodov.tech/2026-07-31-first-90-days-cto/ Если мы набьем 50👌, то я сделаю режиссерскую версию…
AI4SDLC: Что бы я делал по-другому, если бы знал, что знаю сейчас (Рубрика #AI4SDLC)

Поучаствовал на Deep Tech Night Яндекса с двумя активностями
- Выступил с lighting talk "AI4SDLC: Что бы я делал по-другому, если бы знал, что знаю сейчас" - вот презентация
- Поучаствовал в дискуссии "Когда код стал дешёвым: где теперь ценность, ответственность и экспертиза?" - в рамках подготовки написал лонгрид свою позицию с отсылками на свои же публичные материалы

Lighting talk был на 15 минут, поэтому я рассказал презентацию очень кратко. По традиции, если есть желание послушать режиссерскую версию, то ставим 🔥 под постом и если мы наберем 100 реакций, то я устрою прямой эфир с режиссерской версией и ответами на вопросы.

P.S.
Пост про "Первые 90 дней CTO" набрал нужные количество 👌, поэтому на неделе я проведу прямой эфир с этим выступлением - https://t.me/book_cube/4919

#Agents #Books #AI #Engineering #Architecture #Management #Software
polomodov.tech AI4SDLC: Что бы я делал по-другому, если бы знал… — Deep Tech Night Что покупать, дорабатывать и делать своим в AI4SDLC — от сквозного стека до проверяемых эпизодов, стабильных префиксов и специализированных моделей
  • 🔥 117
  • ❤ 5
  • 👍 3
  • 🗿 1
Post #4909 2.74K
Сходил сегодня с женой и детьми утром в Бар Капибар, потом пообедал в детском ресторане Jooie и выдвинулся в сторону яндексовой конфы Deep Tech Night, где я сегодня расскажу lighting talk на тему ai4sdlc и пообщаюсь в дискуссии про AI Productivity. Очень плотный день в итоге выходит:)
  • 👍 22
  • 🔥 8
  • ❤ 5
  • 👎 3
Post #4908 2.73K
Microsoft: почему быстрый AI-код не ускорил команду (Рубрика #AI4SDLC)

К моим рассказам про spec-driven development и AI-DLC у AWS появилось хорошее продолжение. Microsoft Digital, внутренняя IT-организация компании, 3 сентября 2026 года поделилась опытом внедрения SDD. И начала с довольно неудобного признания.

Разработчики освоили AI-инструменты и стали работать быстрее. Но, по словам руководителя инициативы, на уровне команды прироста производительности не получили. Авторы связывают это с потерей исходного замысла при передаче работы между участниками процесса. Каждый ускорился на своём участке, а договориться, что именно строим, легче не стало.

Дальше ребята перестроили процесс вокруг живой спецификации. В ней фиксируют бизнес-цель, пользовательские сценарии, пограничные случаи и критерии приёмки. Спека хранится в репозитории и меняется вместе с продуктом. Ещё до неё команда согласует «конституцию»: архитектурные принципы, требования безопасности и ограничения.

С помощью GitHub Spec Kit проходят цепочку: постановка задачи → уточнение вопросов → технический план → задачи → проверка согласованности → реализация и тесты. Отдельно советуют делать небольшие, сфокусированные спеки: результат проще проверять и дорабатывать по частям.

Меняются и роли. PM отвечает за спецификацию на протяжении разработки, инженеры больше времени тратят на требования, планы и проверку сгенерированного результата. Знакомая тема: AI заставляет раньше делать ту работу, которую раньше можно было отложить до первого «мы вообще-то другое имели в виду».

Впрочем, здесь нет замеров до и после или контрольной группы. Это рассказ Microsoft Digital о своём опыте; доказательства, что SDD ускоряет любую команду, из него не получается.

И тут вернусь к разговору про AI-метрики: считать стоит весь путь от задачи до принятого результата, включая согласования, ревью и переделки. Иначе можно очень быстро писать код и по-прежнему долго выпускать нужные изменения.

#AI4SDLC #AI #Engineering #Management #DevTools
  • 👍 10
  • ❤ 7
  • 🔥 2
Post #4907 2.35K
Новый подкаст «Где профит от данных, Лебовски?» о данных и их ценности для бизнеса (Рубрика #Data)

Мы запускаем новый подкаст с таким составом авторов
- Андрей Цыбин - взгляд со стороны продуктовой аналитики и онлайн-экспериментов
- Николай Голов - взгляд со стороны дата-архитектуры и продуктовой разработки платформы данных
- Александр Поломодов - взгляд со стороны software архитектуры, AI4SDLC и инженерного лидерства

Первый выпуск будет ключевым и будет посвящен теме «Превращаем данные в деньги: что это значит и какие есть варианты».

Монетизация данных — это не только «продать массив». У компании есть как минимум три пути:
- продать или лицензировать данные;
- применить их внутри и улучшить решения;
- встроить данные в продукт, за результат которого платит клиент.

Разберём, где на самом деле возникает профит: в новой выручке, экономии, снижении ожидаемых потерь или более быстрых решениях. Поговорим о прямой продаже, внутренних data-платформах и продуктах, в которых клиент платит не за строки, а за результат.

И для каждого кейса зададим один неприятный, но полезный вопрос:
- Кто платит, за какое изменение и где это видно в P&L?
- Без культа дашбордов и аналитики ради аналитики.

🗓 Премьера в прямом эфире 7 сентября в 12:00 МСК.

#Data #Database #Analytics #Money #Metrics #Business
YouTube Превращаем данные в деньги: что это значит и какие есть варианты Запускаем новый подкаст «Где профит от данных, Лебовски?» о данных и их ценности для бизнеса. Авторский состав такой - Андрей Цыбин (https://smartdataconf.ru/archive/2024/persons/4e7d3c49c77144f69b3c5637d52252df/) - взгляд со стороны продуктовой аналитики…
  • ❤ 9
  • 🔥 4
  • 👎 1
  • 😁 1
Post #4906 2.3K
Stanford MS&E435: Yash Patil про внутреннее знание компании как learning loop (Рубрика #AI)

В обзоре Stanford MS&E435 я писал, что курс даёт хорошую карту экономики AI, но инженерам может не хватить глубины. На встрече с Yash Patil глубина как раз появляется: он не останавливается на «подключим модель к документам компании», а показывает, как внутреннее экспертное суждение превратить в eval, reward и post-training.

Патил — основатель и CEO Applied Compute. До своего стартапа он работал в OpenAI; по его рассказу, начал с post-training и evals, а затем перешёл к длинным агентным задачам. Технический опыт подтверждается не только его словами со сцены: OpenAI указывает Патила среди research contributors GPT-4.1 и Deep Research, а руководитель Deep Research Иса Фулфорд рассказывала, что раннюю работу над browsing-agent она начинала вместе с ним.

То есть механику обучения моделей он знает изнутри. Но перед нами не нейтральный академический обзор: Applied Compute продаёт компаниям ровно то, о чём говорит Патил, — post-training, специализированные модели и их дальнейшее улучшение. Я бы воспринимал его как сильного оператора со skin in the game, а не как отраслевого оракула.

💡 Главный тезис лекции: следующее узкое место — continual learning, способность системы учиться по редкой обратной связи из production. Код и математика первыми выиграли от reasoning-моделей не случайно. Там уже есть проверяемая награда: код можно скомпилировать и прогнать через тесты, ответ по математике — проверить. В большинстве корпоративных задач готового verifier нет. Более того, JP Morgan и Goldman Sachs могут считать хорошим результатом разные вещи.

Поэтому внутреннее преимущество компании не сводится к весам, документам или RAG. Патил отдельно подчёркивает, что model, harness и context работают вместе. Но накопительным активом становится контур:

реальные задачи и ошибки → экспертные исправления → eval и grader → reward → post-training → production feedback → следующая итерация

Патил удачно формулирует: eval определяет холм, на который затем карабкается RL. Если организация не умеет явно описать качество, выделить дорогие ошибки и согласовать спорные edge cases, модель будет оптимизировать удобный proxy. И может очень успешно забраться не на тот холм.

Практическое следствие мне нравится своей приземлённостью. Прежде чем решать, нужна ли компании собственная модель, стоит выбрать частую и экономически заметную задачу, собрать реальные сбои и решения экспертов, сделать held-out eval и проверить grader. После этого уже видно, хватает ли prompt + context + tools или выигрыш от post-training окупит отдельный model lifecycle.

В лекции есть два показательных кейса
1️⃣ В совместном материале Applied Compute и DoorDash заявлено примерно 30% относительного снижения доли низкокачественных меню после human validation и production A/B-теста; систему развернули на всём потоке меню в США.
2️⃣ По отчёту Cognition, специализированный SWE-Check сравнялся с Opus 4.6 на внутреннем in-distribution eval и работал примерно в десять раз быстрее. Но на полностью отложенном out-of-distribution наборе он всё ещё уступал
Это хорошие аргументы за специализацию узкой, частой и измеримой задачи, но не доказательство, что каждой компании срочно нужен собственный checkpoint модели.

Поэтому моя калибровка такая: Патилу я бы уверенно верил в вопросах evals, graders, reward design и post-training. Осторожнее — в прогнозах, что continual learning станет следующим главным фронтиром, а специализированные модели понадобятся почти всем. Самый устойчивый отрыв от конкурентов здесь, кажется, не конкретные веса: следующая frontier-модель может быстро их догнать. Защитный ров (moat) — это накопительный learning loop, который снова и снова превращает работу и ошибки компании в улучшение системы.

Если времени мало:
03:43–05:38 — опыт Патила
23:56–35:20 — evals и два прикладных кейса
35:51–40:05 — continual learning и production feedback

#AI #Agents #Evals #Engineering #Management #AI4SDLC
YouTube Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Enterprise Internal Knowledge For more information about Stanford’s graduate programs, visit: https://online.stanford.edu/graduate-education This seminar covers intelligence and unlocking enterprise internal knowledge. Follow along with the course schedule: https://mse435.stanford.edu/…
  • ❤ 5
  • 👍 5
  • 🔥 1
Post #4905 2.46K
И я тоже в числе счастливчиков, кто сможет поэкспериментировать сегодня ночью с Astra от OpenAI:)
  • 🔥 25
  • 👍 6
  • ❤ 5
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →