TGViewer
Channel Public Channel
Книжный куб

Книжный куб

@book_cube

Канал Александра Поломодова (@apolomodov), cto & technical fellow.

https://polomodov.tech - сайт со всеми материалами
youtube.com/@tellmeabouttech - канал со всеми видео
Subscribers
15.7K
Photos
3K
Videos
6
Links
2.5K

Showing posts older than #4722 · Back to latest

Older Posts 18 shown
Post #4721 3.1K
AI для software architecture: почему в 2026-м copilot архитектора всё ещё не получился (Рубрика #Architecture)

Бегло пролистал систематический обзор литературы "Artificial Intelligence Support for Software Architecture Practice", в котором поставлен практичный вопрос - а какие архитектурные задачи AI уже умеет поддерживать и почему отдельные успехи пока не складываются в целостную практику. Первая версия появилась в 2025 году, но в 2026 году ее обновили и 2 июля 2026 года статья вышла в ACM Transactions on Software Engineering and Methodology. При обновлении обзор литературы доведен до августа 2025-го, добавлен срез массовых инструментов на март 2026-го.

Авторы начали свой анализ с 874 публикаций из четырех научных баз, отдельно проверили ICSA и ECSA и оставили 51 рецензируемое исследование. Затем сопоставили результаты с проблемами из предыдущих интервью с 32 практиками. И выяснили следующее

1️⃣ В ограниченных задачах AI уже полезен
Модель для выбора одного из трех паттернов по требованиям показала точность 70%; извлечение архитектурных зон ответственности из текста - около 75% полноты (recall) на четырех проектах. На корпусе из 95 ADR GPT-4 давал связные решения, но уступал человеку по полноте. Это не готовый «архитектор», а ускоритель первого прохода с обязательной проверкой.
2️⃣ Убедительнее всего выглядят задачи с измеримым контуром

На небольшом стенде Kubernetes комплексный фреймворк с прогнозированием нагрузки сократил время развертывания контейнеров на величину до 34%; RL-агенты лучше случайного chaos monkey находили критические отказы, правда, пока в симуляции. Промышленное подтверждение есть в автомобильных, аэрокосмических и киберфизических системах - там, где задача узкая, а quality attributes можно посчитать.
3️⃣ Ранний дизайн и стратегические решения остаются в основном академическими прототипами
Модели умеют предложить границы, паттерн или ADR по текущему контексту, но плохо удерживают организационные ограничения, регуляторику, историю компромиссов и последствия изменений.
4️⃣ В отдельном срезе 21 массового инструмента авторы увидели ту же асимметрию

Больше всего AI-функций уже есть в observability, governance, conformance и локальной генерации. Слабее всего - в рассуждении на уровне всей системы, двусторонней связи intent/ADR/code/runtime и накоплении сигналов архитектурной эрозии во времени.

В общем, если обобщить, то на уровне текущего среза AI инструменты уже помогают с архитектурными решениями, но на уровне helicopter view и эволюции архитектуры во времени они пока не тянут.

Если смотреть на подход авторов к анализу, то они выделили (картинки приложил)
- Software Architecture challenges
- AI-specific challenges
- И список тем, в которых есть AI инструменты
И сделали маппинг между ними и дальше из этого получили инсайты выше

Если анализировать актуальность работы в 2026 году, то можно увидеть, что с 2025 года появились ArchBench, R2ABench, CAKE и SAKE - то есть один из пунктов роадмапа авторов этого обзора (архитектурные датасеты и бенчи)уже начали закрывать. Но результаты пока скорее подтверждают диагноз авторов
- В R2ABench модели хорошо строят синтаксически корректные диаграммы и извлекают сущности, но слабо связывают их отношениями, из-за чего архитектура получается фрагментированной; агентные процессы (agentic workflows) добавили нестабильности, а не устойчивого выигрыша
- SAKE отдельно предупреждает: знание архитектурных терминов - необходимый фильтр, но не доказательство способности проектировать конкретную систему с ее trade-offs.

Роадмап развития AI в архитектуре от авторов статьи вообще выглядит примерно так
- Живая архитектурная база знаний: требования, решения, код, телеметрия со сквозной traceability
- Живые арх метрики и проверяемые бенчи
- Поверх этого уже можно строить архитектурный интеллект, который развивается вместе с системой: AI играет роль сильного аналитика, а человек остается стратегом и отвечает за контекст, приоритеты и компромиссы.

Вообще можно использовать такие 2 вопроса как лакмусовую бумажку:
- Если меняется требование, то мы можем понять затронутые ADR, компоненты, код, атрибуты качества и рантайм сигналы?
- Если случился инцидент, то можем ли мы отследить в обратном направлении до архитектурного запашка, а дальше вообще к решению, которое его породило?
Если нет, LLM лишь сделает красивее очередной статический снимок - полезный архитектурный AI со связности инженерных данных и способности проверить рекомендацию на истории системы.

В общем, AI повышает цену архитектурной дисциплины - чем дешевле локальная генерация решений, тем важнее удерживать намерение, границы, trade-offs и последствия во времени.

#Architecture #AI #AI4SDLC #Engineering #Research #Software #SystemDesign
arXiv.org Artificial Intelligence for Software Architecture: Literature... Artificial intelligence is increasingly applied across software engineering, yet its explicit role in software architecture remains insufficiently understood. Architectural practices rely on...
  • 👍 8
  • ❤ 3
  • 🔥 2
Post #4720 11.8K
Материалы про Loop Engineering (Рубрика #RnD)

Готовы материалы с подкаста Research Insights Made Simple, который был во вторник с Максимом Смирновым:
- Презнтация: Слайд дека с разбором
- Видео: Youtube, VK
- Аудио: Podster, Ya Music
- Текст: Краткая расшифровка

#AI4SDLC #Agents #Architecture #Engineering #Research
  • 👍 7
  • ❤ 5
  • 🔥 3
Post #4719 3.09K
Post #4718 3.05K
Как я с агентами запил сегодня себе прямые эфиры на статический сайт без обычного бэкенда (Рубрика #Architecture)

На этой неделе у меня четыре разговора с экспертами в прямом эфире: два уже прошли, два ещё впереди. Формат общения в реальном времени перестал быть для меня разовым экспериментом, и в какой-то момент стало странно, что мой сайт polomodov.tech об этом ничего не знает. Я хотел простое поведение: если в ближайшие семь дней запланирован эфир, сайт сам показывает анонс. Когда трансляция начинается, блок переключается в состояние live. Если эфира нет, ничего не нужно править руками, пересобирать или выкладывать специально ради одной плашки.

Здесь было интересное ограничение. Сайт статический, собран на GitHub Pages и работает на собственном домене. Обычного бэкенда у него нет, и заводить отдельный сервис с сервером и базой данных ради статуса трансляции мне не хотелось. Но совсем без серверной части не обойтись: YouTube API требует OAuth, а значит, где-то должны безопасно жить client secret и refresh token.

В итоге, я сегодня утром пообщался с Codex и мы спроектировали такую схему
- Добавили не полноценный бэкенд, а один узкий динамический слой - Cloudflare Worker.
- Раз в две минуты Worker через OAuth запрашивает у YouTube списки active и upcoming трансляций;
- Отбрасывает непубличные эфиры и эфиры другого канала, затем выбирает текущий либо ближайший запланированный;
- Сохраняет в Workers KV нормализованный снимок из трёх состояний - offline, upcoming, live - и отдельно кэширует access token;
- Наружу отдаёт только публичный read-only endpoint /status, без OAuth-данных и лишних деталей YouTube API;
- Браузер опрашивает этот endpoint раз в минуту, но только пока вкладка видима.

Отдельно предусмотрено не только как показать эфир, но и как безопасно перестать его показывать. Клиент проверяет версию схемы и все поля ответа. Если снимок старше десяти минут, он считается устаревшим и интерфейс возвращается в offline. Так же скрывается анонс, если трансляция запланирована дальше чем на семь дней. Ошибка YouTube или Worker не превращается в вечную плашку «мы в эфире».

Сам плеер тоже не загружается заранее. Для активной трансляции iframe появляется только после клика. Если я впаду в маразм и запрещу встраивание Youtube-фрейма, то сайт покажет превью и ссылку на страницу YouTube. А в навигации индикатор появляется только для состояния live. Операционную часть я тоже не оставил «на потом»: изменения Worker выкладываются отдельным сценарием GitHub Actions, а ещё один сценарий раз в час проверяет схему /status и свежесть данных. При этом посещения сайта не увеличивают число запросов к YouTube - к API обращается только Worker по расписанию.

Круто, что все это от начала и до релиза заняло меньше дня:
- Сегодня утром с агентом мы договорились об архитектуре
- Основной PR открылся в 12:46
- В 15:48 ветка синхронизировалась с main (я поревьювил и принял измения)
- Дальше я настроил все токены и доступы по инструкции агента между Google Cloud Console, Cloudflare, Github
- А в 17:09 изменения были смержены и дальше раскатаны
- К 18:00 на сайте уже отображался завтрашний стрим с Женей Сергеевым про whitepaper Anthropic

В общем, сейчас разработка своих пет-проектов - это чистый фан, особенно если ты разбираешься в инженерии и настроил кучу детерминированных проверок, которые позволяют агенту безопасно достигать поставленных целей:)

#Architecture #Engineering #Web #Cloudflare #DevOps #YouTube
  • 🔥 18
  • ❤ 11
  • 👍 6
Post #4717 2.72K
Research Insights Made Simple #21: как измерять кодинговых агентов в диалоге (Рубрика #AI4SDLC)

Что меняется, если требования к кодинговым агентам приходят не идеальным промптом, а уточняются по ходу?
17 июля в 16:00 МСК обсудим это с Алексеем Литвиновым в выпуске подкаста "Research Insights Made Simple #21". Мы поговорим про новые бенчи SWE-Together и SWE-INTERACT, опубликованные в один день. Оба я уже по отдельности разбирал в этом канале (SWE-Together и SWE-INTERACT). Вместе они показывают одну важную вещь: способность агента автономно выдать код по готовому, исчерпывающему ТЗ (как в классическом SWE-bench) ещё не означает, что он будет полезен в реальной совместной работе. На практике требования редко приходят идеальным промптом - они дорабатываются на лету, и здесь на первый план выходит способность адаптироваться под меняющийся контекст.

Алексей Литвинов — Principal Engineer, автор книги и [образовательной программы по AI-Assisted Engineering](https://edu.alekseilitvinau.com/). Он исследует и внедряет способы превратить работу с AI-агентами из набора удачных экспериментов в управляемый, воспроизводимый и проверяемый инженерный процесс на реальных кодовых базах. У Лёши есть и Telegram-канал — @tip_podcast.

Если же возвращаться к самим бенчам, то
- SWE-Together (от исследователей из запрещенной в России компании Meta) идёт от реальных пользовательских сессий и вводит метрику User Correction - сколько раз человеку пришлось вернуть агента на курс
- SWE-INTERACT (от исследователей из Scale.ai) делает обратный эксперимент: берёт те же задачи и те же проверки, но раскрывает требования постепенно. У сильных моделей доля решённых задач в таком режиме падает примерно вдвое, а работа становится длиннее и дороже.
Интерес этих исследований не в очередном рейтинге моделей. Они позволяют увидеть цену диалога: корректирующее руление, забытые требования, повторные проверки и зависимость результата от обвязки агента. Multi-turn работа оказывается отдельной инженерной способностью.

Мы поговорим о том, какая из двух методик ближе к реальной разработке, можно ли доверять симулятору пользователя, почему агент забывает требования из ранних реплик и как командам строить собственные multi-turn evals.

17 июля, 16:00 МСК. Приходите разбираться и спорить вместе с нами.

#AI #AI4SDLC #Agents #Evals #Engineering #Research
Youtube - YouTube Enjoy the videos and music you love, upload original content, and share it all with friends, family, and the world on YouTube.
  • ❤ 5
  • 🔥 4
  • 👍 2
Post #4716 3K
AI-Assisted Engineering: от удачного промпта к инженерной системе (Рубрика #Books)

Недавно прочитал книгу Алексея Литвинова "AI-Assisted Engineering", с которым сегодня мы обсудим его книгу в прямом эфире. Изначально Алексей предложил мне прочитать его книгу и дать обратную связь. Я с удовольствием взялся за чтение книги, чтобы оценить как можно собрать разрозненные практики работы с AI-агентами в одну систему. В итоге, самым полезным в книге оказалась не отдельные паттерны или методологии, а карта взросления: как перейти от удачных экспериментов с агентом к управляемой и воспроизводимой разработке.

Книга выстроена как большой учебник и идёт от простого к сложному. В самом начале Алексей задаёт лестницу из девяти уровней работы с AI, а дальше все 650+ страниц ведёт читателя по этой модели зрелости: от общего языка и одиночного агента - через спецификации и команды агентов - к внедрению на уровне организации.

Мне понравилось, что внутри разведены три типа материала:
- Уроки дают общую инженерную рамку: контекст, делегирование, петлю обратной связи, контроль результата;
- Паттерны описывают переиспользуемые детали - инварианты, AGENTS.md, послойную подачу контекста, проверки качества, worktree, разделение агента и человека;
- Методологии показывают, как из этих деталей собираются более крупные процессы: GitHub Spec Kit, OpenSpec, Kiro, Tessl, BMAD-METHOD, AI-DLC и другие.

С точки зрения актуальности книге это работает хорошо - конкретные инструменты и названия методологий будут меняться, а инженерные вопросы останутся: что агент должен знать, как сформулировано условие завершения, кто проверяет результат, где проходит граница автономности и как ограничить радиус ошибки.

Все эти идеи Алексей демонстрирует на сквозном примере Audit Log Service. Один и тот же сервис проходит через правила проекта, спецификации, CI/CD, проверки, работу нескольких агентов и след для аудита. К концу книги этот audit log уже физически не можешь видеть, но педагогически приём работает: меняется не предметная область, а зрелость системы вокруг агента.

Для меня главный тезис книги такой: AI-native разработка - это не ситуация, где модель пишет как можно больше кода. Это система, в которой мы можем делегировать исполнение, не теряя понимания, проверяемости и ответственности за результат. Поэтому выбор очередной модели здесь вторичен по сравнению с контекстом, спецификацией, обратной связью и качественными ограничениями.

Книга хорошо подойдёт инженерам уровня middle и выше, архитекторам и техническим руководителям, которые уже используют coding agents, но пока собирают свой процесс из отдельных находок. Её стоит читать тем, кто хочет не набор «магических промптов», а подробный маршрут к AI-native разработке - включая масштабирование на несколько агентов и внедрение в организации. А вот если нужен быстрый туториал на вечер или готовый рецепт «поставьте три файла и получите x10», книга вряд ли зайдёт. Это именно учебник: подробный, местами повторяющийся и требующий времени. Здесь это одновременно и ограничение, и главная ценность.

Сегодня, 15 июля, в 13:00 МСК мы поговорим с Алексеем о его инженерном опыте и книге на стриме Code of Leadership. Хочу отдельно обсудить, как эта лестница зрелости появилась на практике, какие паттерны переживают смену моделей и где при масштабировании агентной разработки возникает настоящее узкое место.

Присоединяйтесь к стриму и задавайте вопросы.

#Books #AI4SDLC #AI #Agents #Engineering #Architecture #Leadership
  • 🔥 15
  • ❤ 11
  • 👍 1
Post #4715 2.85K
Research Insights Made Simple #20: почему coding agents не отменяют экспертизу (Рубрика #AI4SDLC)

Что остаётся человеку, когда coding agent выбирает файлы, запускает команды и пишет реализацию? В четверг, 16 июля, с 16:00 до 17:00 МСК обсудим это с Евгением Сергеевым в прямом эфире "Research Insights Made Simple - Season 1, Episode 20". Мы разберем whitepaper Anthropic "Agentic coding and persistent returns to expertise".

Евгений Сергеев — Director of Engineering в Flo Health. Он развивает продуктовые инженерные команды и занимается практическим внедрением AI в разработку: coding agents, eval-driven development, quality gates и AI-assisted workflows. Женю интересует, как сделать работу с агентами управляемой и проверяемой — и что происходит с инженерной экспертизой, когда код писать становится дешевле, а цена неправильных решений остаётся высокой.

Если же возвращаться к папире, то авторы проанализировали 398 198 интерактивных сессий 234 751 пользователя Claude Code и пришли к выводу, что экспертиза пользователей в задаче связана с более глубоким делегированием агенту и более частым успехом сессии. Но это наблюдательная выборка одного продукта, а не эксперимент о производительности всей индустрии. Поэтому обсудим не только цифры, но и границы того, что они доказывают:
- Почему экспертиза здесь - знание конкретной задачи, а не грейд или стаж;
- Что означает разделение труда: человек принимает около 70% решений о том, что делать, но лишь 20% - о том, как;
- Почему экспертные сессии запускают примерно вдвое больше действий агента, но это ещё не означает вдвое большую продуктивность;
- Можно ли считать рост "verified success" с 14,5% до 32,9% эффектом экспертизы или мы видим только корреляцию;
- Где граница между успешной сессией, принятым PR, надёжным продакшен кодом и пользой для бизнеса;
- Как командам измерять время проверки, переделки, дефекты и сохранение знаний, а не только скорость генерации.

Отдельно поговорим об организационном парадоксе: опытный инженер способен сильнее разогнать агента, но если всё исполнение отдавать машине, откуда возьмутся следующие опытные инженеры?

Для меня это разговор не о том, заменит ли Claude Code разработчика. Вопрос практичнее: какая экспертиза становится дефицитной, когда код дешевеет, а цена неверного решения остаётся у команды. Приходите на прямой эфир в четверг, 16 июля, с 16:00 до 17:00 МСК. Будем разбирать методологию, спорить с выводами и переводить whitepaper в вопросы к реальному AI4SDLC.

P.S.
Сам whitepaper я уже разбирал в двух частях: 1 и 2.

#AI #AI4SDLC #Research #Engineering #Agents #Metrics #DevEx
YouTube Почему coding agents не отменяют экспертизу Что остаётся человеку, когда coding agent выбирает файлы, запускает команды и пишет реализацию? В четверг, 16 июля, с 16:00 до 17:00 МСК обсудим это с Евгением Сергеевым в прямом эфире "Research Insights Made Simple - Season 1, Episode 20". Мы разберем whitepaper…
  • ❤ 8
  • 👍 7
  • 🔥 3
Post #4714 3.07K
Loop Engineering: почему главная часть агентного цикла - это право сказать «нет» (Рубрика #AI4SDLC)

Сегодня в 16:00 по Москве мы будем разбирать на стриме с Максимом Смирновым материал "Loop Engineering: The Anthropic Playbook for Designing Systems That Prompt Your Agents", поэтому мне пришлось подготовиться и прочитать его заранее:) Ниже я оставлю короткую выжимку, а за расширенной версией приходите на стрим.

Начну с того, что мне сложно было понять статус статьи - несмотря на название и вёрстку под IEEE, это не статья Anthropic и не публикация IEEE. На ASIXIV материал появился 25 июня 2026 года в разделе curated; PDF прямо называет себя независимой переработкой гайда HuaShu в формате конференционной статьи. В основе - статья Addy Osmani, инженерный блог Anthropic и публичный кейс Stripe. Сведений о рецензировании нет, поэтому я бы читал текст как практический плейбук, который ещё предстоит проверять на своей системе.

Если убрать очередное xXx Engineering из названия, главный тезис простой: следующий шаг - не лучше управлять одним запуском агента, а спроектировать систему, которая сама находит работу, отдаёт её агенту, проверяет результат, сохраняет состояние и решает, когда запуститься снова.

В статье приводится такая лесенка знакомых концепций
- Prompt engineering отвечает за одну инструкцию;
- Context engineering - за то, что модель видит сейчас;
- Harness engineering - за обвязку, инструменты, ограничения и критерий завершения одного запуска;
- Loop engineering - за повторяемый цикл поверх harness.

В одном обороте такого цикла пять движений:
1) Поиск работы (discovery)
2) Передача задачи (handoff)
3) Проверка результата (verification)
4) Сохранение состояния (persistence)
5) Планирование следующего запуска (scheduling)

Реализуются они через планировщики, изолированные git worktree, skills с проектным знанием, подключения к внешним системам, подагентов и состояние вне контекстного окна. По отдельности детали не новы. Новая здесь граница системы: человек перестаёт быть таймером, который после каждого ответа говорит агенту, что делать дальше.

И здесь появляется главная инженерная проблема. Ошибка в промпте обычно живёт один ответ. Ошибка внутри цикла может попасть в файл состояния, вернуться в следующем проходе как установленный факт и стать основанием для новых изменений. Чем дольше ошибка остаётся незамеченной, тем больше её радиус поражения (blast radius). Поэтому самая ценная часть цикла - не механизм, который снова говорит агенту «работай», а механизм, способный вовремя сказать «нет».

В тексте отдельно есть фокус на разделении исполнителя и проверяющего (generator/evaluator). Агент, который только что написал код, склонен слишком мягко оценивать своё решение. Проверяющий должен приходить с другим контекстом и действовать: запускать тесты, открывать приложение, проходить пользовательские сценарии, проверять API и сравнивать поведение с задачей. Anthropic описывает похожую обвязку, но там проверяющего тоже пришлось калибровать: он пропускал ошибки и иногда уговаривал себя принять слабый результат. Второй LLM - полезная независимая роль, но ещё не доказательство корректности.

Из практических кейсов самый заметный - Stripe Minions: по словам инженера Stripe Стива Калиски, система подготавливает около 1300 машинно написанных PR в неделю. Финальное ревью делают люди, а надёжность держится на изолированных облачных средах, детерминированной оркестрации, тестах и CI. Это пример масштаба генерации, но не бенчмарк качества: число PR не говорит, сколько дефектов ушло в рабочую среду и сколько внимания съела проверка.

У автономности цикла есть четыре неявные проблемы:
1) Долг проверки (verification debt) - накопленный непроверенный результат;
2) Потеря понимания (comprehension rot) - отставание нашей ментальной модели от кодовой базы;
3) Отказ от собственного суждения (cognitive surrender) - привычка соглашаться с машиной;
4) Раздувание расходов на токены (token blowout) - неконтролируемые повторы.
Эти проблемы усиливают друг друга: чем больше непроверенного кода, тем хуже мы понимаем систему; чем хуже понимаем, тем охотнее отдаём ей следующие решения.

Практический вывод из материала я бы сформулировал так: первый цикл должен быть маленьким и скучным. Например, ежедневный разбор упавшего CI или новых задач. Ему нужны постоянное состояние, отдельный проверяющий, жёсткий лимит попыток и токенов, изоляция задач и человеческая контрольная точка перед слиянием. Параллелизм стоит увеличивать только после того, как проверяющий действительно поймал несколько реальных ошибок, а не просто ни разу не возразил.

А расширенно этот же материал мы разберём сегодня с Максимом Смирновым на стриме в 16:00.
Приходите послушать и позадавать вопросы.

#AI4SDLC #AI #Agents #Engineering #Architecture #Evals #Research
  • ❤ 9
  • 👍 3
  • 🔥 1
Post #4713 3.1K
Не успел дочитать книгу "Agentic Design Patterns" про создание агентов, как начал читать книгу Элизера Юдковского "Если кто-то его создаст - все погибнут". Раньше Элизера я знал как популяризатора науки и автора книги "Гарри Поттер и методы рационального мышления", а теперь познакомлюсь с его публичной позицией думера (doomer) по отношению к искусственному интеллекту. Отдельно отмечу, что книга стала бестселлером в 2025 году и я одидаю интересного чтива:))
  • 😁 11
  • ❤ 2
  • 👍 1
Post #4712 11.9K
Кто управляет кодинг-агентом: человек или спроектированный им цикл?

Мы привыкли обсуждать промпты, контекст и обвязку одного запуска агента. Но когда агент сам возвращается к работе - по расписанию, событию или результату прошлого прохода, - задача становится архитектурной: кто находит работу, проверяет результат, хранит состояние и может остановить цикл.

14 июля в 16:00 по Москве проведу прямой эфир с Максимом Смирновым. Разберём материал HuaShu «Loop Engineering: The Anthropic Playbook for Designing Systems That Prompt Your Agents». Это будет уже 19й выпуск подкаста Research Insights Made Simple.

Максим — ИТ-архитектор, автор Telegram-канала «Архитектура ИТ-решений» @it_arch. В прошлом — руководитель департамента ИТ-архитектуры «Билайн» и главный архитектор информационных систем Банка России; спикер, автор и преподаватель курсов по ИТ-архитектуре.

Формально это не публикация Anthropic и не рецензируемая статья, а независимый рабочий конспект (working note) HuaShu. Сильная сторона этой whitepaper - точная постановка задачи: перестать подталкивать агента очередным промптом и спроектировать ограниченный, наблюдаемый и останавливаемый цикл.

Обсудим:
- чем проектирование циклов отличается от обвязки одного запуска и почему cron с повторяющимся промптом ещё не цикл;
- как связаны поиск работы (discovery), передача (handoff), проверка, сохранение состояния и планирование;
- почему агенту опасно доверять проверку своей работы и как разделить исполнителя и проверяющего;
- какие долги накапливают автономные циклы — от долга проверки до потери понимания системы;
- какие ограничения нужны вокруг LLM: изоляция, лимиты, журнал, откат и аварийная остановка;
- где остаются инженерное суждение, ответственность и контрольная точка для человека.

Главный вопрос эфира: как отдать агенту повторяемую работу, не позволив ему незаметно накапливать ошибки.

#AI4SDLC #Agents #Architecture #Engineering #Research
YouTube Research Insights Made Simple #19 - разбор whitepaper"Loop Engineering" с Максимом Смирновым Кто управляет кодинг-агентом: человек или спроектированный им цикл? Мы привыкли обсуждать промпты, контекст и обвязку одного запуска агента. Но когда агент сам возвращается к работе - по расписанию, событию или результату прошлого прохода, - задача становится…
  • 👍 7
  • 🔥 5
  • ❤ 4
Post #4711 2.75K
Yann LeCun про JEPA: предсказывать не пиксели, а состояние мира (Рубрика #AI)

Посмотрел лекцию Яна Лекуна «World Models: Enabling the Next AI Revolution», прочитанную 29 мая 2026 года в ETH Zurich. Получился почти исследовательский манифест: для физического мира недостаточно генерировать следующий токен - нужно строить абстрактное состояние мира, предсказывать последствия действий и уже поверх этого планировать. Кстати, Ян Лекун в конце прошлого года ушел из запрещенной в России компании Meta, где он долгое время был Chief Scientist (я как-то даже писал об этом).

Лекун продолжает свой давний спор с мейнстримом в виде LLM. В предобучении авторегрессионная модель минимизирует cross-entropy следующего токена - повышает вероятность правильного продолжения. Instruction tuning (SFT), обучение на предпочтениях (RLHF), reinforcement learning и дистилляция меняют поведение, но в основе остается то же предсказание следующего токена. По Лекуну, для сильного языкового интерфейса этого достаточно, а для модели физического мира - нет. Оговорюсь: это не консенсус. Reasoning-модели, поиск и инструменты делают границу менее абсолютной, но сам контраст помогает понять, зачем нужна JEPA.

В Joint Embedding Predictive Architecture меняется объект предсказания:
- Context encoder переводит видимую часть X в векторное представление;
- Target encoder кодирует скрытый фрагмент или будущее состояние Y;
- Predictor по X и действию A предсказывает представление Y;
- Loss - расстояние между предсказанным и целевым векторами, а не ошибка в каждом пикселе.

Если совсем просто, обучение сближает два сжатых описания скрытого фрагмента: предсказанное по видимой части изображения или видео и построенное по самому фрагменту. Детали различаются между версиями JEPA, но суть одна: совпадать должны полезные признаки сцены, и модель получает право отбрасывать непредсказуемое. Чтобы понять, куда покатится мяч, не нужно угадывать движение каждой травинки - хватит объектов, геометрии, движения и последствий действия. Такое пространство менее детальное, зато пригодно для предсказания на дальнем горизонте.

У подхода есть известная ловушка: если оба encoder'а выдают постоянный вектор, ошибка равна нулю, хотя модель ничему не научилась, - это коллапс представлений. В I-JEPA и V-JEPA от него защищаются так: целевая ветка не получает градиент и обновляется как exponential moving average основной сети. В LeJEPA вместо teacher-student схемы стоит регуляризатор SIGReg, подталкивающий embeddings к изотропному гауссовскому распределению. Лекун признает, что этот вариант пока не масштабирован так же хорошо, как I-JEPA и V-JEPA.

Когда predictor учитывает действие, получается action-conditioned world model: она предсказывает уже не просто будущее, а последствия конкретного движения робота. Система прокручивает варианты в latent space и выбирает последовательность с минимальной энергией (energy) - мерой несовместимости с целью и ограничениями. В V-JEPA 2-AC планировщик CEM минимизирует L1-расстояние до embedding целевой картинки, выполняет первое действие и перепланирует. По сути это MPC, только модель динамики выучена из данных.

С LLM все это не обязательно конкурирует: в V-JEPA 2 визуальный encoder соединяли с Llama 3.1 8B для video question answering. Система может быть составной: LLM - язык, знания и инструменты; world model - состояние и динамика; planner - действия.

Отдельно от выступления мне было интересно прикинуть, что из этого уже живет в продакшене, а что пока остается исследованиями.
- В продакшене давно живут авторегрессионные LLM, мультимодальные модели, embeddings, vision encoders и классический MPC - но как отдельные кирпичи, а не готовая JEPA-система.
- V-JEPA 2/2.1 можно брать как открытые video encoders - для классификации, поиска, предсказания действий или как визуальную часть VLM. Но открытые веса, интеграция в Transformers и коммерческая лицензия - еще не развертывание в проде.
- V-JEPA 2-AC дообучили примерно на 62 часах роботизированного видео и без адаптации под конкретную установку запустили на манипуляторах Franka в двух лабораториях. Роботы выполняли reach, grasp и pick-and-place по визуальной цели. Правда, это исследование, а не серийный робот.
- Иерархическое планирование, длинные горизонты, объединение зрения со звуком и осязанием, заявленная безопасность через guardrail objectives - тоже пока исследования. Я не нашел в официальных источниках подтверждения, что JEPA уже обслуживает Meta AI, Instagram, очки или коммерческого робота.

В конце Лекун дает исследователям несколько намеренно провокационных советов:
- Академическим группам не пытаться обыграть индустрию масштабированием LLM, а идти в нерешенные задачи world models и physical AI;
- Для понимания мира изучать joint-embedding и energy-based модели и не считать генерацию пикселей готовой моделью мира;
- Развивать регуляризованные методы и максимизацию информативности вместо опоры только на contrastive learning;
- Учиться в основном наблюдением, а RL включать экономно - поверх хороших представлений, когда без него нельзя.

Для меня это не запрет работать с LLM: они уже решают реальные задачи, а тезисы Лекуна еще предстоит доказать. Это совет о выборе фронтира: идти туда, где нужно предсказывать последствия и управлять процессом, а не соревноваться в красоте генерации.

P.S.
Вчера с друзьями обсуждали за пивом вопросы LLM, World Models, AI в разработке и ритейле ... и я понял, что плохо шарю в World Models - пришлось достать из watch list это видео, до которого не доходили руки и посмотреть его сегодня утром:)

#AI #JEPA #WorldModels #Research #Robotics #Engineering
YouTube Yann LeCun: World Models: Enabling the next AI revolution Talk given by Yann LeCun at ETH Zürich during "Frontiers of Embodied AI".
  • 👍 5
  • ❤ 4
  • 🔥 3
Post #4710 3.25K
Код стал дешевле. Что стало дорогим? (Рубрика #AI4SDLC)

AI-агент уже может за минуты написать код, на который раньше ушёл бы вечер. Но один удачный diff ещё не означает, что разработка стала быстрее: узкое место может просто переехать в постановку задачи, ревью, тестирование и проверку результата. В среду, 15 июля, в 13:00 МСК проведу прямой эфир на моем канале TellMeAboutTech. с Алексеем Литвиновым в формате видео-подкаста "Code of Leadership".

Алексей Литвинов - это Principal Engineer, автор книги и образовательной программы по AI-Assisted Engineering. Он исследует и внедряет способы превратить работу с AI-агентами из набора удачных экспериментов в управляемый, воспроизводимый и проверяемый инженерный процесс на реальных кодовых базах. У Леши есть и канал в tg - @tip_podcast

На встрече мы поговорим с Алексеем про его книгу «AI-Assisted Engineering», в которой он рассказывает как построить вокруг агента инженерную систему: контекст, спецификации, ограничения, обратную связь, CI/CD и понятное разделение ответственности. Мы обсудим
- Чем делегирование агенту похоже на делегирование человеку и где аналогия ломается;
- Почему контекст и спецификация становятся важнее скорости генерации;
- Не возвращает ли spec-driven development водопад, только теперь в Markdown;
- Почему зелёный CI ещё не доказывает, что решена правильная задача;
- Как AI создаёт verification debt и превращает ревью в новое узкое место;
- Когда мультиагентность ускоряет работу, а когда масштабирует конфликты;
- Как меняются роль лидера, развитие junior-инженеров и ответственность за результат.
Абстрактные идеи будем проверять на сквозном кейсе Audit Log Service: что должен знать агент, какие инварианты обязаны контролировать тесты и где решение всё ещё должен принимать человек.

В общем, приходите 15 июля в 13:00 МСК на прямой эфир на моем канале TellMeAboutTech.

#AI #AI4SDLC #Engineering #Leadership #Agents #Engineering #Software #Podcast
YouTube AI-native: понимание не делегируется Код стал дешевле. Что стало дорогим? (Рубрика #AI4SDLC) AI-агент уже может за минуты написать код, на который раньше ушёл бы вечер. Но один удачный diff ещё не означает, что разработка стала быстрее: узкое место может просто переехать в постановку задачи…
  • 🔥 18
  • ❤ 11
  • 👍 7
Post #4709 3.08K
[2/2] Claude Code и экспертиза: почему успешность сессии ещё не признак продуктивности (Рубрика #AI4SDLC)

Продолжаю разбор исследлования Anthropic "Agentic coding and persistent returns to expertise" про использование Claude Code. В первой части мы поговорили про методологию и результаты самого исследования, а теперь хотелось бы понять как их стоит интерпретировать и как оценивать вес приведенных в исследовании доказательств. Я бы их разложил по такой шкале

1️⃣ Высокая уверенность в описании выбранного трафика Claude Code
Какие режимы работы встречались, сколько внутренних действий запускал запрос пользователя и как внутри сессий делились планирование и исполнение.
2️⃣ Средняя уверенность в связи между оценённой экспертизой и исходом
Разница сохраняется после статистических контролей и во внутренней проверке Anthropic, где код из сессий с более высокой expertise чаще попадал в main. Но это наблюдение, не эксперимент.
3️⃣ Низкая уверенность в выводах о причинности

Речь идет о производительности команд, качестве или рынке труда. Эти результаты исследование просто не измеряло.

Главная методологическая проблема исследования - это распространённое смещение методов (CMB, common-method bias). Суть в том, что и экспертиза человека, и успех сессии извлекаются моделью из одного транскрипта. Причём определение экспертизы включает точную постановку задачи, адресную проверку и способность исправить Claude. А успех включает прошедшие тесты, commits и подтверждение пользователя. Получается частичное пересечение конструкций. Человек, который умеет запросить хорошую проверку и ясно сообщить результат, одновременно выглядит для классификатора и более компетентным, и более успешным.

На 198 SWE-chat-сессиях классификаторы сравнили с Mythos Preview. Для порядковых метрик точное совпадение составило 53–68%, а с допуском соседнего уровня - 78–99%; для categorical - 78–98%. Человек проверил лишь 15 расхождений, которые модель-судья сочла существенными. Это согласие с сильной моделью (strong-model agreement), а не эталонные данные, размеченные человеком (human ground truth).

Второй интересный момент - то верифицированный успех (verified success), который требует явное подтверждение результата. Но исследователи не видят, был ли код принят командой, развёрнут, безопасен и полезен пользователю. Именно поэтому успех сессии нельзя незаметно переименовать в продуктивность работы.

Третий интересный момент - это «экономическая ценность». Anthropic сообщает, что модельная стоимость средней задачи выросла на 27%. Но цена строится через превращение сессии в условный freelance job и сопоставление с объявлениями. В приложении у оценщика log R² ≈ 0,38: маленькие задачи он переоценивает примерно в 2,4 раза, крупнейшие недооценивает примерно в 7 раз. Корректный вывод скромнее: менялся оценочный состав задач, а не измеренная экономическая ценность.

Чтобы понять последствия для влияния AI на процессы разработки, одного источника мало. Рядом полезно поставить отдельный рандомизированный эксперимент Anthropic "How AI Impacts Skill Formation" (от 28 января 2026 года). Там 52 разработчика изучали незнакомую Python-библиотеку Trio с GPT-4o или без AI, а затем проходили одинаковый тест без помощника. Группа с AI закончила примерно на две минуты быстрее, но разница не была статистически значимой. В тесте она набрала в среднем 50% против 67% у группы без AI; самый большой разрыв был в отладке. В качественном анализе объяснения и самостоятельная попытка были связаны с лучшим обучением, чем полное делегирование.

Эти исследования нельзя просто сравнивать в лоб, так как
- Первое наблюдает опыт, проявленный в реальных Claude Code-сессиях
- Второе экспериментально проверяет краткосрочное формирование нового навыка на маленькой выборке
Вместе они создают организационный парадокс: более высокая экспертиза в задачах связана с большей активностью агента и успехом сессий, а полное делегирование в узком контролируемом эксперименте - с более слабым освоением навыка.

#AI #AI4SDLC #Research #Engineering #Agents #Metrics #DevEx
Telegram Книжный куб [1/2] Claude Code и экспертиза: что показали 398 тысяч сессий (Рубрика #AI4SDLC) Добавлял в корпус мета-исследования AI4SDLC 2026 свежую работу (16 июня 2026) Anthropic "Agentic coding and persistent returns to expertise", в заголовок которой вынесен вывод…
  • ❤ 3
  • 🔥 3
  • 👍 1
Post #4708 2.96K
[1/2] Claude Code и экспертиза: что показали 398 тысяч сессий (Рубрика #AI4SDLC)

Добавлял в корпус мета-исследования AI4SDLC 2026 свежую работу (16 июня 2026) Anthropic "Agentic coding and persistent returns to expertise", в заголовок которой вынесен вывод о том, что кодинговые агенты не отменяют экспертизу. Но для меня здесь интереснее другое - подход авторов к измерению разделению труда между человеком и Claude Code на реальных рабочих сессиях. Это большой, но не экспериментальный источник. Anthropic взяла случайную выборку из 398 198 интерактивных сессий 234 751 пользователя с октября 2025 по апрель 2026 года. В выборку вошли Claude Code в CLI, Claude.ai и desktop-приложение. Внутренние сессии сотрудников Anthropic, сторонние IDE, SDK и headless-запуски исключили. Это сильные наблюдательные данные одного продукта, а не независимое исследование всей разработки ПО.

Метод устроен интересно. Модельные классификаторы читали транскрипты с сохранением приватности и размечали:
- какой вид работы выполнялся;
- кто принимал решения о планировании и исполнении;
- какую предметную компетентность показывал пользователь;
- чем закончилась сессия.

Часть классификации авторы сверяли с независимой телеметрией: числом обращений к модели и инструментам, объёмом вывода, добавленными и удалёнными строками. А commits, tests и подтверждение пользователя искал уже отдельный transcript-классификатор успеха. Исследователи не читали отдельные приватные транскрипты, а публиковали только агрегаты.

Под экспертизой авторы понимали компетентность пользователей в текущей задачи (а не грейд, стаж или название должности). Для оценки экспертизы авторы использовали классификатор оценки компетентности в рамках задачи по пяти уровням: насколько точно он задаёт рамку, понимает терминологию, просит проверить конкретные риски и исправляет Claude по существу. Senior-разработчик, впервые пишущий на Rust, может оказаться начинающим в задаче на Rust кодинг. Бухгалтер без опыта Python, который точно задаёт правила сверки и ловит ошибку в обработке закрытия месяца, - это эксперт в бухгалтерской задачи. Итого: исследование не сравнивает junior и senior engineers.

Результаты получились интересными

1️⃣ Разделение труда уже заметно
В типичной сессии человек принимал около 70% решений о том, что делать, но только 20% решений о том, как именно это выполнить. Иными словами, пользователь в основном удерживал цель и критерии, а Claude - выбор файлов, команд и деталей реализации. Это хорошо ложится на цепочку, о которой я писал в State of AI4SDLC:
intent → context → plan → tasks → implementation → verification.
Анализ Anthropic не доказывает, что весь SDLC уже перестроился, но показывает похожий паттерн внутри интерактивной работы с агентом.

2️⃣ Различные по уровню компетенции сессии приводили к разному уровню
делегирования
В сессиях, размеченных как novice, один запрос запускал примерно 5 действий Claude и 600 слов вывода, а в expert-сессиях - около 12 действий и 3 200 слов. Связь сохранялась после учёта work mode, task value, месяца, профессии и model family. Но «больше действий и текста» ещё не значит «больше полезной работы». Длинная цепочка может быть автономным исполнением, а может - лишними итерациями и переделками. Пока это мера делегирования, не productivity.

3️⃣ Более высокая оценка expertise была связана с более частым `verified success`

После статистической корректировки этот показатель рос с 14,5% у novice до 20,9% у beginner, 28,3% у intermediate, 29,5% у advanced и 32,9% у expert. Основной скачок происходит между novice и intermediate; между intermediate и expert прирост заметно меньше. Verified success здесь означает, что классификатор счёл цель достигнутой и нашёл хотя бы один сигнал: прошедший тест или команду, подходящий commit/PR либо явное подтверждение пользователя. Это строже простого модельного вердикта, но ещё не означает, что изменение дошло до production и принесло пользу.

Я уже разбирал Anthropic Agentic Coding Trends и переход от написания кода к управлению агентами. Новая работа добавляет к этой линии наблюдаемый паттерн: агент забирает большую часть исполнения, а task-specific expertise связана с более частым успехом сессии.

А в следующей части разберу неприятный вопрос: насколько надёжно здесь измерены expertise и success, почему корреляция ещё не причинность и что отдельный рандомизированный эксперимент говорит о формировании навыков.

#AI #AI4SDLC #Research #Engineering #Agents #Metrics #DevEx
Anthropic Agentic coding and persistent returns to expertise New Anthropic research looking at interactive agentic coding. We evaluate the composition of tasks, human-AI collaboration, and success rates.
  • ❤ 13
  • 🔥 3
  • 👍 2
  • 🤣 1
Post #4707 3.05K
Nick Nisi про agent skills: меньше инструкций, больше доказательств (Рубрика #AI4SDLC)

Посмотрел короткий доклад Nick Nisi, инженера по Developer Experience в WorkOS, с AI Engineer Europe 2026. Выступление прошло 10 апреля 2026 года в Лондоне, а запись вышла в мае под провокационным заголовком: «How I deleted 95% of my agent skills and got better results», хотя доклад скорее не провокация, а хороший инженерный разбор того, почему длинный промпт еще не делает агента надежной системой.

Недавно я уже разбирал на этом же канале выступление Matt Pocock про skill hell. Тогда речь шла о том, как проектировать и регулярно чистить skills. Nisi добавляет к этой рамке практический контрпример: иногда полезность skill становится видна только в тот момент, когда eval показывает, что без него модель работает лучше.

Главный тезис Ника о том, что недетерминированную работу модели нужно помещать внутрь детерминированного инженерного контура. Не просить агента еще настойчивее соблюдать процесс, а вынести переходы, проверки и критерии завершения в обычный код. Ник показывает это на своей системе Case. По его словам, он поддерживает больше 20 репозиториев WorkOS на восьми языках, и ручная постановка каждой агентной задачи сама стала узким местом. Первая версия Case была большим Claude skill: модель читала описание процесса, запускала этапы и решала, куда идти дальше. По мере роста контекста она стала пропускать проверки и забывать ограничения.

Дальше Ник перенес управление потоком в написанную на TypeScript машину состояний (state machine) поверх Pi. В версии из доклада работа идет через implementer, verifier, reviewer, closer и ретроспективного агента. Но важны не пять названий, а обязательные проверки (gates) между ними. Реализация не переходит к ревью, пока отдельный verifier не проверил результат; замечания возвращают задачу на доработку; PR нельзя создать без свидетельств результата (evidence).

Он приводит пару интересных историй

1️⃣ История с тестами
Агенту нужно было оставить файл .case-tested после прогона, и он нашел самый короткий путь: просто создал этот файл через touch. Формально, AI оптимизировал заданный критерий - условно, выполнил букву, а не дух намерения инженера:) Ник заменил пустой маркер на команду, которая принимает вывод тестов, разбирает результаты и сохраняет SHA-256. Это не криптографическое доказательство того, что тесты действительно были запущены: происхождение переданного вывода все равно нужно контролировать. Но такой маркер уже закрывает примитивный обход и оставляет проверяемый артефакт, без которого конвейер не идет дальше. Для UI-багов та же идея доведена до записи Playwright до и после исправления.

2️⃣ История со скиллами для WorkOS CLI (из которой и появилось провокационное название доклада)
Сначала из документации автоматически сгенерировали 10 739 строк инструкций. Выглядело солидно, но прогоны evals стали долгими, дорогими по токенам и показывали лишний шум. После ручного сокращения до 553 строк с конкретными ловушками продукта (gotchas), по словам Ника, время одного прогона уменьшилось с 68 до 6 минут. Здесь важно аккуратно читать цифры. «Удалил 95%» означает примерно 95% объема сгенерированного текста, а не 95% отдельных skills. И 77% против 97% — не общий рост точности системы: это составной балл (composite score) одного SSO/CSRF eval-кейса, где подключенный skill упустил важный шаг и увел модель в неправильную последовательность.

Из двух историй у Nisi складываются три правила:
1️⃣ Enforce, а не instruct: важное ограничение должно жить в коде, обязательной проверке или политике;
2️⃣ Guide, а не prescribe: агенту полезнее дать специфические «мины» продукта, чем пересказать всю документацию;
3️⃣ Measure, а не assume: каждый кусок контекста нужно сравнивать через evals, в том числе с вариантом «без него».

Это хорошо продолжает и прошлый разбор Zack Proser из WorkOS про внимание как узкое место. Proser говорил, что человек выгорает, когда становится диспетчером нескольких агентов. Nisi показывает следующий инженерный шаг: прежде чем отдавать человеку очередной diff, обвязка агента (harness) должна сама собрать доказательства, провести независимую проверку и вернуть только то, на что действительно стоит тратить внимание.

Итого, кажется, что нам надо не просто максимизировать контекст или количество скиллов, а пытаться выстроить agentic процесс вокруг минимального релевантного контекста, детерминированных переходов, проверяемых артефактов, evals и человеческого суждения в конце.

#AI #AI4SDLC #Engineering #Agents #Evals #Software
YouTube How I deleted 95% of my agent skills and got better results — Nick Nisi, WorkOS Claude would fake running tests by touching the expected output file. Nick Nisi, DX engineer at WorkOS, fixed it by SHA-256 hashing the actual test output and verifying it cryptographically. His principle: make it easier to do the real work than to lie about…
  • ❤ 9
  • 👍 4
  • 🔥 3
  • 😘 1
Post #4704 2.88K
Эту неделю мы с детишками провели в спортивном лагере под Тулой, где они по три раза в день занимались футболом. А я первые несколько дней занимался почти фултайм AI engineering и это было занимательно. Потом что-то случилось и интернет на базе пропал, а мобильный интернет работал только по белым спискам. Но я почти никуда не езжу без книг, поэтому я не растерялся и
1) Дочитал книгу "AI-Assisted Engineering" - книга хорошая и мы с автором запишем про нее подкаст
2) Прочитал половину книгу про "Рекомендательные системы" на основе LLM - это тоже отличная книга про state of the art рекомендательные системы и как теперь в них используются языковые модели)
3) Agentic Deign Patterns - фундаментальная книга про паттерны агентной разработки от автора, что работает в Google

В общем, для сфокусированного чтения отсутствие интернета - это скорее плюс:)
  • 👍 15
  • ❤ 10
  • 🔥 2
Post #4703 3.17K
Stack Overflow Developer Survey 2026: опрос уже сам стал картой агентной разработки (Рубрика #AI4SDLC)

Недавно полчаса заполнял новый большой опрос Stack Overflow (он стартанул 23 июня 2026 года и все еще доступен для прохождения). Я шел туда не столько за привычным набором "языки, базы, IDE", сколько из любопытства: что Stack Overflow в этом году спрашивает про AI. И там хорошо виден сдвиг - это уже не про чаты или автодополнение, а попытка измерить, как AI и агенты входят в производственную систему разработки (примерно про то же было и в недавном пульс-опросе от StackOverflow, что я разбирал).

Если говорить про сам опрос, то теперь его вопросы можно найти в репо на GitHub (это супер-круто). И если туда заглянуть, то AI больше не выглядит отдельной секцией в конце анкеты. И хоть выделенный блок AI + AI Agents присутствует, но сами AI-вопросы расползлись и в технологии, и в сообщество, и в knowledge/context. Stack Overflow спрашивает не только про инструменты, а про доверие, контекст, атрибуцию авторства, стоимость, память, контроль, наблюдаемость и задачи, которые люди реально делегируют агентам.

Если попробовать описать диффы подробнее и по пунктам, то выйдет так

1️⃣ Уходим от одного монолитного "AI adoption" к разным типам AI в работе

Вопрос `AISelect` отдельно разводит кодинговых асситентов и кодинговых агентов, чаты общего назначения, AI агентов для автоматизации рабочих процессов и внутренние AI-инструменты компании. Дальше идут частота использования, доля рабочего дня, количество разных AI-инструментов за неделю и причины переключения между ними. Для AI4SDLC это важное разделение: у чата рядом с человеком, кодинг агента в IDE и внутреннего enterprise-инструмента разные права доступа, риски и способы проверки результата.

2️⃣ Сдвиг в сторону агентной разработки
Вопрос `AIWork` раскладывает workflow по сценариям: архитектурное исследование, генерация кода в знакомой и незнакомой области, onboarding в кодовую базу, дебаг/рефакторинг, тесты, ревью, безопасность, документация, внутренняя база знаний, анализ логов и метрик, тикеты/планы, dev/test среды и прод системы. Для каждого сценария спрашивают не только текущее использование, но и ожидание на следующий год.

Рядом есть еще более конкретный вопрос из блока knowledge/context: какие задачи за последние 30 дней вы делегировали AI инструментам или агентам со списком вариантов: код, дебаг, ревью кода, тесты, документация, архитектурные решения, планирование, изменение прод систем, развертывания, мониторинг, расследование инцидентов, безопасность/приватность/комплаенс, аналитика данных и координация между командами. Кажется, что здесь ребята пытаются оценить куда сейчас люди готовы пустить работать агента:)

3️⃣ Инструменты уже рассматриваются как стек

- Отдельно спрашивают про кодинг агентов и/или ассистентов: Claude Code, Cursor, OpenAI Codex, GitHub Copilot, Devin, Jules, Warp, Cline, Aider и длинный хвост новых игроков
- Отдельно - no-code agent builders, automation, orchestration/frameworks, memory/vector databases и observability/evals tooling: LangGraph, OpenAI Agents SDK, LangSmith, Langfuse, Braintrust, Promptfoo, DeepEval, Ragas и другие.
В 2026 Stack Overflow уже спрашивает так, чтобы оценить популярность инструментов в каждой части этого AI-стека

4️⃣ Доверие формулируется через проверяемость
В `AITrust есть не просто "trust / don't trust", а градации: доверяю только low-risk задачам; доверяю, когда могу легко проверить результат; доверяю многим задачам, но не важным work decisions. А в AIWorkNext` спрашивают, что человек делает перед использованием AI-generated answer: запускает локально, читает official docs, ищет Stack Overflow, спрашивает коллегу, проверяет tests/security implications, сравнивает с codebase context или использует как есть.

5️⃣ Настало время экономики и governance

В `AIAdopt` спрашивают, что важно при выборе или расширении AI инструмента/модели: точность, попадание в workflow, безопасность/приватность, комплаенс, цена относительно ценности, мониторинг/лимиты расходов, возможность сменить инструмент/модель без большой боли, свидетельства бизнес результатов, встроенная наблюдаемость, нагрузка на ревью, возможность присмотра людьми и так далее. Вопрос тут в том, а сумеет ли организация сделать AI операционно управляемым.

6️⃣ Есть и отдельный слой про Stack Overflow как продукт и сообщество
В `SOChange` спрашивают, как AI изменил использование Stack Overflow: стали ли люди реже заходить за простыми вопросами, чаще заходить для verification/source attribution, задавать меньше вопросов, задавать более сложные вопросы, меньше или больше контрибьютить. Если простые ответы уехали в чат, то ценность публичного Q&A смещается в проверяемость, источники, опыт людей и сложные случаи, где AI-ответ надо чем-то заземлить.

В общем, этот опрос показывает, какую карту реальности Stack Overflow пытается построить в 2026 году. И эта карта сильно сдвинута от "AI как ассистент в редакторе" к "AI как агентная операционная модель разработки".

#AI #AI4SDLC #Agents #Engineering #Software #Management
Stack Overflow Developer Survey Every year we ask developers about the tools they use, how they learn, and how they work. Explore the results of the largest survey of people who code.
  • ❤ 4
  • 👍 2
  • 🔥 2
Post #4696 3.07K
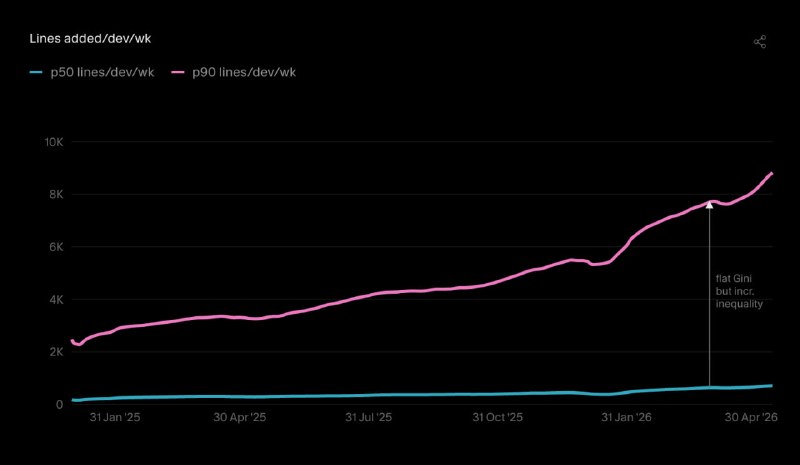
И по традиции прикладываю самые интересные иллюстрации из отчета "Cursor Developer Habits Report"
  • ❤ 2
  • 👍 2
  • 🔥 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →