TGViewer
Channel Public Channel
Big data world

Big data world

@bigdata_world

Интересные статьи Data Science : Big Data : Machine Learning : Deep Learning

По вопросам сотрудничества- @Daily_admin_info

По иным темам @un_ixtime
Subscribers
2.24K
Photos
413
Videos
64
Links
1.3K

Showing posts older than #1008 · Back to latest

Older Posts 20 shown
Post #1007 768
Roboflow только что выпустил новую версию «supervision». Это швейцарский армейский нож с открытым исходным кодом для всего, что касается Computer Vision. Он позволяет реализовать обнаружение, классификацию, сегментацию, аннотирование любого видео. Это новое обновление добавляет расширенную видеоаналитику: трекеры, зоны, аннотаторы и многое другое.
https://github.com/roboflow/supervision
Post #1006 624
FastViT: быстрый гибридный преобразователь зрения, использующий структурную репараметризацию

Слияние трансформаторной и сверточной архитектур открыло новую эру повышенной точности и эффективности моделей, и FastViT находится в авангарде этой революции. Эта новая архитектура гибридного преобразователя зрения может похвастаться впечатляющим компромиссом между задержкой и точностью, устанавливая новые стандарты в этой области. Ключом к его успеху является RepMixer, инновационный оператор микширования токенов, который использует структурную репараметризацию для сокращения затрат на доступ к памяти за счет отказа от традиционных пропускных соединений.

С практической точки зрения мастерство FastViT неоспоримо. Он не только в 3,5 раза быстрее, чем CMT на мобильных устройствах для точности ImageNet, но и оставляет позади EfficientNet и ConvNeXt, которые в 4,9 и 1,9 раза быстрее соответственно. Кроме того, в сравнении с MobileOne с аналогичной задержкой FastViT выходит победителем с точностью на 4,2% выше, чем у Top-1. По всему спектру задач, от классификации и обнаружения изображений до сегментации и регрессии 3D-сетки, FastViT неизменно превосходит своих конкурентов, демонстрируя замечательную скорость и устойчивость к образцам, не входящим в дистрибутив, и искажениям.

Ссылка на статью: https://huggingface.co/papers/2303.14189
Ссылка на код: https://github.com/apple/ml-fastvit
Обзор статьи: https://andlukyane.com/blog/paper-review-fastvit
GitHub GitHub - apple/ml-fastvit: This repository contains the official implementation of the research paper, "FastViT: A Fast Hybrid… This repository contains the official implementation of the research paper, "FastViT: A Fast Hybrid Vision Transformer using Structural Reparameterization" ICCV 2023 - apple/ml-fastvit
Post #1003 668
Шаблоны для создания систем и продуктов на основе LLM

Существует большой класс задач, которые легко вообразить и построить для них демоверсии, но чрезвычайно сложно сделать из них продукты. Например, беспилотное вождение: легко продемонстрировать автомобиль, который самостоятельно едет вокруг квартала, но для того, чтобы превратить его в продукт, требуется десятилетие

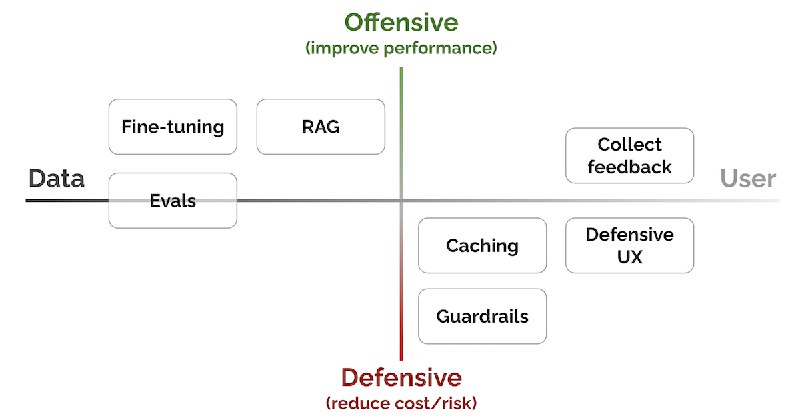
Эта статья посвящена практическим шаблонам интеграции больших языковых моделей (LLM) в системы и продукты. Мы будем опираться на академические исследования, отраслевые ресурсы и практические ноу-хау и преобразовывать их в ключевые идеи и практики. https://eugeneyan.com/writing/llm-patterns
eugeneyan Patterns for Building LLM-based Systems & Products Evals, RAG, fine-tuning, caching, guardrails, defensive UX, and collecting user feedback.
  • 👍 1
Post #1002 666
Модели ML запоминают или обобщают?

В 2021 году исследователи обнаружили «гроккинг», когда крошечные модели внезапно переходят от запоминания к обобщению невидимых входных данных. В этой интерактивной статье исследуется этот феномен и развивающаяся область механистической интерпретируемости, пытаясь понять, обобщают ли большие языковые модели или просто запоминают. https://pair.withgoogle.com/explorables/grokking

Большие языковые модели, объясненные с минимумом математики и жаргона

Хотите действительно понять, как работают большие языковые модели? Вот нежная грунтовка. https://www.understandingai.org/p/large-language-models-explained-with
Withgoogle Do Machine Learning Models Memorize or Generalize? An interactive introduction to grokking and mechanistic interpretability.
Post #1001 1.5K
Все алгоритмы реализованы на Python. 🤯

У этой библиотеки 163 тысячи звезд на GitHub! Он включает в себя массу алгоритмов от арифметического анализа до блокчейна и структур данных. https://github.com/TheAlgorithms/Python/blob/master/DIRECTORY.md
GitHub Python/DIRECTORY.md at master · TheAlgorithms/Python All Algorithms implemented in Python. Contribute to TheAlgorithms/Python development by creating an account on GitHub.
Post #1000 618
130 хитростей и ресурсов по ML, тщательно отобранных за 3 года (плюс бесплатная электронная книга)

В науке о данных и машинном обучении есть два типа трюков: редкие и очень крутые. Они предназначены для привлечения вашего внимания, но в конечном итоге вы никогда не будете их использовать , потому что их варианты использования слишком узки. Подумайте об этих однострочниках Python, которые ужасны с точки зрения удобочитаемости.

Во второй категории есть приемы редкие, крутые и настолько полезные , что вы сразу начнете использовать их в своей работе.

За три года своего путешествия в области данных я собрал более 100 приемов и ресурсов, подпадающих под вторую категорию (иногда могут быть небольшие совпадения с первой категорией), и собрал их в онлайн-книгу — Tricking Data Science .

https://towardsdatascience.com/130-ml-tricks-and-resources-curated-carefully-from-3-years-plus-free-ebook-7832ca4a37ef
Post #999 611
Создание deepfake видео и синтез речи open-source проект Wunjo AI.

Привет, мир!

Я бы хотел рассказать о своем open-source проекте Wunjo AI с открытым исходным кодом, который позволит вам создавать дипфейк видео и синтезировать речь из текста у себя на компьютере. В этом посте я постараюсь познакомить вас с возможностями Wunjo AI и пригласить вас поддержать проект на GitHub.

Познакомимся подробнееhttps://habr.com/ru/articles/752910
Хабр Создание deepfake видео и синтез речи open-source проект Wunjo AI Привет, мир! Я бы хотел рассказать о своем open-source проекте Wunjo AI с открытым исходным кодом, который позволит вам создавать дипфейк видео и синтезировать речь из текста у себя на компьютере. В...
  • ❤ 1
  • 👍 1
Post #998 534
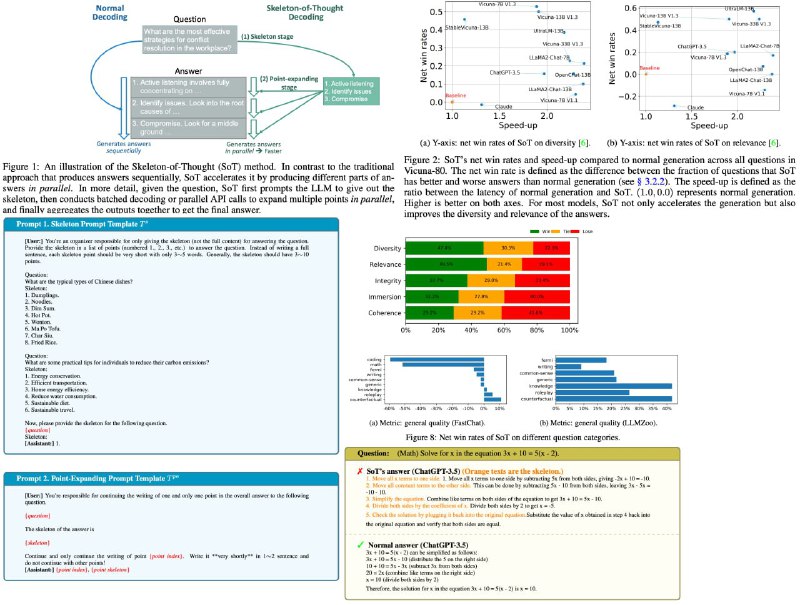
В попытке решить проблему задержки генерации больших языковых моделей (LLM) был разработан новый подход Skeleton-of-Thought (SoT). Мотивированный человеческим мышлением и процессом написания текста, SoT направляет LLM сначала на генерацию "скелета" ответа, а затем параллельно заполняет его содержанием. В результате достигается поразительное ускорение до 2,39 раза для 11 различных LLM без потери целостности последовательного декодирования.

Отличительной особенностью SoT является ее потенциал повышения качества ответов с точки зрения разнообразия и релевантности, что проливает свет на интересное направление развития ИИ. Как первая попытка оптимизации, ориентированной на данные, для повышения эффективности, SoT демонстрирует увлекательную возможность появления машин, которые могут мыслить как люди.

Ссылка на документ: https://arxiv.org/abs/2307.15337

Подробный обзор статьи:
https://andlukyane.com/blog/paper-review-sot
  • 🔥 3
  • 👍 1
Post #997 565
Начните использовать конвейеры. Это самый простой способ в 10 раз увеличить настройки машинного обучения. Идея конвейеров существует уже давно, но многие люди игнорируют их или думают, что они только помогают сделать ваш код более читабельным. Они гораздо больше, чем это. Конвейер — это независимая последовательность шагов, организованная для автоматизации процесса. Одним из основных преимуществ использования одного из них является возможность повторного использования процесса на разных этапах и с разными наборами данных. Вы должны создать конвейер для преобразования набора данных в начале проекта. Вы можете повторно использовать один и тот же конвейер для преобразования производственных данных, прежде чем запускать их через модель. Отсутствие конвейера — это немедленный красный флаг и признак того, что вы, в лучшем случае, дублируете код или, что еще хуже, преобразовываете производственные данные иначе, чем обучающий набор данных.
Post #996 573
[Перевод] OnnxStream: минимизация потребления памяти при генерации изображений.

Задача — запустить Stable Diffusion, включающую большую трансформирующую модель c почти 1 миллиардом параметров, на Raspberry Pi Zero 2 с 512 МБ RAM, не добавляя дополнительного пространства подкачки и не выгружая промежуточные результаты на диск. Рекомендуемый минимальный объём RAM/VRAM для Stable Diffusion составляет 8 ГБ. Читать дальше →https://habr.com/ru/companies/ruvds/articles/751912/
Хабр Запускаем Stable Diffusion на Raspberry PI Zero 2 (или на 260 МБ ОЗУ) Задача — запустить Stable Diffusion , включающую большую трансформирующую модель c почти 1 миллиардом параметров, на Raspberry Pi Zero 2 с 512 МБ RAM, не добавляя дополнительного пространства подкачки...
  • 👍 1
Post #994 525
Откройте секреты выбора идеального алгоритма машинного обучения!

При работе над проблемой науки о данных одним из наиболее важных решений является выбор подходящего алгоритма машинного обучения. https://www.kdnuggets.com/2023/07/ml-algorithm-choose.html
KDnuggets Unlock the Secrets to Choosing the Perfect Machine Learning Algorithm! When working on a data science problem, one of the most important choices to make is selecting the appropriate machine learning algorithm.
Post #993 660
[Перевод] Как сделать контекстное окно на 100K в большой языковой модели: обо всех фокусах в одном посте.

В статье рассмотрены приёмы, позволяющие ускорить обучение больших языковых моделей (LLM) и нарастить в них логический вывод. Для этого нужно использовать большое контекстное окно, в котором умещается до 100K входных токенов. Вот эти приёмы: ALiBi с подмешиванием в вектор позиции слова в последовательности (positional embedding), разреженное внимание (Sparse Attention), мгновенное внимание (Flash Attention),  многозапросное внимание, условные вычисления и GPU A100 на 80 ГБ.  

Читать далее https://habr.com/ru/articles/752062/
Post #992 620
Шаблоны для создания систем и продуктов на основе LLM

Этот пост посвящен практическим шаблонам интеграции больших языковых моделей (LLM) в системы и продукты. Мы будем опираться на академические исследования, отраслевые ресурсы и ноу-хау практиков и пытаться превратить их в ключевые идеи и практики. https://eugeneyan.com/writing/llm-patterns/
eugeneyan Patterns for Building LLM-based Systems & Products Evals, RAG, fine-tuning, caching, guardrails, defensive UX, and collecting user feedback.
  • 👍 1
Post #991 597
Набор инструментов с открытым исходным кодом для разработки LLM

🚀LLaMA2-Accessory — это набор инструментов с открытым исходным кодом для предварительного обучения, тонкой настройки и развертывания больших языковых моделей (LLM) и мультимодальных LLM . https://github.com/Alpha-VLLM/LLaMA2-Accessory
Post #990 633
IBM предлагает БЕСПЛАТНЫЙ курс Deep Learning with Python и PyTorch!
Этот курс является второй частью курса из двух частей о том, как разрабатывать модели глубокого обучения с использованием Pytorch. https://www.edx.org/course/deep-learning-with-python-and-pytorch
edX IBM: Deep Learning with Python and PyTorch. | edX This course is the second part of a two-part course on how to develop Deep Learning models using Pytorch.
Post #988 591
Матричное исчисление, необходимое для глубокого обучения

Эта статья представляет собой попытку объяснить все матричное исчисление, необходимое для понимания обучения глубоких нейронных сетей. https://explained.ai/matrix-calculus/
explained.ai The Matrix Calculus You Need For Deep Learning Most of us last saw calculus in school, but derivatives are a critical part of machine learning, particularly deep neural networks, which are trained by optimizing a loss function. This article is an attempt to explain all the matrix calculus you need in…
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →