
Brain2Qwerty v2: неинвазивное предсказание речи становится ближе?
Предсказание речи из мозга давно является одной из самых «горячих» тем на стыке нейронаук и ИИ. Тут и нейрофутуризм в виде «чтения мыслей», и реальные приложения в виде речевых протезов: по активности мозга понять, что хотел сказать человек, утративший способность говорить, и озвучить через text-to-speech.
Сейчас направление ещё не «на потоке», а лучшие девайсы основаны на имплантах. Это связано с рисками операций, инфекций и деградации сигнала со временем.
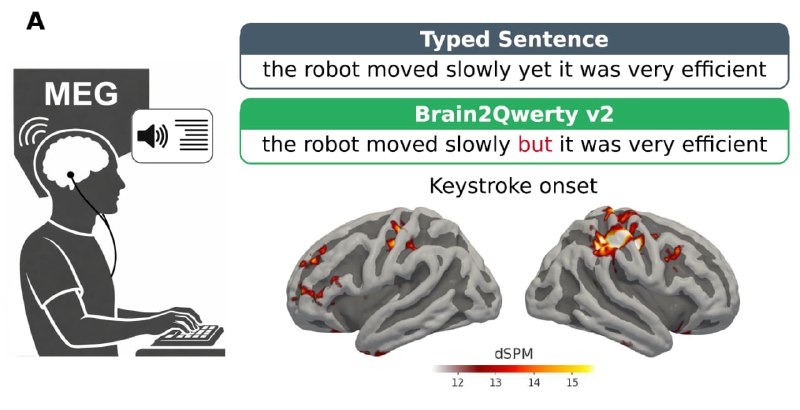
В этом ключе работа Meta* развивает неинвазивное декодирование: авторы создали Brain2Qwerty v2 — модель, которая по данным МЭГ предсказывает текст, набираемый человеком «слепой печатью» на клавиатуре. Это не декодирование воображаемой речи, но хороший тест неинвазивных данных в упрощённой brain-to-text задаче.
🖥 Данные
Авторы записали большой датасет: 9 человек находились в МЭГ-аппарате, слушали предложение, ждали 1.5 секунды и затем печатали его на клавиатуре. Во время печати человек не видел клавиатуры и уже набранной строки. Это важно, чтобы в сигнале мозга не остались «шорткаты» для модели в виде активности зрительной системы. Для этого же была пауза между прослушиванием и печатью — чтобы дистанцироваться от сигнала из аудио. Итого: ~90 часов МЭГ и ~22 тыс. предложений.
🔗 Архитектура
Brain2Qwerty состоит из 3 уровней:
1⃣ Участок МЭГ для целого предложения проходит через свёрточные и трансформерные слои. Получается последовательность эмбеддингов с частотой 25 Гц — вектор каждые 40 мс.
🔢 Здесь происходит одно из ключевых нововведений. Раньше в похожих задачах модель знала тайминги нажатий клавиш и предсказывала символ для каждого нажатия. В Brain2Qwerty v2 ей дают только последовательность векторов, а модель сама должна понять, когда нажали какую клавишу.
Для этого используется CTC. На каждом шаге модель предсказывает букву, пробел или «пусто». Потом длинный поток сжимается в текст: пустые шаги удаляются, соседние повторы схлопываются, а слова разделяются по пробелам. Здесь же эмбеддинги между соседними пробелами усредняют в один вектор на слово.
🔢 После CTC у авторов уже есть черновое предложение, но ошибка даже в паре букв может сделать слово неузнаваемым. Поэтому дальше сам черновой текст и вектора слов подают в LLM Qwen для «полировки» и финального текста.
📈 Основные результаты
➡️ Модель получила ошибку на уровне слов (WER) 39%, а на уровне символов (CER) 31%. Имплантируемые системы заметно сильнее с результатом для печати ~2% WER. Но для неинвазивных подходов это хороший прогресс, особенно учитывая, что модель не знает границ нажатий клавиш.
➡️ Scaling law: точность улучшается при большем количестве данных. Возможно, больший объём МЭГ позволит «дешево» повысить качество.
➡️ Нашлось противостояние смысла и конкретных символов: модели, чьи ответы ближе по смыслу к цели, чаще ошибаются в буквах. Например, используют синонимы: смысл близкий, но буквы неправильные.
➡️ Разнообразие > повторы. В нейронауках часто дают один и тот же стимул несколько раз, так как агрегация повторений снижает шум. Здесь при одинаковом количестве данных качество оказалось выше при большем разнообразии предложений без повторений.
➡️ Можно использовать меньше сенсоров. Полная система использует 306 МЭГ-сенсоров, но при переходе к случайным 230 и 153 сенсорам качество ухудшается всего на несколько процентных пунктов WER. Это полезно для компактных OPM-МЭГ систем, где сенсоров обычно меньше.
👨🔬 Ученые, похоже, всё ещё нужны
Авторы пытались улучшить результаты с помощью AutoResearch — агентской системы, где сильные LLM сами придумывают идеи, пишут код и пытаются получить результат. В ограниченном сетапе, где AutoResearch дали уже разработанную модель, система нашла инженерные ходы и улучшила качество. Но в сложном сетапе «с нуля», где ей дали репозиторий прошлой статьи и сказали создать модель самой, много кода даже не запускалось. Поэтому, если пользуетесь LLM, ключевые идеи, подходы и верификацию лучше оставлять на себе.
*Meta Platforms Inc. признана экстремистской организацией, её деятельность запрещена в РФ.
Post #15045
339