TGViewer
Channel Public Channel
Мир аналитика данных

Мир аналитика данных

@analysts_world

Пишу о рабочих буднях аналитика. Тут много рабочего кода, прохождение собеседований и еще много всего полезного.
https://www.linkedin.com/in/valeriashuvaeva
Автор канала: @Valeria_Shuvaeva
Subscribers
4.56K
Photos
143
Videos
3
Links
114

Showing posts older than #98 · Back to latest

Older Posts 20 shown
Post #96 2.74K
🔥 Я побывала на интенсиве, где разбирали тестовое задание в OZON ⚡️ на аналитика данных! И принесла самое интересное сюда для тех, кто не смог присутствовать!
Задание
Для выполнения этого задания требуется сгенерировать DataFrame с синтетическими данными. DataFrame должен состоять из 10000 строк и 5 колонок. Каждую из колонок мы предлагаем тебе создать и наполнить следующим образом:

🔹 1-я колонка – user_id – идентификатор пользователя. Длина user_id должна равняться 15-ти символам. Идентификатор состоит из случайной комбинации следующих символов: "1234567890abcdefghijk". Для каждой строки в DataFrame значение user_id формируются случайным образом.

🔹 2-я колонка – order_number – номер заказа. Столбец необходимо заполнить случайными значениями в диапазоне от 1 до 10.

🔹 3-я колонка – click2delivery – время, прошедшее с момента оформления заказа до вручения клиенту. Столбец необходимо заполнить случайными значениями из нормального распределения со средним 1440 и стандартным отклонением 200.

🔹 4-я колонка – order_items_sum – общая стоимость заказа. Значения для этого столбца необходимо взять из экспоненциального распределения с параметром λ = 1, смещённого на +1.

🔹 5-я колонка – retention – день жизни покупателя, в который он совершил заказ. Необходимо сгенерировать значения 1, 2, 3, 4, 5 с вероятностями 0.35, 0.25, 0.2, 0.15 и 0.05 соответственно.
В случае, если в колонке user_id встречаются дублирующиеся значения, оставь только первое из них.

Итак, импортируем библиотеки и задаем seed:
import pandas as pd
import numpy as np
import random
np.random.seed(42)

Это для того, чтобы скрипт выполнялся идентичным образом при каждом запуске. Мы предоставляем начальное значение (42 - популярный вариант).

Функция random.choice() возвращает один элемент из последовательности. Запихнем ее в созданную нами функцию generate_user_id(), а возвращать она будет соединенные join-ом выбранные по одному элементы из characters в количестве 15 штук.
def generate_user_id():
characters = "1234567890abcdefghijk"
return ''.join(random.choice(characters) for _ in range(15))
#Проверим как работает функция
generate_user_id()
'k4198854h3id213'


Теперь создадим функцию generate_df для генерации датафрейма.
И нашу функцию для user_id generate_user_id() запихнем в цикл for _ in range(n) чтобы нагенерировать 10 тыс строк.
Тут же создадим столбцы order_number, click2delivery, order_items_sum и retention.

def generate_df(n):
data = {
'user_id': [generate_user_id() for _ in range(n)],
'order_number': np.random.randint(1, 11, size=n),
'click2delivery': np.random.normal(1440, 200, size=n),
'order_items_sum': np.random.exponential(1, size=n) + 1,
'retention': np.random.choice([1, 2, 3, 4, 5], size=n, p=[0.35, 0.25, 0.2, 0.15, 0.05])
}
df = pd.DataFrame(data)
return df

df = pd.DataFrame()


А вы знали, что в питоне можно разряды в числах вот так показывать? n = 10_000 Я – нет. 😜
Пока длина df не будет 10 тыс будет выполняться соединение concat два датафрейма.
Условие n = 10_000 - len(df) при длине df 10 тыс строк будет равно 0 и while перестанет выполняться.
n = 10_000
while n:
new_df = generate_df(n)
df = pd.concat([df, new_df])
df = df.drop_duplicates(subset='user_id', keep='first')
n = 10_000 - len(df)

df.head()


Если хотите разбор следующих заданий в ближайшие дни ставим 🔥
  • 🔥 77
  • ❤ 5
Post #94 2.36K
📣 Я тоже буду интенсиве! Уже вижу что-то новое для себя. Да и тренировку на тестовых я люблю ❤️, это всегда на пользу.
  • ☃ 5
Post #92 2.87K
🔥 Установка PostgreSQL и создание таблицы в DBeaver из CSV ——————————————————————————————

Все-таки лучший способ для решения тестовых, для тренировки своих навыков в PostgreSQL – это установить базу к себе на компьютер и заливать туда csv файлы с нужными данными вместо создания таблиц. Да и оконки не потренируешь с pandasql, в которой синтаксис SQLite.
Я раньше думала, что это как-то сложно и потребуется много времени. Немного повозиться мне конечно пришлось, но зато теперь будет самая краткая инструкция!

✔️ Шаг 1 Грузим PostgreSQL для вашей операционной системы на странице официальной загрузки. Я ставила на Windows. Скачивается файл с расширением exe, который можно запустить и установить, как обычную программу! У меня этот файл соответственно назывался postgresql-16.1-1-windows-x64.exe Весил 361 МБ

Я выбрала 16 версию – самую новую. x64 - это 64-разрядная операционная система (какая у вас можно узнать в свойствах Мой компьютер). Там в характеристиках устройства указан тип вашей системы.
Запускаете инсталлятор – просто два раза щелкаете по файлу. В открывшемся окне выбираете Locale: «Russian, Russia» (русский язык в стране Россия) и далее выполняете то, что указано. Выбираете путь, где будет располагаться база. В конце установки снимите галочку в пункте Stack Builder. Там какие-то доп.утилиты предлагаются (не нужны короче, можно не заморачиваться)
На этом установка PostrgreSQL почти завершена! 🤪

✔️Шаг 2 Теперь заходите в Пуск и нажимайте pg и увидите слоника pgAdmin. При первом запуске pgAdmin просит задать Master Password. Он будет использоваться для безопасного сохранения паролей к базам данных PosgreSQL. Master Password можно выбрать любой, главное, запомнить его. И запомните номер Port (у меня 4 цифры). Это в свойствах (Properties)->Connection можно найти.
В целом только с помощью pgAdmin можно писать запросы, но я привыкла работать через DBeawer. Поэтому переходим к следующему шагу.

✔️Шаг 3 Если у вас не установлен DBeaver, то скачайте его тут.
У меня он уже установлен для работы. Идем в меню База данных. Там выбираем Новое соединение. Выбираем PostgreSQL. В настройках прописываем: Хост - localhost, база данных – postgres, Порт – тот номер Port из pgAdmin, пароль тоже вводим и жмем OK.

Теперь в списках баз DBeaver появился postgres с зеленой галочкой. Кликаете правой кнопкой мыши по postgres — Редактор SQL — Новый редактор SQL. Он Создадим схему. Пишем create schema test Теперь создадим таблицу. Сначала нужно обновить список объектов. Встаем на значок postgres внутри Базы данных и жмем F5. Появились наша схема test. А внутри название Таблицы. Правой клавишей мышки щелк и выбираем Импорт данных. В открывшимся окне, выбираем файл csv, который необходимо загрузить. Настраиваем параметры при необходимости. Здесь обращаю внимание на “Разделитель столбцов”, если в итоге вы получили некорректную таблицу, то необходимо проверить какой разделитель в исходном файле (иногда помогает сменить разделитель с запятой (,) на точку с запятой (;)). Нажимаем “Далее”, а потом “Продолжить”. Идет загрузка данных.
📌 И, ура, у нас табличка с нашими данными из файла! 🎯 Тип данных колонок можно менять прямо в свойствах.
  • 🔥 16
  • 👍 9
  • ❤ 3
  • 🤩 1
Post #91 1.98K
  • 👍 2
Post #90 2.53K
✅ Когда где-то что-то дается бесплатно, то надо этим пользоваться. Тем более библиотека Pandas 🐼 - это прямо must have для аналитика! Это главная библиотека в Python для работы с данными. Вы это видите по моим скриптам.
  • ☃ 10
  • 👍 7
  • 💯 1
Post #88 3.04K
📍Горячие пирожки тестовые. Налетаем, разбираем, изучаем!

Есть табличка в Excel по продажам с указанием клиентов, проданных товаров, себестоимости, цены продажи. Нужно сделать следующие SQL запросы.

✅ Задача 1

Какая неделя стала лучшей по прибыли и указать саму сумму прибыли. Описания полей смотрите на картинке.
В таблице кроится небольшая хитрость. Есть колонка price_b2b_gross и колонка price_b2c_gross, а колонка количества купленных товаров в заказе только одна и не понятно к чему она относится – к b2b (юр.лицам) или к b2c (физ.лицам)
Считается, что вы или спросите или сами сделаете допущение, что наверно к b2c.

Загружаем файл в Юпитер (скачать ноутбук можно здесь , а файл с excel данными - вот тут берем), получаем датаффрейм и воспользовавшись библиотекой pandasql (о ней писала вот тут) пишете sql код. Не забываем, что эта библиотека реализует язык запросов СУБД SQLite. Поэтому есть конечно ряд ограничений, нельзя использовать операторы как в PostreSQL Например, DATE_PART('week', date_create). Нужно найти его аналогию и это strftime('%W',date_create), которая вытащит вам номер недели.

Сначала находим группировкой сумму прибыли за каждую неделю, не забываем указать в фильтре where status = 0 Так как в описании полей прописано, что Статус заказа (0 - Выдан, остальные - Отменен) А потом сортируем по сумме от большего к меньшему (order by 2 desc, 2, так как вторая колонка ) и берем ограничение в 1 строку limit 1. Ну и округлим до 2х знаков после запятой round() для красоты.

Select strftime('%W',date_create) as 'лучшая неделя',
round(sum(price_b2c_gross*quantity-cost_price*quantity),2) as 'сумма прибыли'
From df
where status = 0
group by 1
order by 2 desc
limit 1


Есть нюанс, что если вот прям две недели совпали один в один, то вы потеряете инфу про вторую такую прибыльную неделю. Так как указан limit в одну строку. Вряд ли такое возможно, но есть вероятность. ⚡️
Поэтому покажем и 2ой способ скрипта. И чем больше вы продемонстрируете как вы можете сделать задачку и придумать способы, тем лучше. 👌

🌟 Сначала так же находим максимальную сумму за неделю. Потом находим, как и в первом варианте все недели и их суммы и в условии where прописываем, чтобы сумма из таблички с недельными суммами равнялась той максимальной сумме.
Select weekofyear as 'лучшая неделя', round(amount,2) as 'сумма прибыли'
from
(
Select strftime('%W',date_create) AS weekofyear,
sum(price_b2c_gross*quantity-cost_price*quantity) as amount
from df
where status = 0
group by 1
) t1
-- фильтруем то, где сумма за неделю (t1.amount) будет равна максимальной сумме
where t1.amount = (Select max(amount) -- находим максимальную сумму за неделю
From
(Select strftime('%W',date_create) AS weekofyear,
sum(price_b2c_gross*quantity-cost_price*quantity) as amount
From df
where status = 0
group by 1)
t2)


Мы можем уже обратиться тут к переменной amount, так как мы ее в подзапросе создали. И помним, что если подзапрос идем как табличка после FROM, то нужно указать ее название. Просто t1, допустим.

✅ Задача 2
Рассчитать маржу в рублях и % по всей компании за август. Вывести поля: Сайт, Приложение Строки: Маржа руб., Маржа %
Предоставить запрос в SQL и значения.

Во первых, маржа - это разница между себестоимостью товара и ценой, по которой продают товар. Почему тогда в первом задании назвали то же самое суммой прибыли? А вот и не важно, это тоже для того, чтобы вы подумали и поняли, что по сути это то же самое и формула будет такой же price_b2c_gross*quantity-cost_price*quantity

Продолжение в комментариях. 👉
  • 👍 16
  • ❤ 6
Post #85
Мир аналитика данных pinned «📍 Пришло время упорядочить свои посты. Чтобы вам легче было в них ориентироваться и отыскать что-то нужное. 🐍 🔤🔤🔤🔤🔤🔤 ✨ - Живой кодинг на собеседовании. Примеры. - Тестовое в Skyeng (ссылка на скрипт в комментариях) - markdown и вставка картинок в Jupyter…»
Post #84 4.78K
📍 Пришло время упорядочить свои посты. Чтобы вам легче было в них ориентироваться и отыскать что-то нужное.

🐍 🔤🔤🔤🔤🔤🔤 ✨

- Живой кодинг на собеседовании. Примеры.
- Тестовое в Skyeng (ссылка на скрипт в комментариях)
- markdown и вставка картинок в Jupyter Notebook
- Метод format в Питоне
- Рабочий пример отчета для отдела продаж – формирование группы клиентов по разным условиям
- Особенности pivot_table на питоне
- Примеры сводной таблица pivot_table()
- Создание диапазона дат на питоне
- Рабочий скрипт по отвалу клиентов
- Отвал клиентов с доп.условиями
- Три топ клиента за год в каждой нише
- Кумулятивная функция сumsum()
- Примеры функции transform()
- Вопросы с собеседований по Python и Pandas
- Как определить к какой стране относится номер телефона? библиотека Phonenumbers
- Скрипт по когортному анализу (часть на SQL, часть на пандасе)
- Примеры np.where()
- Регулярные выражения на Питоне. модуль re

✨🔤🔤🔤✨ ✨

- Пример рабочего SQL скрипта в Jupyter Notebook
- Трафик, лиды, конверсия
- SQL Between
- HAVING в SQL
- Вопросы с собеседований по SQL
- Тестовое с решением
- Скрипт по когортному анализу (часть на SQL, часть на пандасе)
- Примеры использования CASE
- Group by на примере из курса Карпова и на рабочем примере.
- Регулярка для Clickhouse
- Библиотека Pandasql для написания SQL кода в Jupyter Notebook

✨ 🔤🔤🔤🔤🔤 ✨

- Как уменьшить вес Excel файла
- Excel vs Google таблицы
- Условное форматирование в Google таблицах.
- Выгрузка всех файлов с диска в Excel

✨☹️☹️😙🤑😓😓 ✨

- Как я сменила профессию
- Какие бывают аналитики
- Мотивация
- Теория вероятности на минималках
- Как заходить в LinkedIn без VPN
- YandexGPT 2 рассказал почему стоит выбрать карьеру в аналитике данных

p.s. Вам знакомо то чувство чистоты, когда у вас на рабочем столе был бардак, а вы взяли и навели порядок? Книжки расставили по местам, бумаги рассортировали по папкам и протерли пыль с клавы. Вот сейчас что-то похожее ощущаю 🍀
  • 🔥 50
  • ❤ 6
  • 👍 6
  • 💩 2
  • ✍ 1
  • ❤‍🔥 1
Post #83 3.72K
🔥 Как тестировать SQL код при решении тестовых? Есть библиотека Pandasql. 🛠 Она позволяет выполнять SQL-запросы прямо в Юпитере, а вместо базы можно просто создавать DataFrame.
Например:
from pandasql import sqldf
import pandas as pd
# Создание DataFrame user_actions
user_actions = pd.DataFrame({'user_id': [1, 1, 2, 3, 3],
'order_id': [101, 102, 103, 104, 105],
'action': ['create_order', 'cancel_order', 'create_order', 'create_order', 'cancel_order']})

Предположим, у нас есть таблица user_actions с информацией о действиях пользователей на нашем сервисе, включая id пользователя, id заказа и тип действия. Мы хотим отобрать всех пользователей, которые ни разу не отменяли заказы.
Выполнение SQL-запроса с помощью pandasql:
query = """
SELECT DISTINCT user_id
FROM user_actions
WHERE user_id NOT IN (
SELECT user_id
FROM user_actions
WHERE action = 'cancel_order'
)
"""
sqldf(query)

Мы используем подзапрос, чтобы получить все user_id пользователей, которые отменили заказы, и затем исключаем этих пользователей из основного запроса с помощью оператора NOT IN.

Таким образом, мы получаем результат, который содержит только user_id пользователей, которые ни разу не отменяли заказы.

Учитывая, что осень - пора активных собеседований, то кому-то это точно пригодится. ✔️

P.S. Пост про то, какие онлайн сайты можно использовать для SQL у меня тут
  • 🔥 22
  • 👍 2
Post #81 3.08K
❗️❗️❗️Друзья, ко мне обратилась hr крупного федерального ритейлера с просьбой опубликовать вакансию. Это хороший шанс для подписчиков поэтому я это делаю бесплатно. 👍
А еще Александра заметила, что есть много вопросов по резюме, поэтому предложила свою помощь! Отправляйте ей свои резюме, она подскажет, где их нужно скорректировать и какими видят их эйчары.👌

Пишите на почту: susandra@inbox.ru с пометкой, что от канала Мир аналитика данных (так вас быстрее заметят)
  • 👍 10
  • ❤ 5
Post #80 2.89K
🥰Я вот тут подумала. Все мы хотим чувствовать поддержку пока идем к своей цели. Но ведь бывает зачастую так, что очень мало людей в окружении которые тоже хотят попасть в IT. 👨‍💻 И они не понимают с какими трудностями мы сталкиваемся. Сколько нужно всего выучить, сколько чашек кофе выпить сил приложить для достижения результата. Ладно еще просто учиться, а сколько отказов от эйчар будет бить ⚡️по вашей почти устойчивой психике на радость платным психологам! 💰А когда эта цель - заветный оффер еще и не сразу достигаема, то хочется опустить руки и не продолжать больше.

И если родные, близкие и друзья пожимают плечами и говорят: "- Да, забей. Все равно не получится", то это демотивирует очень сильно. Я наслышана о разных историях, так как "варюсь" в этом уже давно и хотела предложить вам такую простую, но искреннюю идею.
✔️Давайте поддерживать друг друга прям тут. Если кто-то сомневается, что получится - пиши в комменты и мы всегда поддержим тебя. Хоть смайликом, хоть парой фраз. Не сомневайся! Будем как дружная IT банда! 🤝

А когда случается радость - и заветный оффер в кармане, то порадуемся за человечка от всего сердца ❤️. И пожелаем ему много сил, терпения и веры в себя. Ведь первый/второй и т.д. оффер - это бесконечный путь развития своих скиллов и себя как личности на бесконечной дороге профессионального роста.
Так что @m0t0rama, держись там! Мы мысленно с тобой, поздравляем с оффером и желаем удачи! 🤝

Еще с утра я не думала, что накатаю такой пост. Но что-то захотелось и по фиг, что сейчас уже поздно и наверно имело смысл подождать до завтра. Не всегда следует действовать логично, иногда нужно прислушиваться к сердцу.
  • ❤ 61
  • 👍 10
  • 🔥 8
Post #79 2.85K
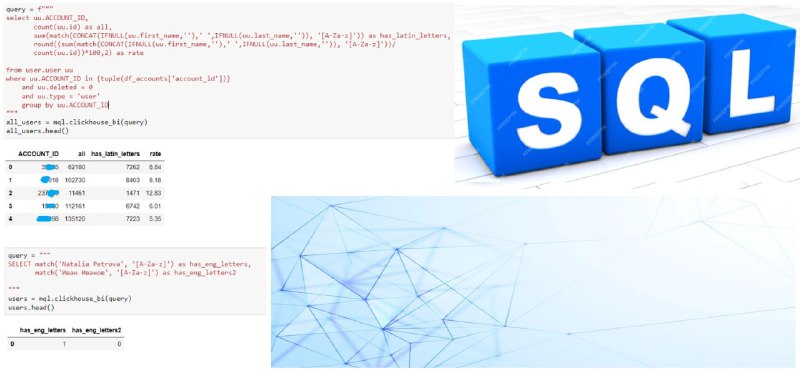
Что может пойти не так? ❓ Месяц назад выкладывала тут задание про поиск клиентов, у которых более 70% пользователей с именами на латинице. Сделала его на питоне. Питон крут и все такое.
Но есть проблемка.. выгрузки по 50 млн строк и питон хоть и тянет, но обрабатывает дооолго. Решила переписать на SQL. Но не просто SQL, а для Clickhouse. Ему такое – море по колено.🌊

Стала искать гуглить про регулярки для Clickhouse. И вот, что нашла: match(где ищем, шаблон)
Сначала concat соединяю фамилию и имя пользователя, а потом оборачиваю в match и вторым аргументом прописываем [A-Za-z] – ищем английские буквы как в большом, так и в малом регистре. А потом заворачиваем все это безобразие в sum, чтобы посчитать количество пользователей так как результат match выдает единички напротив каждого с английскими буквами (смотрим пример на картинке).

SUM(MATCH(CONCAT(IFNULL(uu.first_name,''),' ',IFNULL(uu.last_name,'')), '[A-Za-z]')) as has_latin_letters
Чтобы прописать сразу и rate пишем вот так:

select uu.ACCOUNT_ID,
count(
uu.id) as all,
SUM(MATCH(CONCAT(IFNULL(uu.first_name,''),' ',IFNULL(uu.last_name,'')), '[A-Za-z]')) as has_latin_letters,
round((sum(match(CONCAT(IFNULL(uu.first_name,''),' ',IFNULL(uu.last_name,'')), '[A-Za-z]'))/
count(
uu.id))*100,2) as rate
from user.user uu
where uu.ACCOUNT_ID in {tuple(df_accounts['account_id'])}
and uu.deleted = 0
and uu.type = 'user'
group by uu.ACCOUNT_ID

В результате скрипт летает как Карлсон в самом расцвете сил 🚀
  • 🔥 41
Post #78 2.96K
Проклинаешь рекрутера за фидбэк, которого нет? Бог тебя услышал.

аналитик от бога — свежий канал про карьеру и проф развитие как для начинающих аналитиков, так и для тимлидов.

🅰️Владислав, ex-Teamlead из Альфа-банка, ярко и с юмором пишет заметки и статьи о том, как аналитику выйти на новый уровень в своей карьере.

Вот топ лучших постов канала:

♦️Как можно выделиться на фоне других кандидатов?
♦️Гайд по работе с документацией API
♦️Как аналитику проявить себя на новом проекте?
♦️Обзор API и протоколов

Сделай отклик в храм финтеха!
  • ❤ 11
  • 👍 1
  • 👎 1
  • 🔥 1
Post #77 2.89K
👍 А вы попробовали YandexGPT 2? Яндекс вчера ее представил. Я вбила вопрос “Почему стоит выбрать карьеру в аналитике данных?” Не, ну а что, пусть расскажет.

И вот что он/она (наверно она, это же нейросеть) выдала:
Выбор карьеры в аналититике данных может быть привлекательным для многих профессионалов по следующим причинам:
✔️1. Высокий спрос на специалистов: Аналитики данных и специалисты в области анализа данных востребованы во многих отраслях, включая IT, финансы, науку, производство и другие. Это обеспечивает широкие возможности для трудоустройства и карьерного роста.

✔️2. Достойная оплата труда 💰: Аналитики данных обычно получают хорошую заработную плату, так как их навыки и опыт ценятся на рынке труда. Уровень дохода зависит от опыта работы, компании и региона, но в целом аналитики данных могут рассчитывать на конкурентоспособную зарплату.

✔️3. Перспективы профессионального роста: Аналитика данных — это постоянно развивающаяся область, где специалисты могут совершенствовать свои навыки и знания, изучать новые методы и технологии, а также переходить на более высокие позиции, такие как руководитель отдела анализа данных, архитектор данных или директор по аналитике.

Сначала я посмеялась с аналититики. А если серьезно, то действительно есть высокий спрос. Самый большой спрос на мидлов и выше, если честно. Но и джуну реально найти работу. Я же в свое время нашла.
Оплата действительно достойная. Буду надеяться что с каждым годом она будет достойнее и достойнее. 😂 Насчет профессионального роста — в точку. Есть много направлений в аналитике и есть куда расти и в чем совершенствоваться 📊.

В целом нейросетка права и я с ней согласна. Я бы еще добавила, что это еще и ИНТЕРЕСНО 🤪.
Ну и если Вам нужен какой-то знак или ментальный пинок, чтобы начать/продолжить заниматься или подредактировать резюме и выходить на рынок hh, то пусть этот пост будет таким знаком для вас ⚡️. В сентябре наверняка будет больше вакансий после лета. Ну и с меня поддержка ❤️. Можете писать в комментах, на каком вы сейчас этапе своего пути!
  • ❤ 11
  • 👍 8
  • ❤‍🔥 1
  • ⚡ 1
Post #76 2.78K
👀 Розыск регулярных выражений
⁉️ Озадачили тут меня недавно запросом. Реально ли найти клиентов (account_id) у которых более 70% пользователей с именами на латинице.

- Конечно реально, - ответила я и принялась вспоминать гуглить регулярные выражения. Регулярка- это некий шаблон, по которому фильтруется текст. В Python для работы с регулярными выражениями используют модуль re.
^ - Соответствует началу строки.
[a-zA-Z] — любая буква на латинице в нижнем и верхнем регистре;
[0-9] — любая цифра от нуля до девяти

🔹 Как пример:
import re
s = "Yelena_Shon"
search =
re.search(r'[a-zA-Z0-9]', s)
print(search)
Код выдаст <_sre.SRE_Match object; span=(0, 1), match='Y'>

🔹Еще вариант:
s = "Иван Петров"
search =
re.search(r'[a-zA-Z0-9]', s)
print(search)
А этот код выдаст None
Но нам нужно как-то это применить в датафрейме, а не просто к строке, поэтому воспользуемся в дальнейшем apply.

🔥 Итак, я выкачала юзеров в датафрейм all_users со столбцами account_id, user_id, full_name.
Создадим столбец 'check_name', в котором будем записывать результат проверки
all_users['check_name']= all_users['full_name'].apply(lambda x: re.search(r'^[a-zA-Z0-9]',str(x))).fillna(0)

Затем отбираем там, где не ноль, чтобы потом посчитать юзеров написанных на латинице
all_eng_users = all_users[all_users['check_name']!=0]

Делаем группировку по аккаунтам c подсчетом количества пользователей (user_id) и создаем датафрейм count_eng_users. В нем будет две колонки: номера клиента-account_id и кол-во пользователей, написанных на латинице:
count_eng_users = all_eng_users.groupby('account_id', as_index = False).agg({'user_id':'count'}).rename(columns ={'user_id':'eng_count_users'})

Теперь то же самое сделаем, чтобы подсчитать сколько в аккаунтах есть пользователей не на латинице (то есть на русском языке, вариант “на китайском” автоматически отбрасываем, вряд ли такие есть вообще).

all_rus_users = all_users[all_users['check_name']==0]
count_rus_users = all_rus_users.groupby('account_id', as_index = False).agg({'user_id':'count'}).rename(columns ={'user_id':'rus_count_users'})

Далее объединяем эти две получившиеся таблички по account_id.
users_merged = pd.merge(count_rus_users, count_eng_users, on = ['account_id'], how = 'outer').fillna(0)

В результате получим табличку users_merged с колонками: account_id, rus_count_users, eng_count_users
Посчитаем % :
users_merged['% иностранных пользователей'] = round(((users_merged['eng_count_users']/(users_merged['eng_count_users']+users_merged['rus_count_users']))*100),1)

🚀 Ну и зафиналим. Отберем те аккаунты, у которых у которых более 70% пользователей с именами на латинице:
df_eng_name_users_more70 = users_merged[users_merged['% иностранных пользователей']>=70]

А вот тут можно потренироваться с регулярками:
🔹www.regextester.com
🔹regex101.com

Если Вам нравится, что я привожу рабочие примеры, то ставьте лайки👍, огонечки 🔥 и прочее.
Очень много блогов, где есть ссылки на статьи, какие-то примеры с питоном и sql, но почти не встречала, чтобы аналитики показывали свой код, какие-то задачи с работы. Надеюсь, Вы это оцените ❤️
  • 👍 54
  • 🔥 27
Post #75 2.51K
🆒 Недавно подписалась на канал, который ведет опытный продуктовый аналитик Юрий Борзило. Он так и называется Борзило
Очень интересно и много полезной практики:
✔️ Как быстро прокачаться в настройке систем веб-аналитики?

✔️
Что влияет на размер выборки и длительность АБ теста?

✔️ Как прокачать скилл аналитика?
Хороших каналов мало не бывает 👍
Telegram Борзило ⇨ Про аналитику, продукты, маркетинг ⇨ Автор курса по АБ тестам ⇨ Смело пиши - @borzilo_y ИНН 026702638983
  • 🤩 10
  • ❤ 1
Post #74 2.87K

Forwarded from Data jobs — вакансии по data science, анализу данных, аналитике, искусственному интеллекту

👨🏻‍💻 Младший аналитик данных

SMS Traffic — является крупным игроком на рынке коммуникации компаний и клиентов, при помощи различных каналов связи, ищет младшего аналитика данных

Что почём?

▪️Junior
▪️До 100 000 ₽
▪️Офис (Москва)

📩 Изучить вакансию
hh.ru Вакансия Младший аналитик данных в Москве, работа в компании SMS Traffic (вакансия в архиве c 29 августа 2023) Зарплата: до 100000 ₽ за месяц. Москва. Требуемый опыт: 1–3 года. Занятость: полная. Дата публикации: 14.08.2023.
  • ❤ 8
Post #73 2.5K
🔥 Увидела эту вакансию и не смогла пройти мимо. Такие минимальные требования для входа в IT редко встречаются. Да и вообще вакансий для младших аналитиков днем с огнем что называется! Для кого-то это шанс! Откликайтесь, вдруг как раз счастливчика отсюда возьмут, расскажите потом. 🤞 P.S. Это не реклама если что.
  • 👍 9
Post #72 3.04K
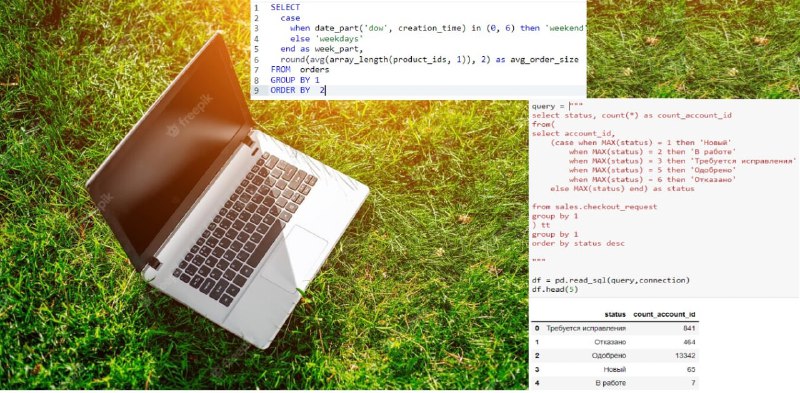
🔤🔤🔤🔤🔤 🔤🔤 на примере из курса Карпова и на рабочем примере.
Как всем известно этот оператор группирует строки и потом используя агрегирующие функции (SUM, AVG, COUNT, MIN, MAX ) над элементами этих групп и проводятся определённые операции.
Но просто один GROUP BY – это слишком легко, поэтому мы им воспользуемся вместе с CASE, а в случае рабочего примера еще и с подзапросом. Мощно, да? 💪

🔹Итак, это пример задания у Карпова:
Группу с выходными днями (суббота и воскресенье) назовите «weekend», а группу с будними днями (с понедельника по пятницу) — «weekdays».
В результат включите две колонки: колонку с группами назовите week_part, а колонку со средним размером заказа — avg_order_size.
SELECT
case
when date_part('dow', creation_time) in (0, 6) then 'weekend'
else 'weekdays'
end as week_part,
round(avg(array_length(product_ids, 1)), 2) as avg_order_size
FROM orders
GROUP BY 1 ORDER BY 2
Мы сначала определяем каждую строку как weekend или как weekdays, а потом их группируем с помощью GROUP BY и подсчитываем средний размер заказа в каждой группе.

🔹 А теперь покажу, как похожая структура используется на рабочем примере. Есть заявки от клиентов с разными статусами. Нужно найти по каждому финальному статусу количество клиентов – скольким одобрено, скольким отказано, скольким требуется исправление в заявке и т.д.
Тут еще используется подзапрос. Он необходим, так как я подсчитываю кол-во уже базируясь на данных сформировавшихся после case.
select status, count(*) as count_account_id
from(
select account_id,
(case when MAX(status) = 1 then 'Новый'
when MAX(status) = 2 then 'В работе'
when MAX(status) = 3 then 'Требуется исправления'
when MAX(status) = 5 then 'Одобрено'
when MAX(status) = 6 then 'Отказано'
else MAX(status) end) as status
from sales.checkout_request
group by 1
) tt
group by 1 order by status desc
Я обозначила результат подзапроса как tt иначе код выдаст ошибку. Всегда нужно давать имя подзапросу, который находится внутри from.
  • ❤ 16
  • 👍 7
  • 👎 1
Older posts →
Threads Profile ViewerView any public Threads profile without an account.Open ThreadLook →Writing with AI? Make it sound human.Metric37 rewrites AI drafts so they read naturally. Free AI detector, 1,500 words free.Try Metric37 →